
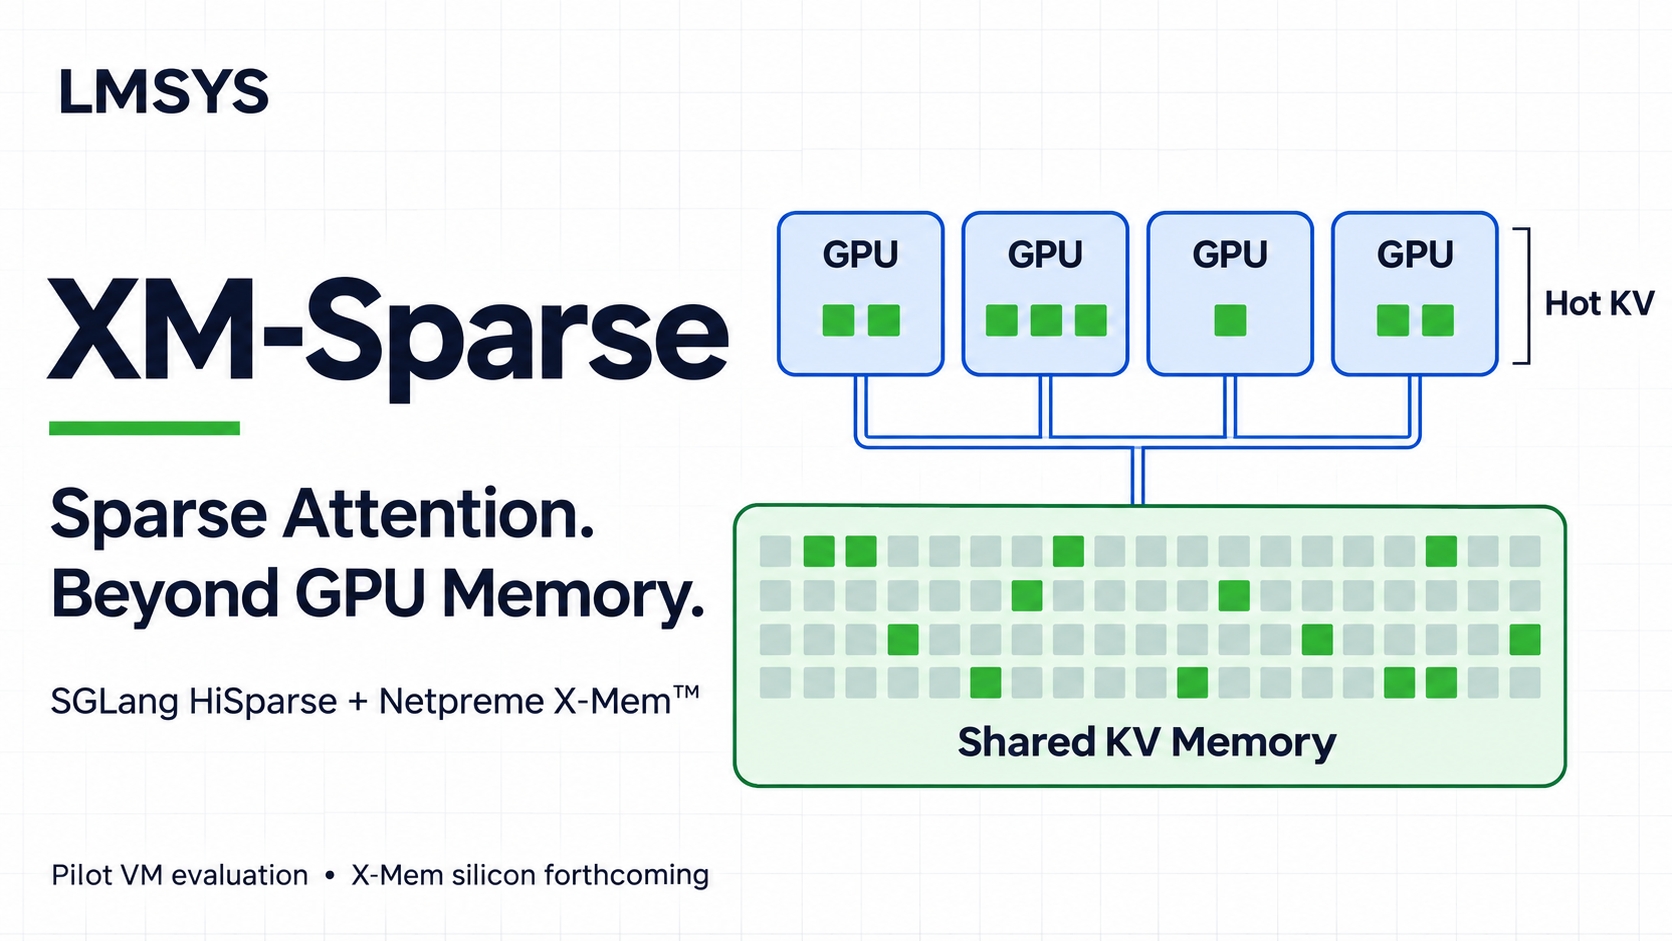
XM-SparseはNetpreme X-Mem™とSGLang HiSparseを深く統合している。高帯域幅による外部KVキャッシュへのアクセスがデコードレイテンシを低減するとともに、容量の増大によってより大きなバッチサイズと高い並列処理をサポートする。
TL;DR
- X-Mem™はSGLang HiSparseに高帯域幅と大容量の外部メモリをもたらし、より高速な外部KVアクセスを実現するとともに、ホストDRAMの制限を超えた大規模バッチをサポートする。
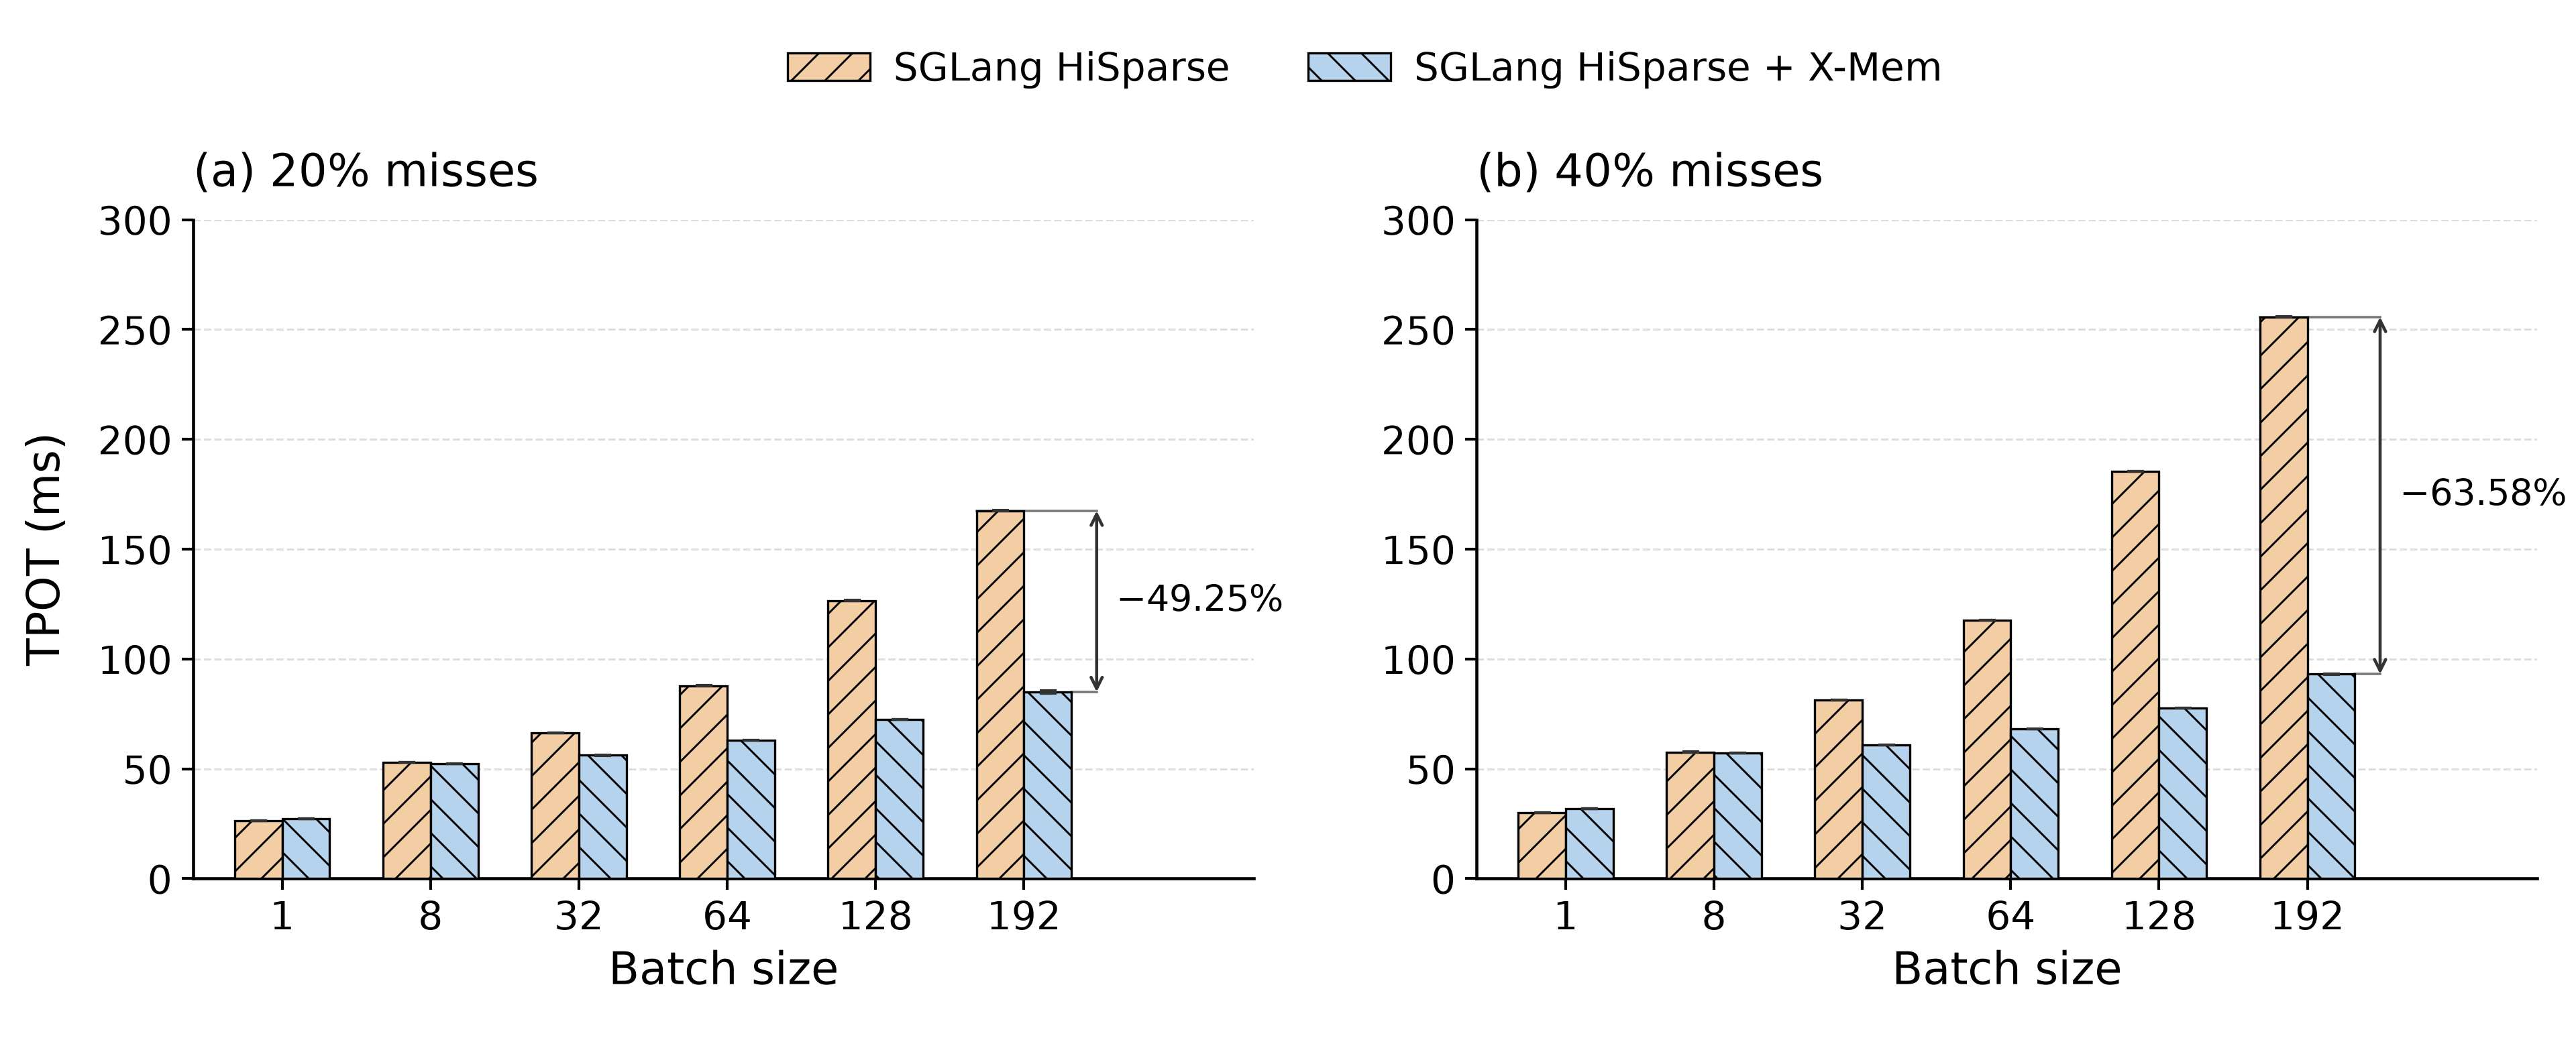
- 同一バッチサイズにおけるデコードの高速化:16Kコンテキスト、top-kミス率20%、GPU当たりバッチサイズ192の条件下で、X-Mem™はPCIeホストDRAM比で平均出力トークン生成時間(TPOT)を49.25%短縮。ミス率40%では63.58%短縮。
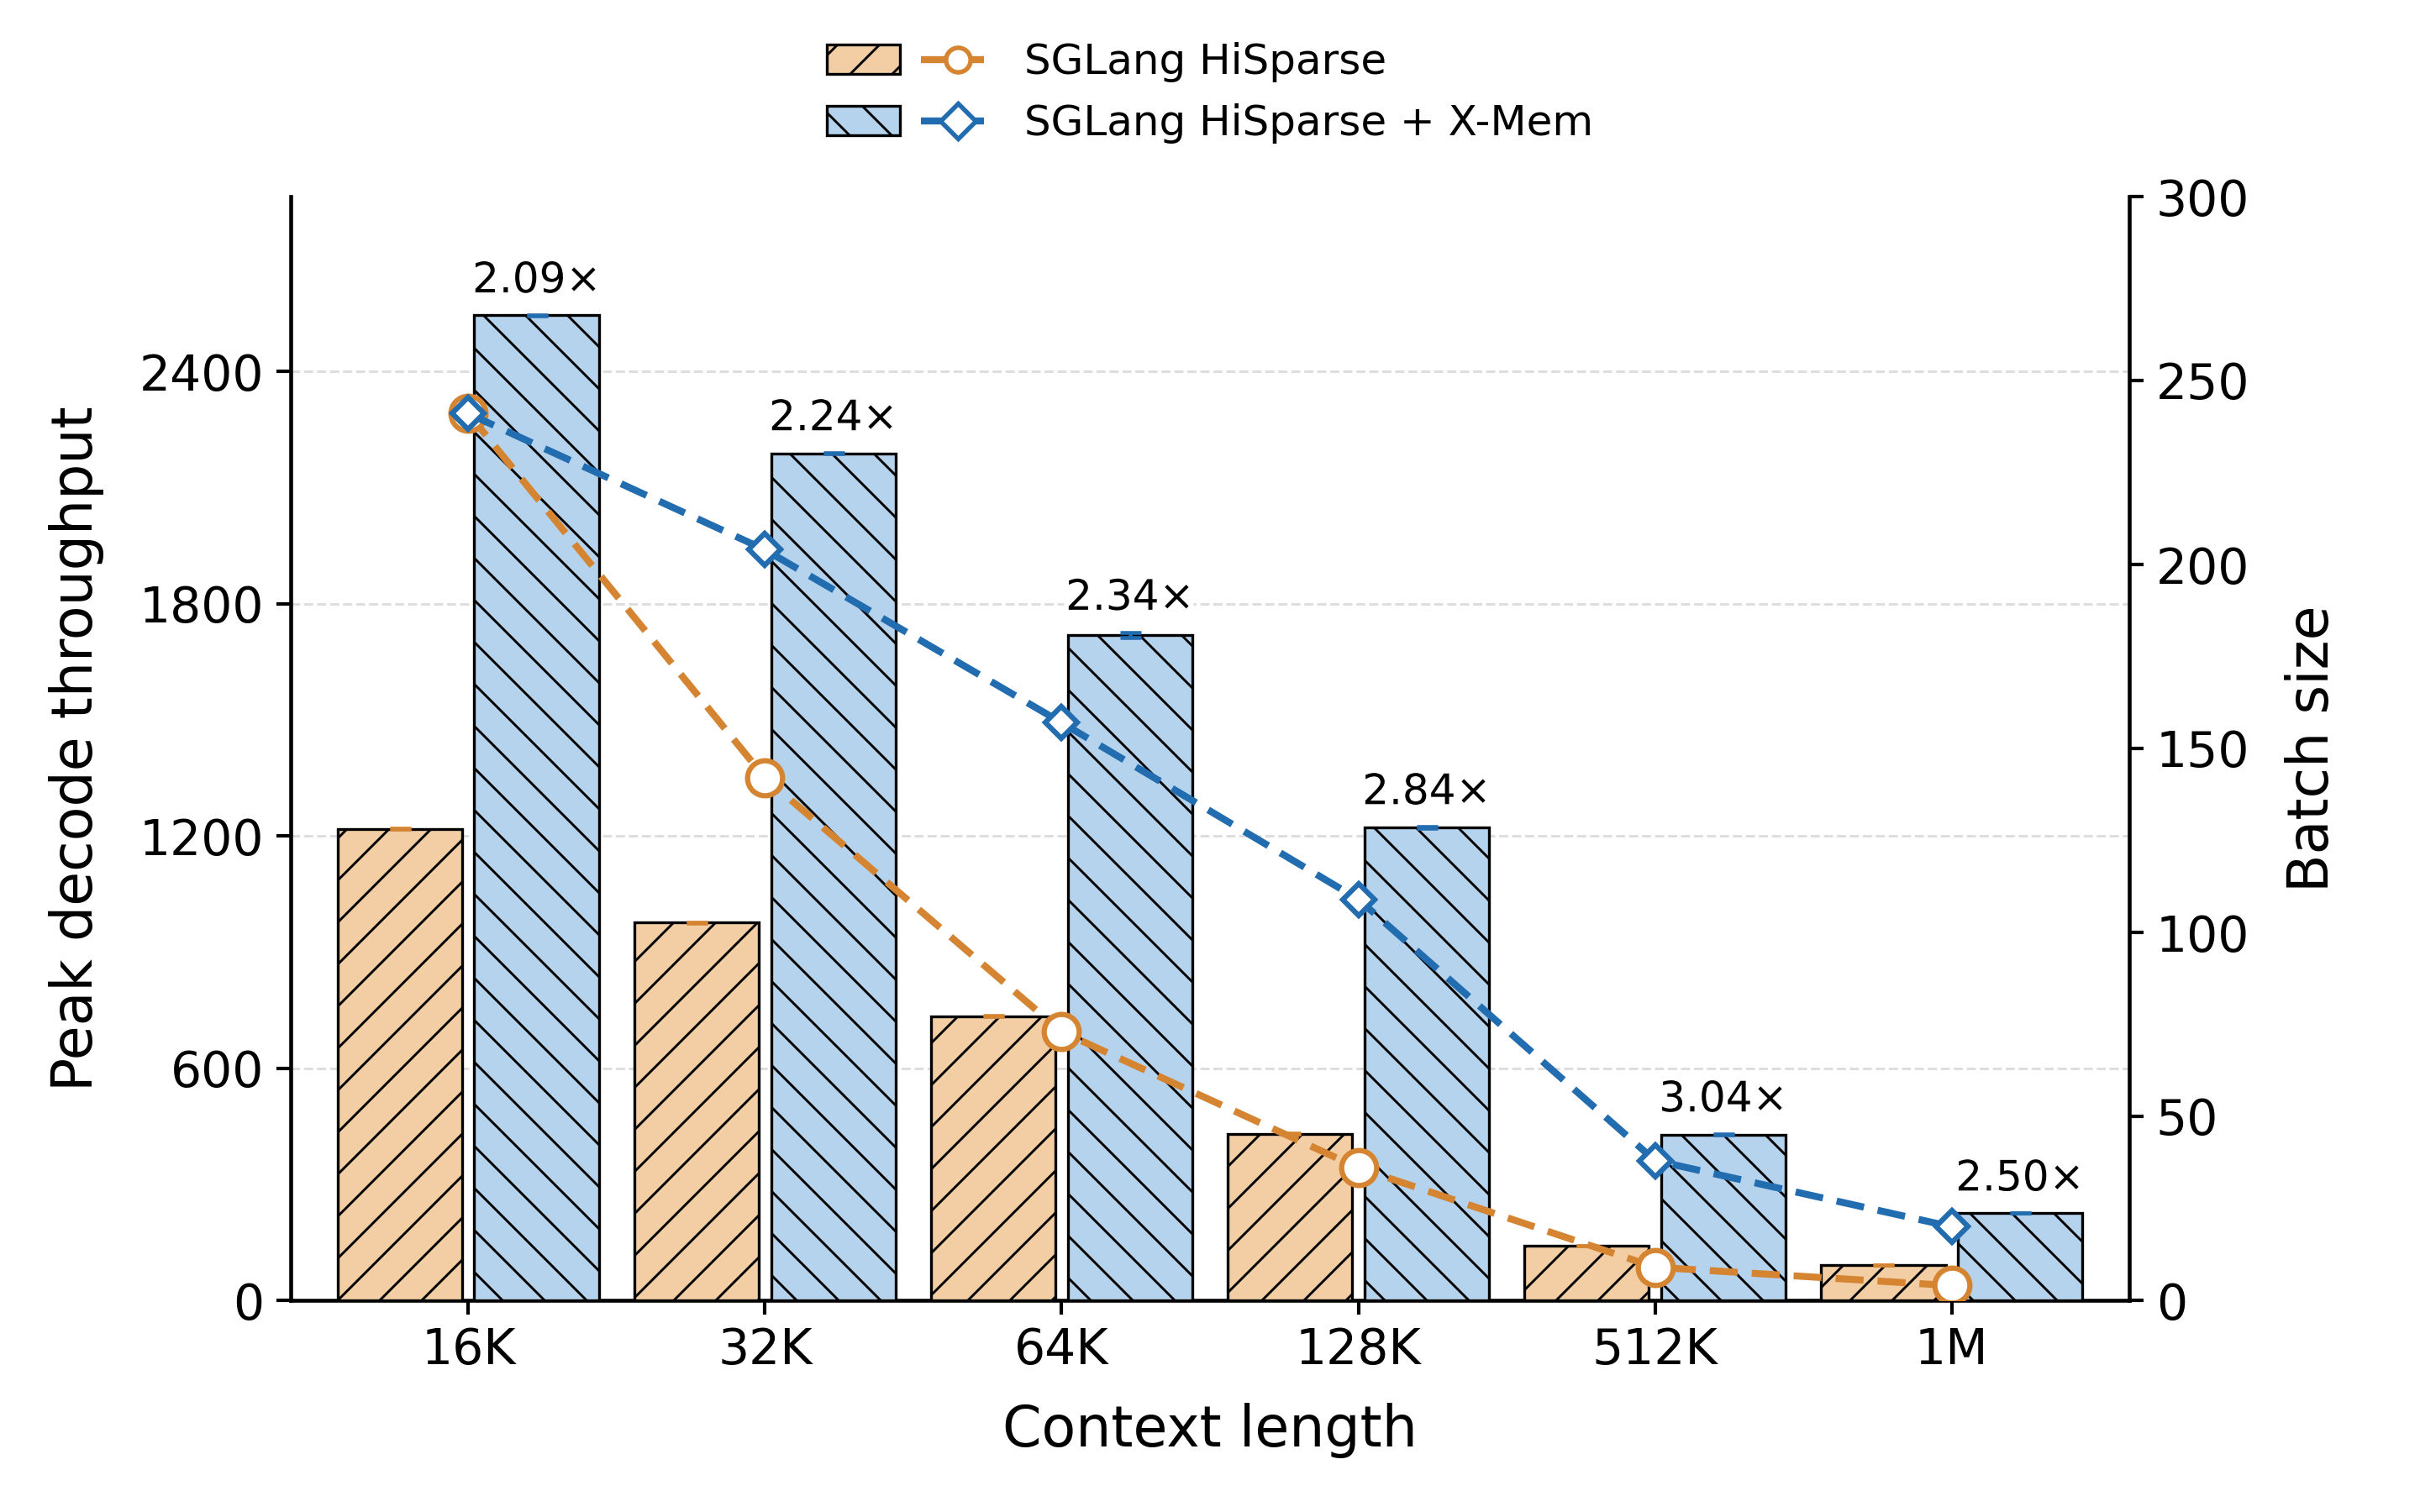
- コンテキスト長全域でのスループット向上:ミス率20%において、X-Mem™は16K〜1Mのコンテキスト全域でホストDRAMのピークデコードスループットの2.09〜3.04倍を達成。
以上の結果はX-Mem™ Pilot Virtual Machineで測定されたものであり、現在申請受付中。X-Mem™シリコンは近日リリース予定。
スパースアテンションに高速・大容量メモリ層が必要な理由
スパースアテンションはデコードごとに選択されたKVエントリのみにアクセスするが、選択が動的に変化するためKVキャッシュ全体を保持し続ける必要がある。SGLang HiSparseはホットKVバッファを使用して外部メモリへの読み取り回数を削減し、インデックスキーキャッシュをGPUのHBM上に保持する。
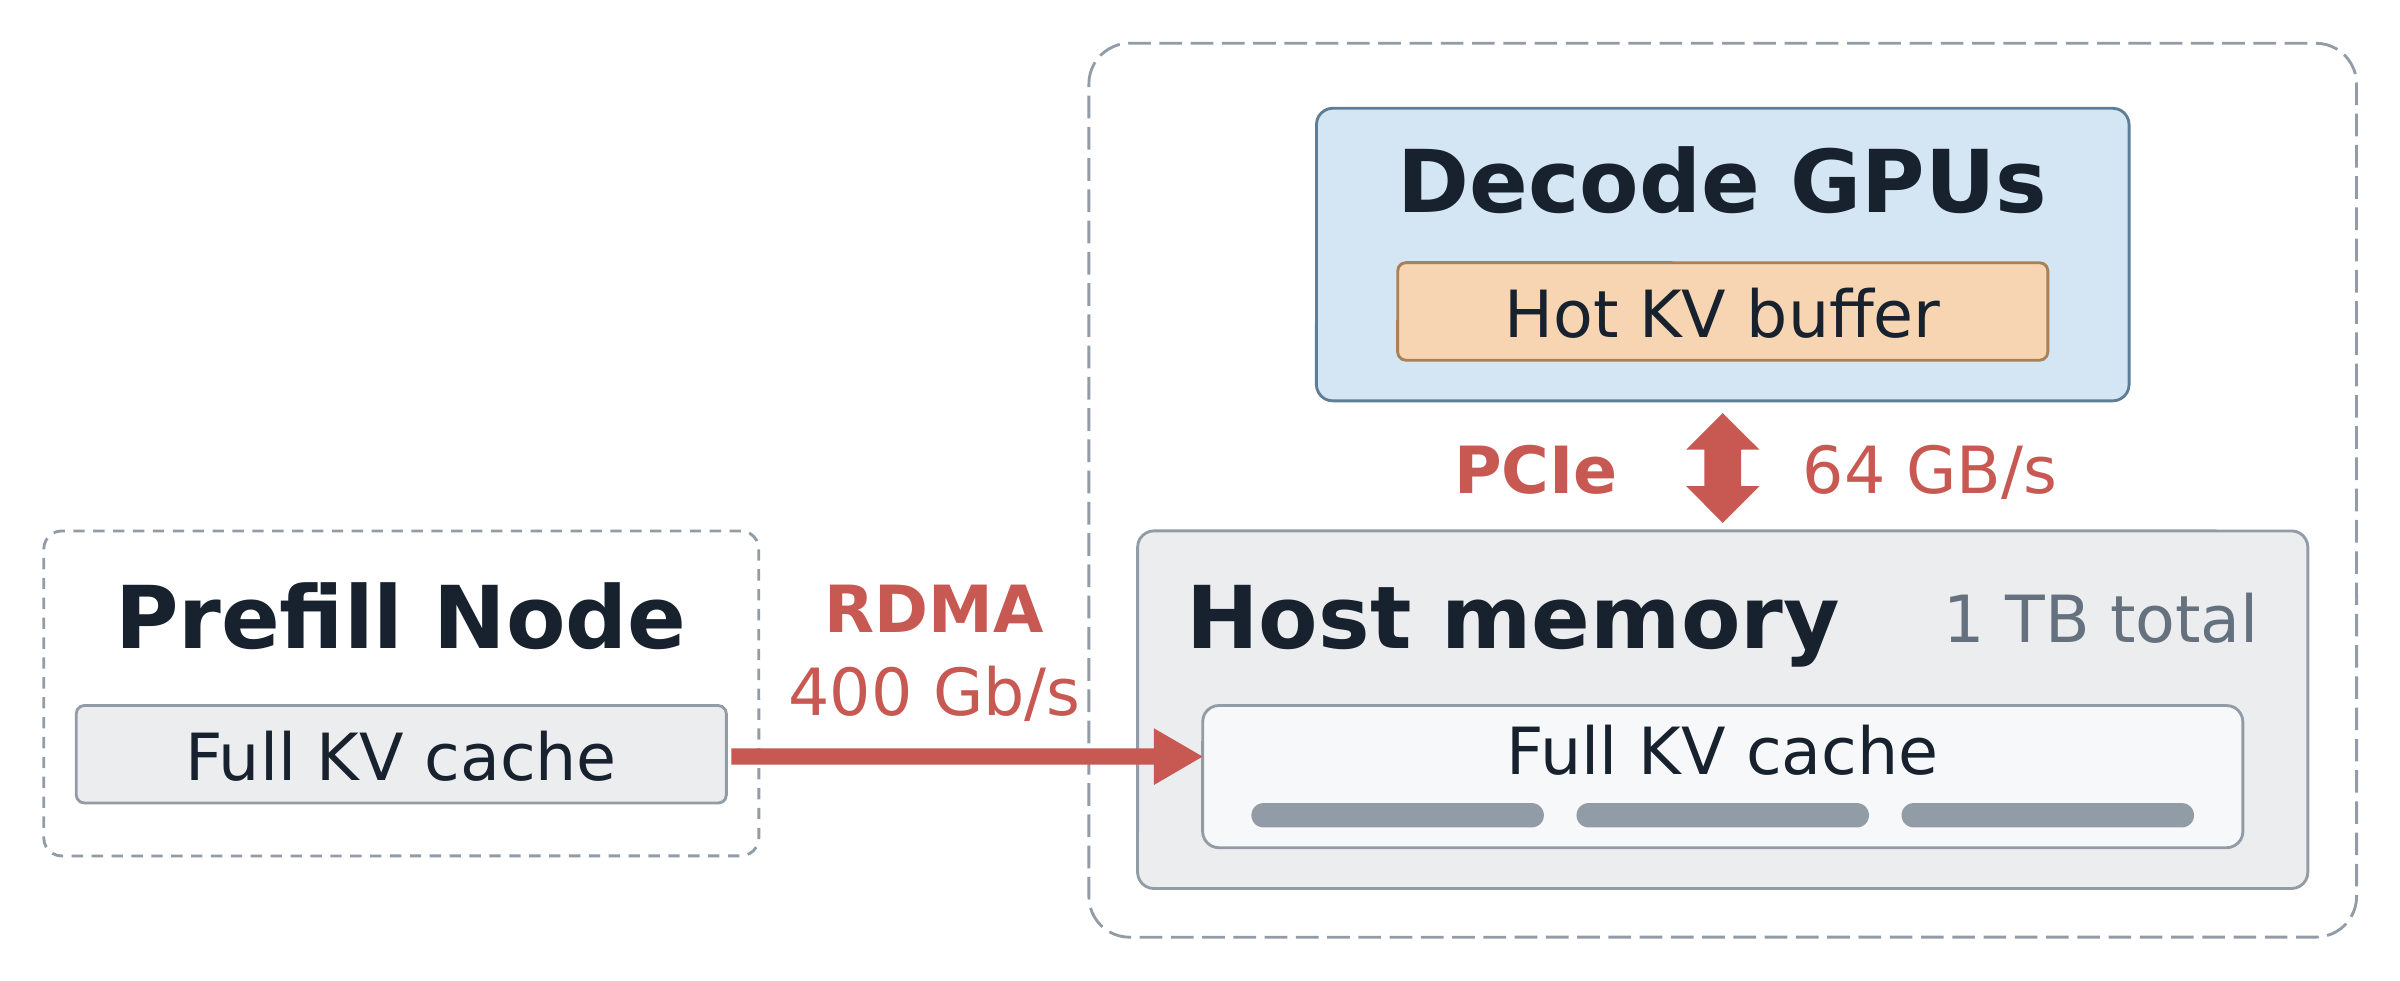
エージェント型ワークロードはスループットへの要求がより高い。コーディングエージェントは数百のセッションを維持し、各セッションのKV再利用率は最大95%に達する。デコードスループットは高並列処理時のサービス提供能力を直接左右する。
帯域幅と容量のボトルネックのモデル化
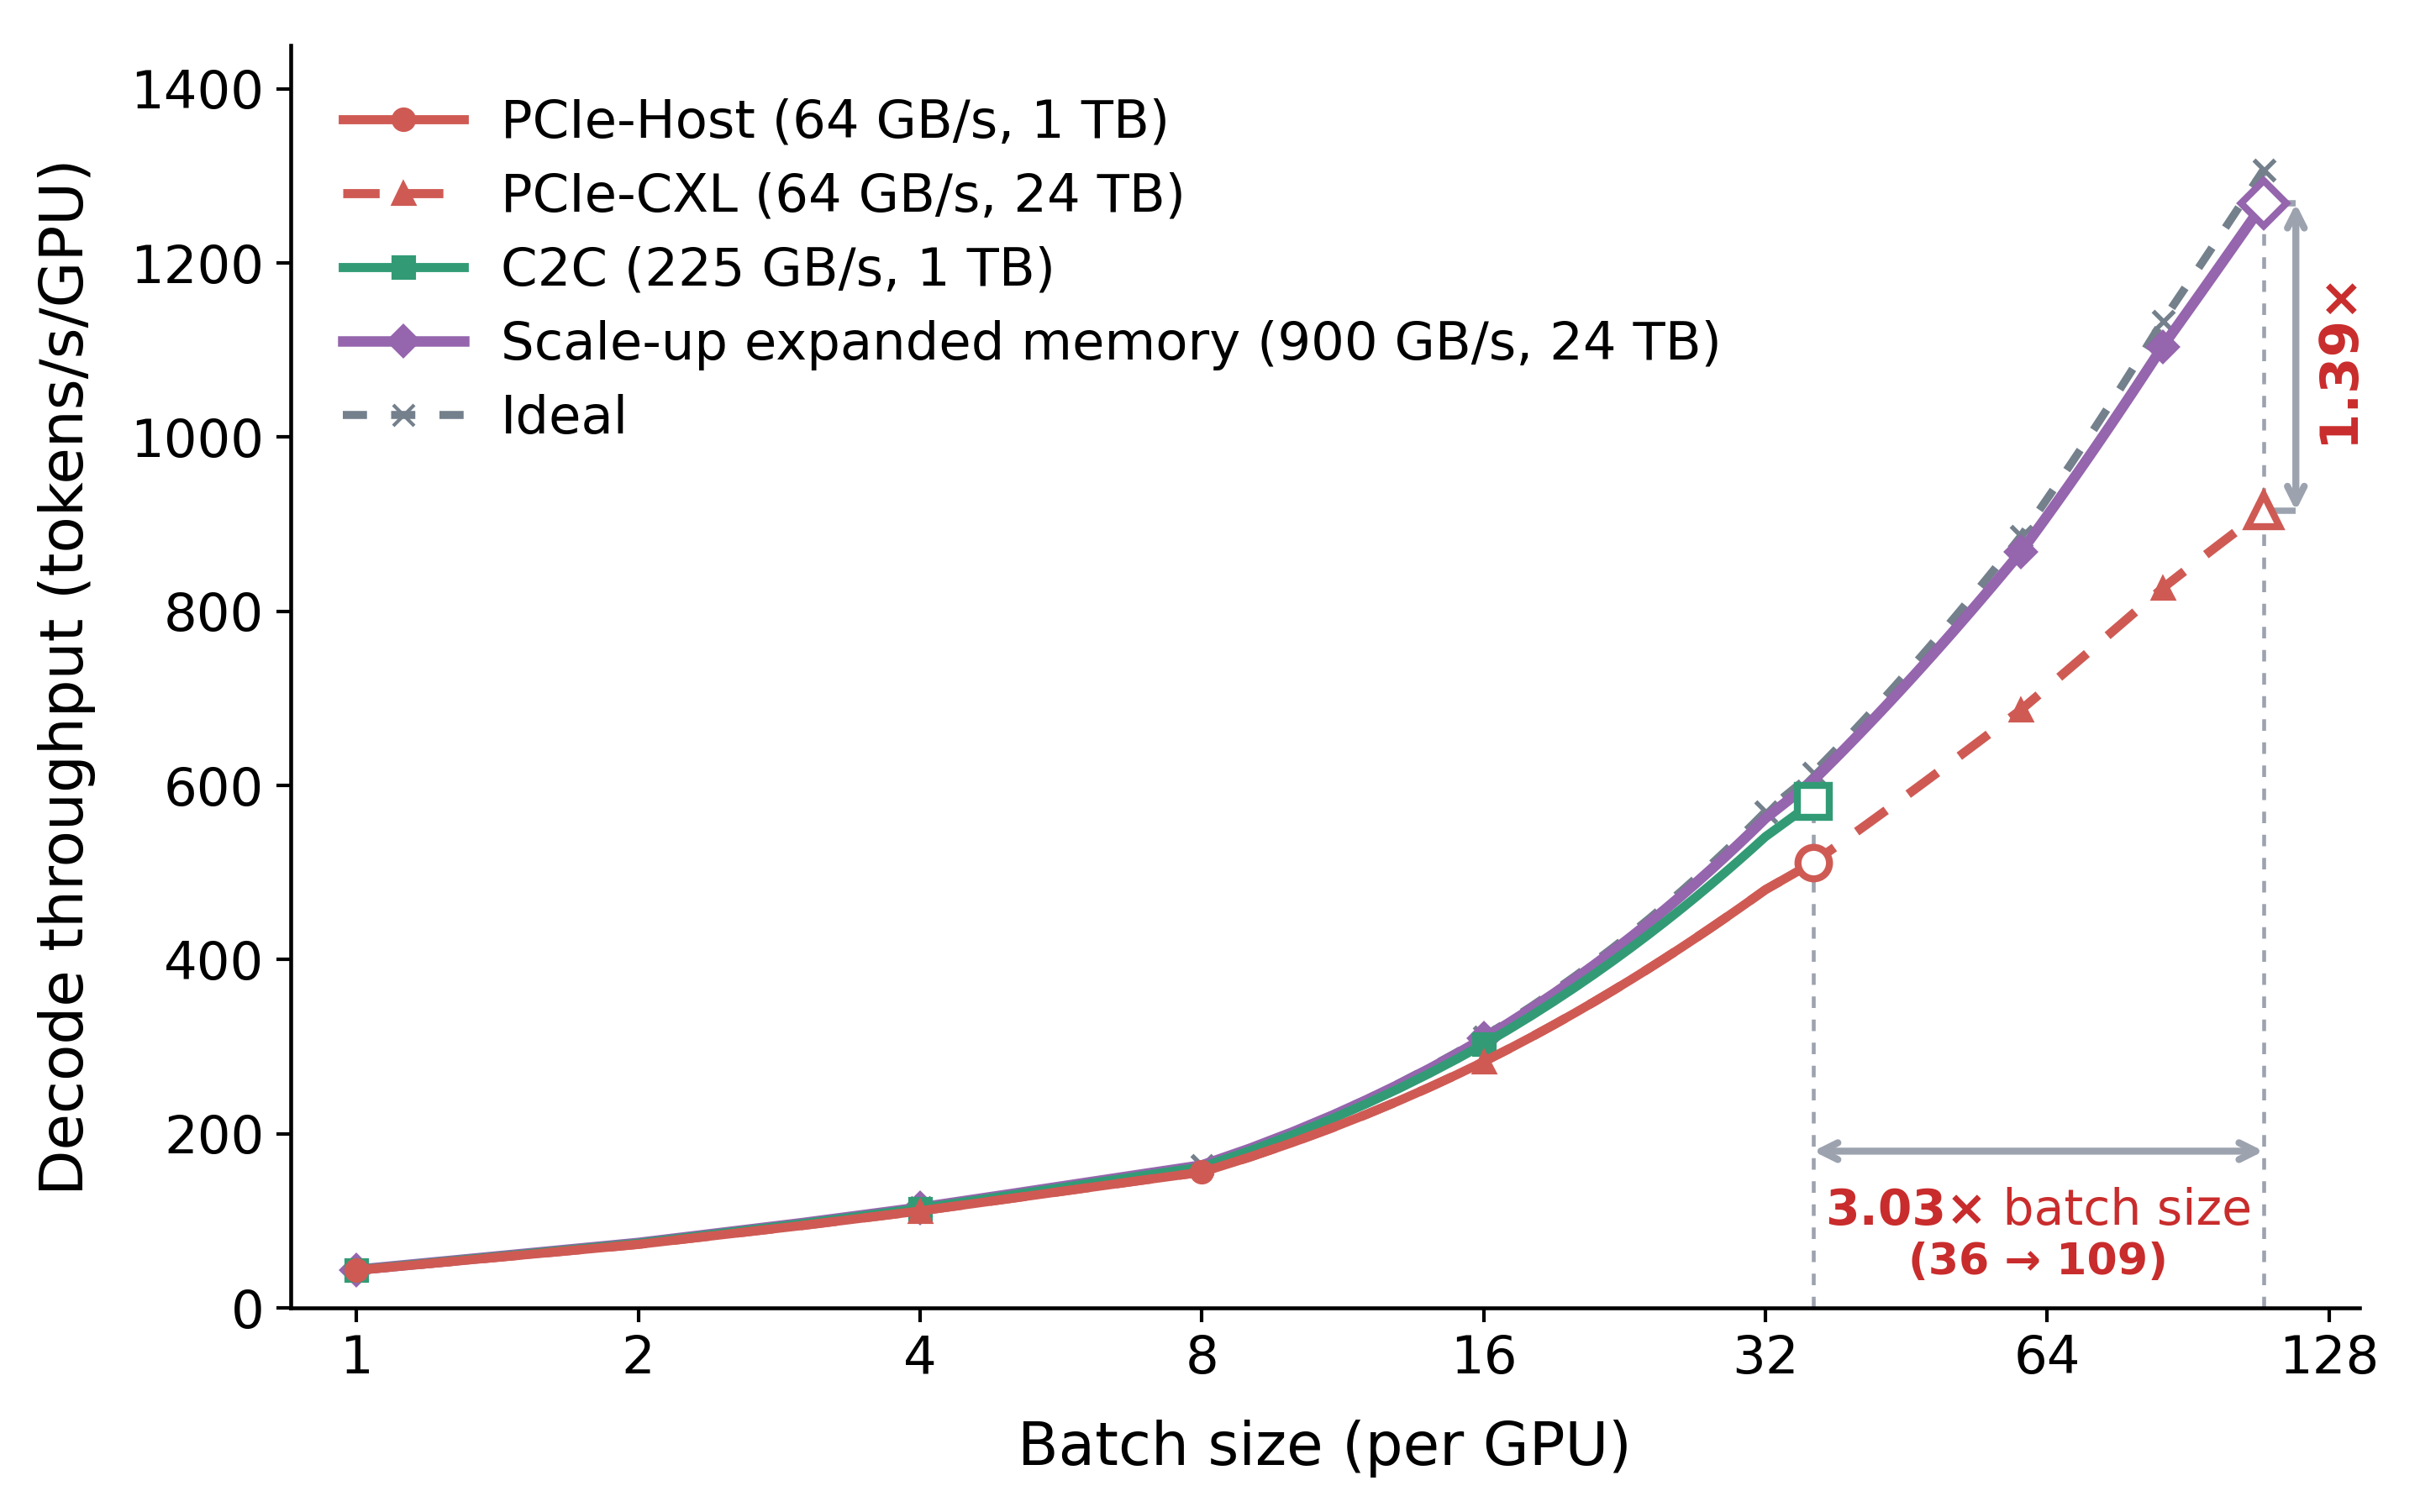
PCIe、CXL、NVLink-C2C、およびスケールアップ型拡張メモリという4種類の外部メモリ構成について、デコードスループットをモデル化して比較した。128Kコンテキストでは、容量と帯域幅の両方がボトルネックとなる。24TBの容量と900 GB/sの帯域幅を組み合わせることで、性能を大幅に向上できる。
短コンテキストと長コンテキストの比較
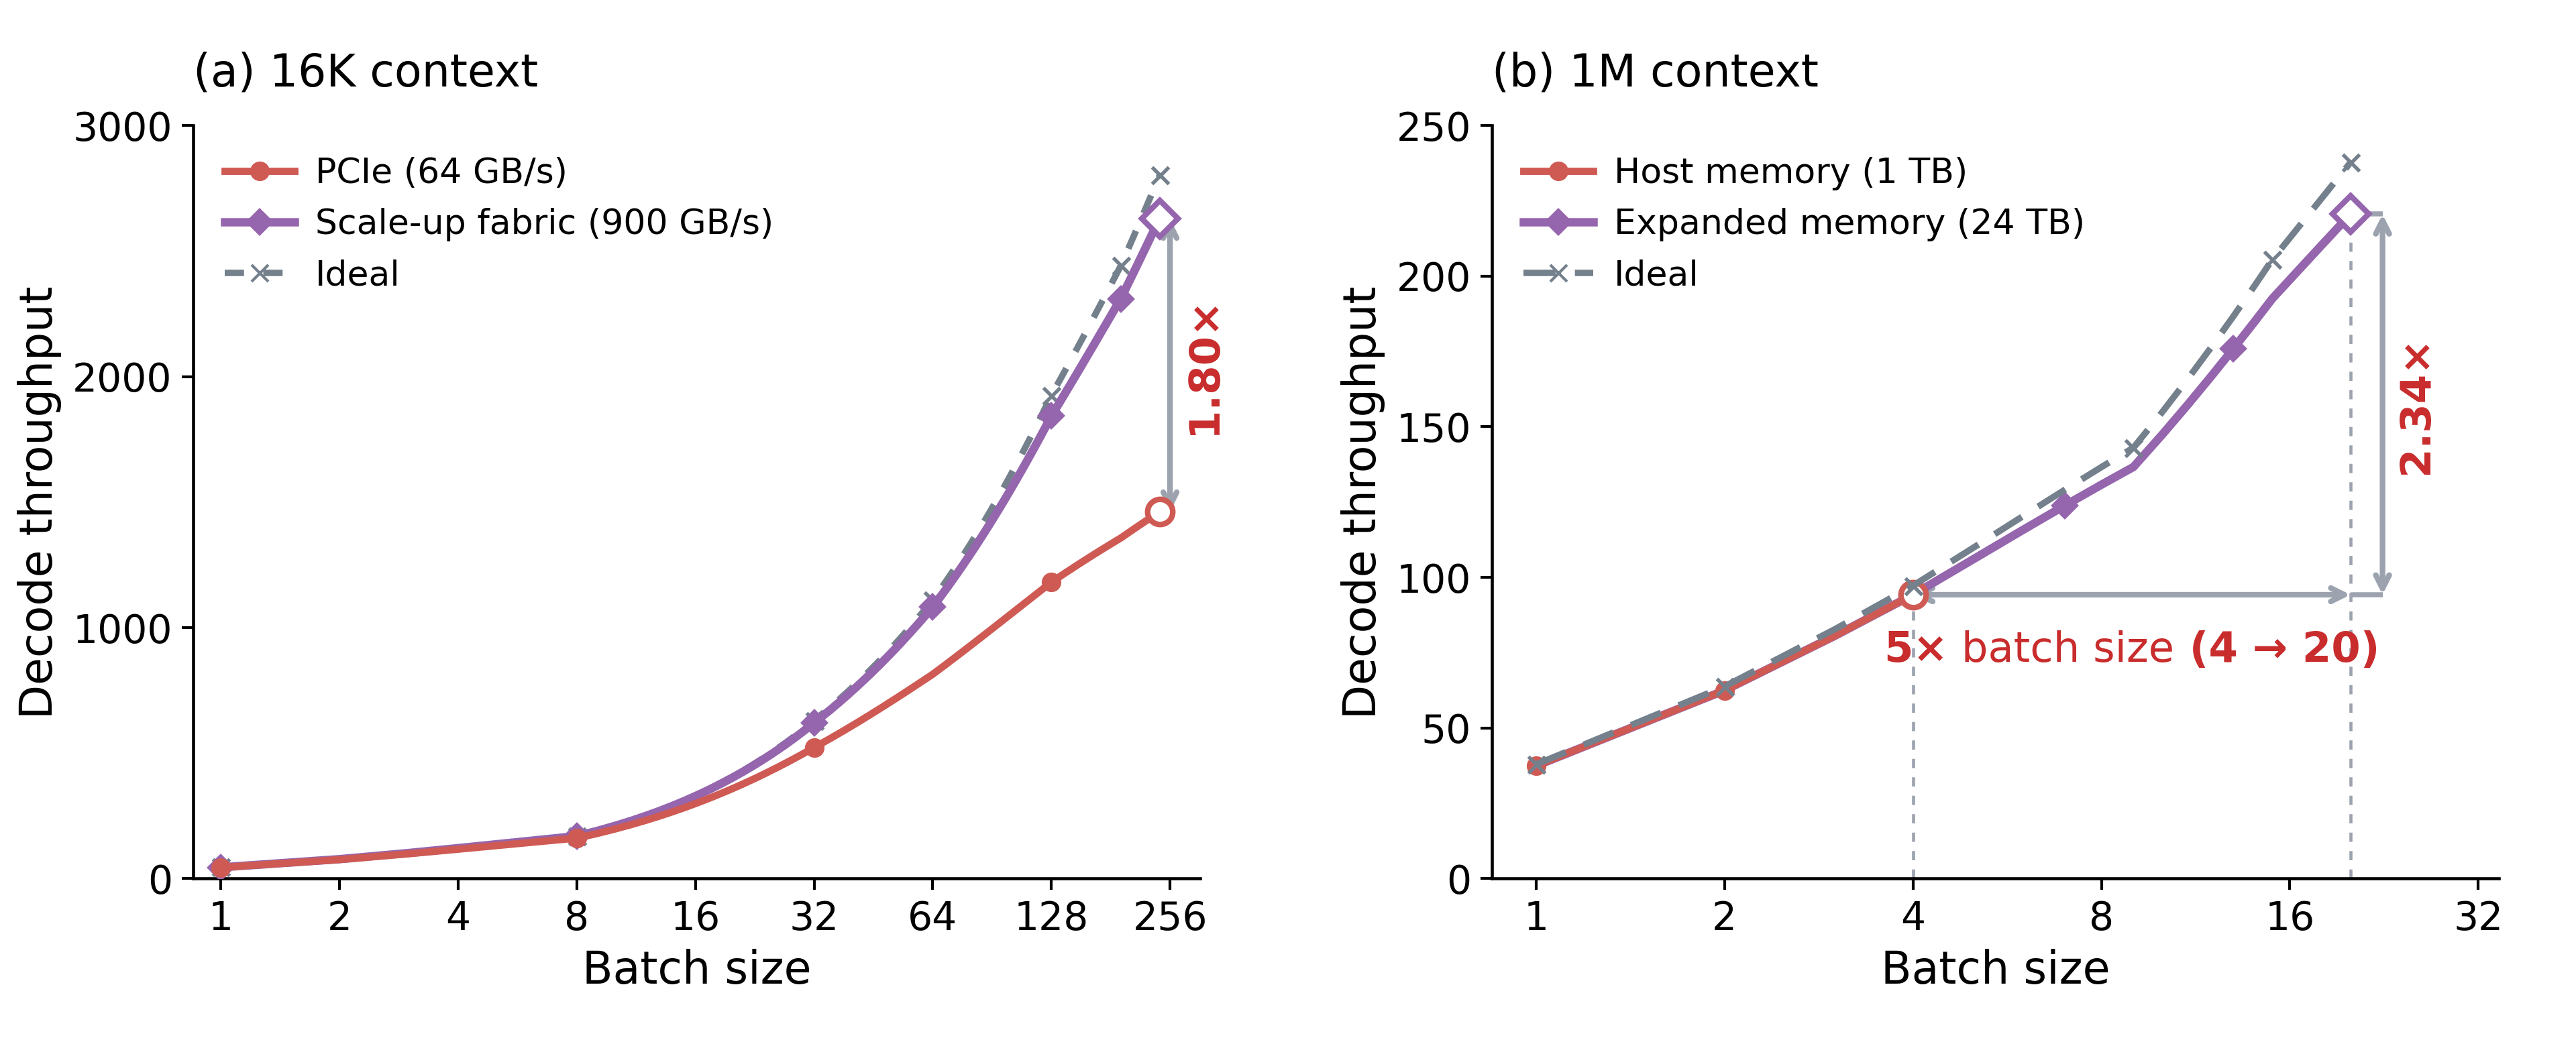
16Kと1Mのコンテキストはそれぞれ帯域幅制約と容量制約を顕著に示す。16Kでは帯域幅が主なボトルネックとなり、900 GB/sで1.80倍の性能向上をもたらす。1Mでは容量が制限要因となり、24TB構成によってバッチサイズを4から20に拡大できる。
Netpreme X-Mem™:SGLang HiSparseのための高帯域幅・大容量メモリ層
X-Mem™ MPUは高帯域幅ファブリックを通じて、スケールアップドメイン内でGPUに数十TBのメモリを拡張提供する。単一ノードは4基のMPUをサポートし、24TB DDR5と約4TB/sの総合帯域幅を提供する。
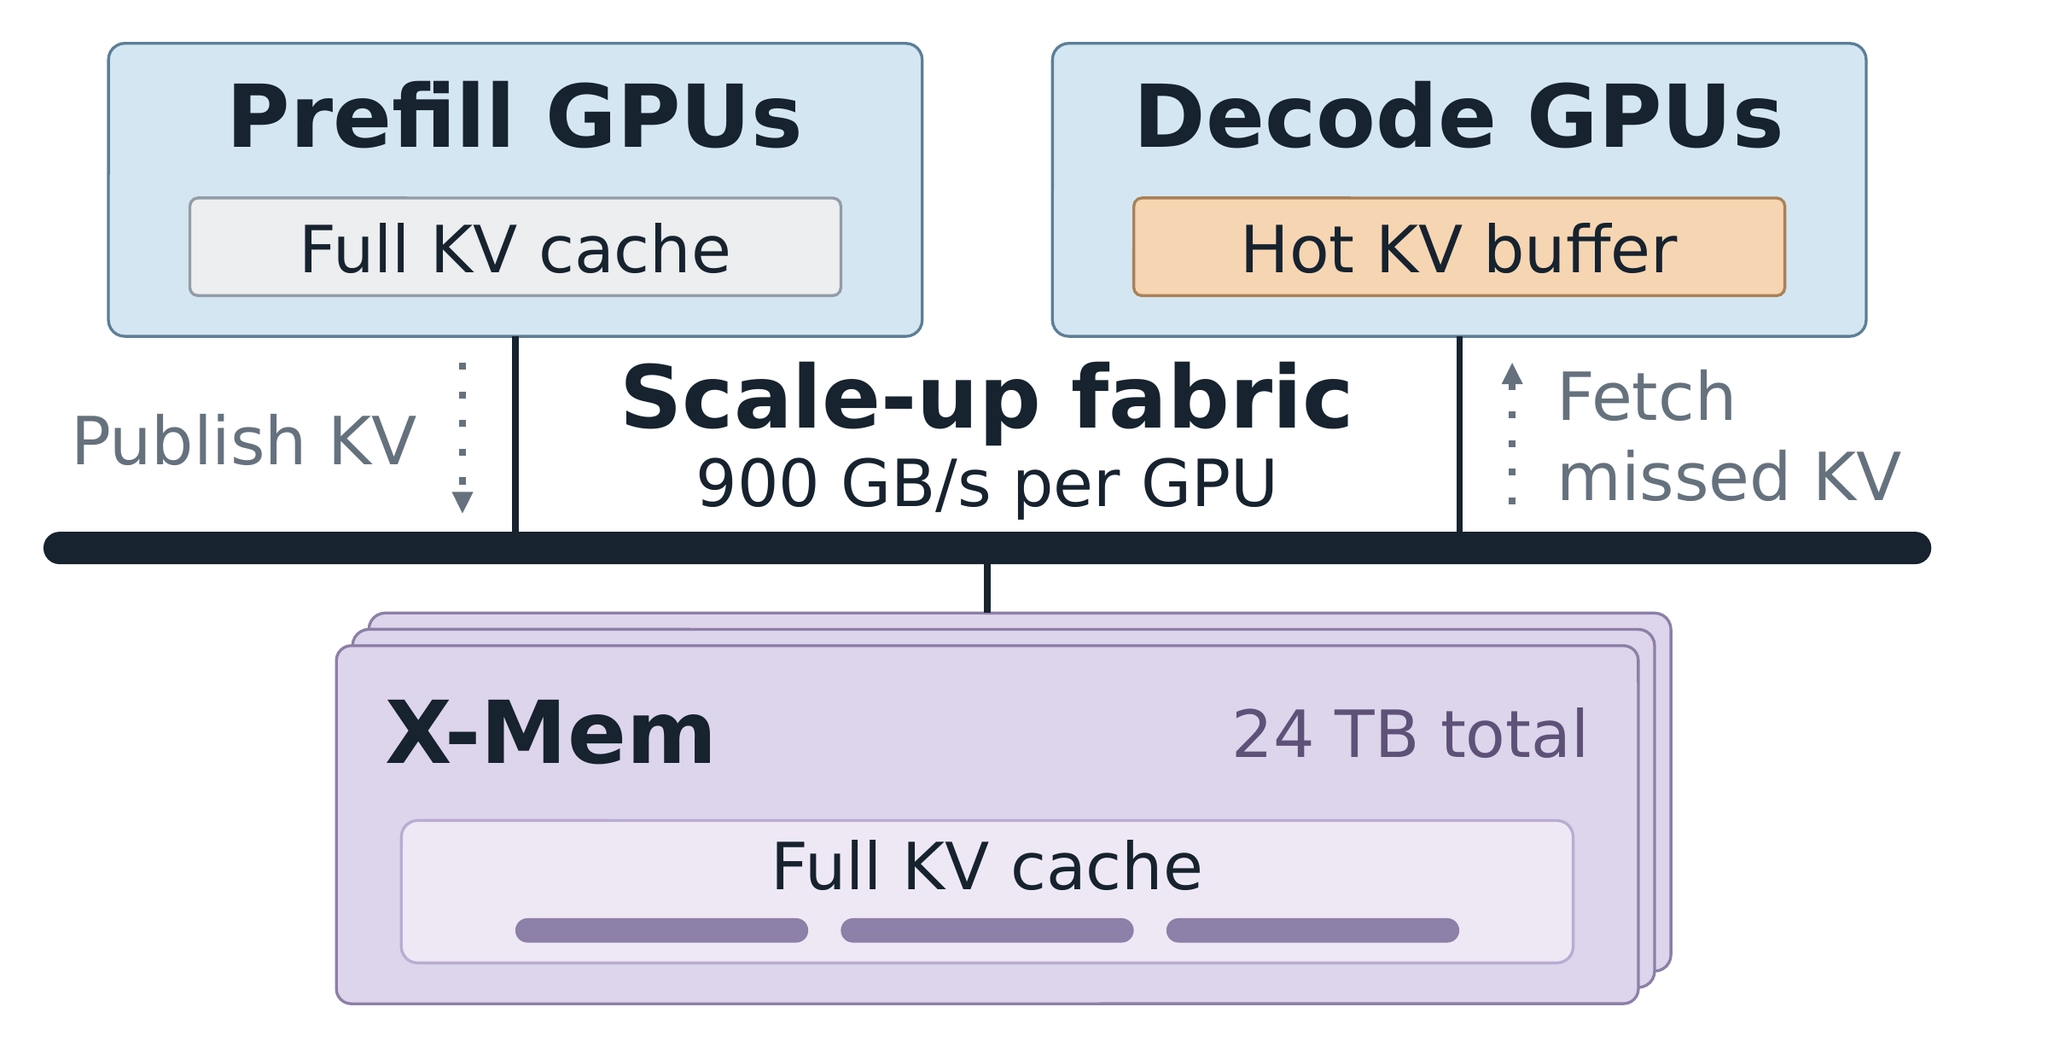
SGLang HiSparseとの統合
XM-SparseはHiSparseのスパース選択、キャッシュ管理、プリフェッチ機構を維持しつつ、CUDA Graphをサポートする。KV管理はリクエストのライフサイクルに従い、発行・取得・ライトバック・解放の各フェーズを経る。
XM-Sparseのテスト環境とデコード性能
4基のNVIDIA B300デコードGPU上でGLM-5.3をテストした。X-Mem™はミス率20%においてTPOTを大幅に低減し、ピークスループットをホストDRAMの2倍以上に引き上げた。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接