
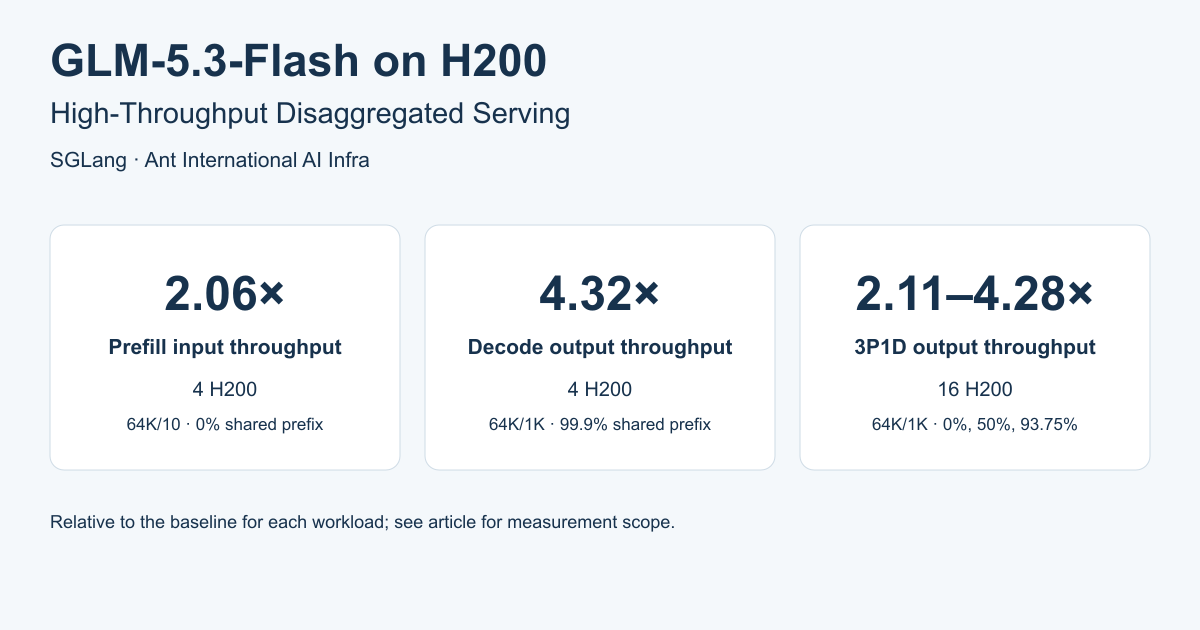
GLM-5.3-Flashは、スパースアテンション・循環線形アテンション・MoEアーキテクチャを組み合わせたモデルである。長コンテキストシナリオでの効率的なサービス提供には、高並行時のメモリ確保・低い出力トークンコスト・十分なprefillスループットが求められる。Ant International AI InfraチームはSGLangを活用し、H200上で混合キャッシュ再利用・高速投機的実行・カーネルチューニング・FP8通信を導入することで、顕著な成果を達成した。
1. アーキテクチャとワークロード
本モデルは2種類のアテンション状態表現を持つ。スパースアテンションは過去のKVを保存し、線形アテンションは循環状態を維持する。PD分離により、それぞれに対して並列度とバックエンドを個別に設定でき、4枚のH200インスタンス間でNIXLを通じてキャッシュを転送する。
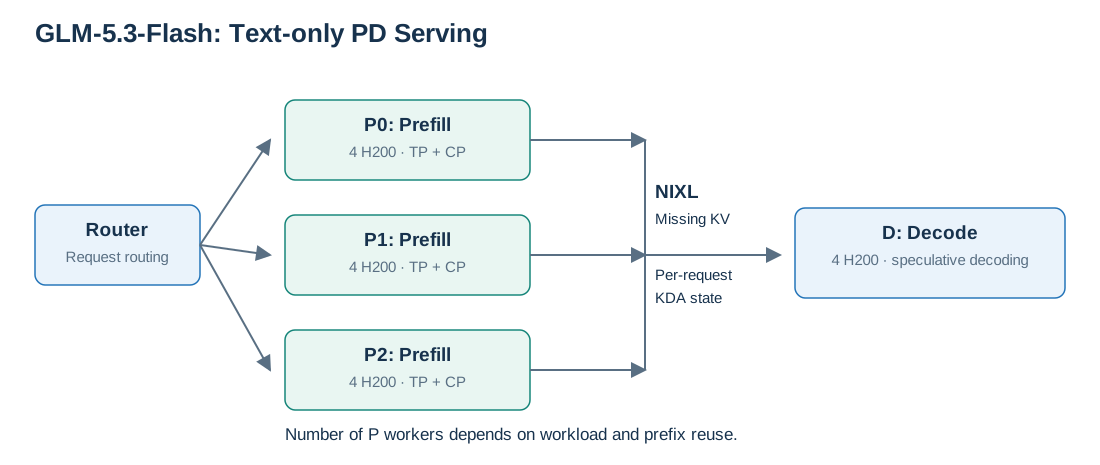
テストでは、64K入力/10トークン出力・共有プレフィックスなしの条件でprefillを計測し、64K/1K・99.9%共有プレフィックスの条件でdecodeキャパシティを計測した。
2. キャッシュ容量を並行処理能力へ転換
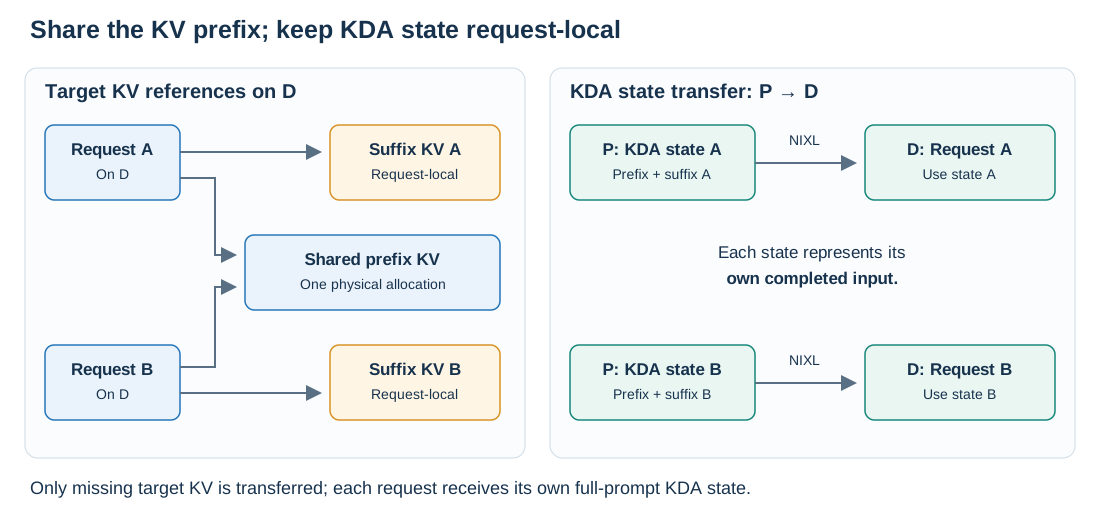
FP8 KVとBF16循環状態を組み合わせてプールサイズを再均衡化し、ReplaySSMにより投機的状態を管理する。KV専用のRadixCacheによってリクエスト間でプレフィックスKVを共有しつつ、各リクエストに対して独立した循環状態を保持する。
3. 有効出力コストの削減
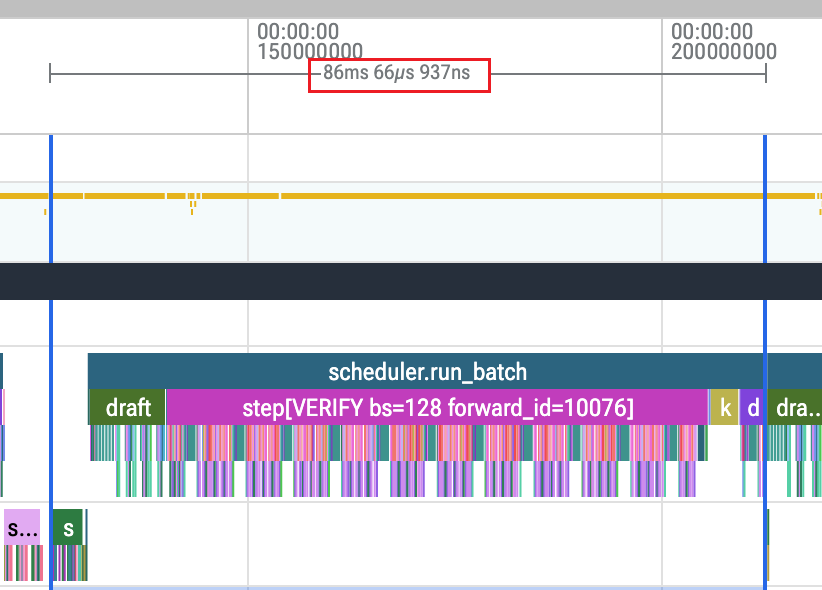
MTP718とDFlash2 block8を比較すると、後者は1回のフォワードパスでブロックを生成するため、サイクルタイムが86.94msから74.14msに短縮され、出力スループットが8.4%向上した。
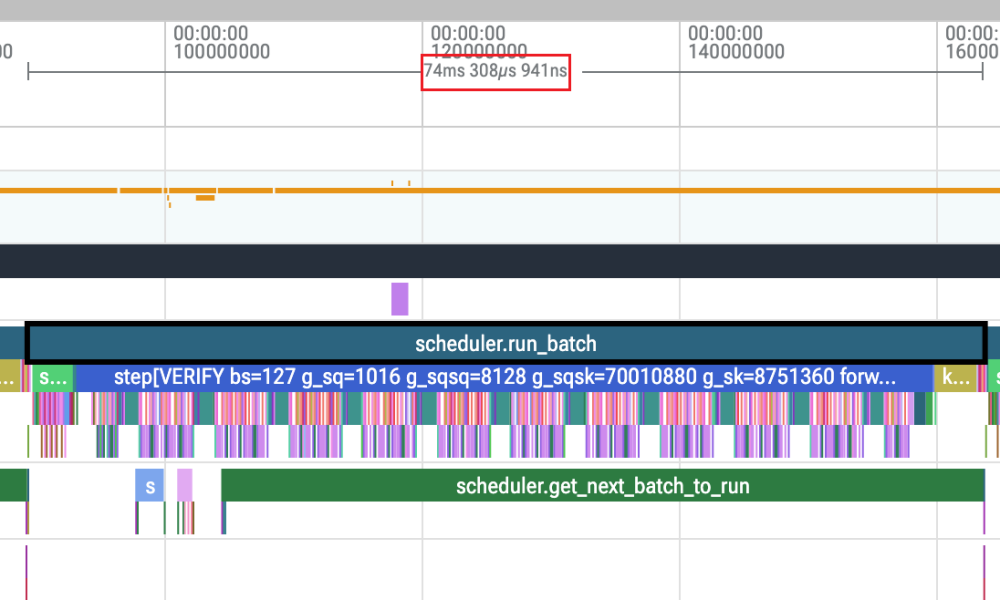
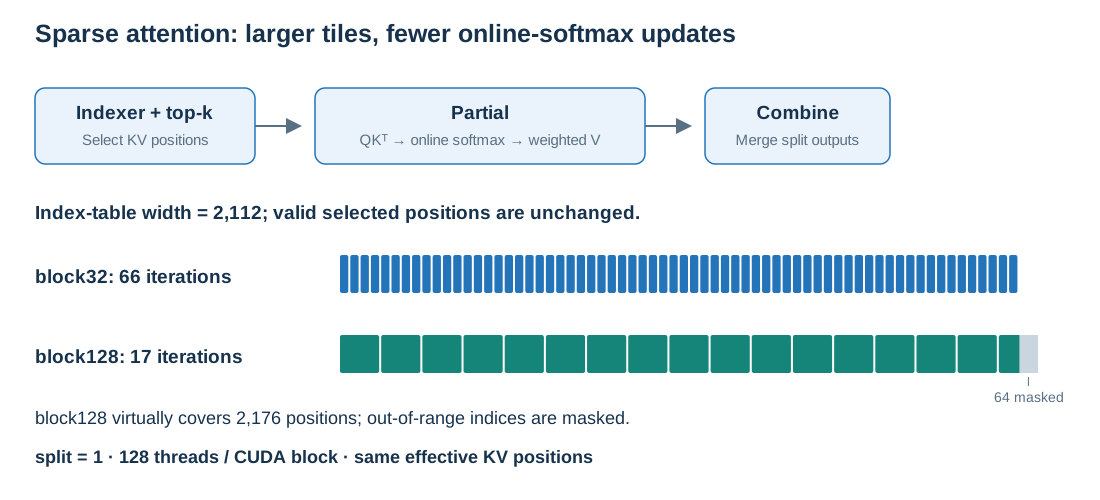
実際のルーティングに合わせてMoE GEMMをチューニングし、M1024構成でスループットをさらに3.12%改善した。DSA Partialではより大きなKVタイル(128)を採用することで反復回数を削減した。
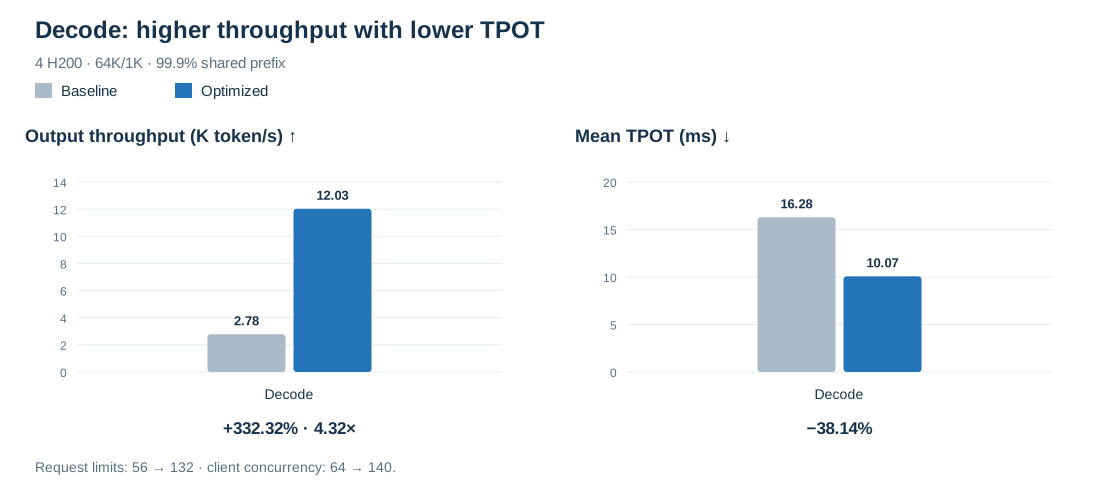
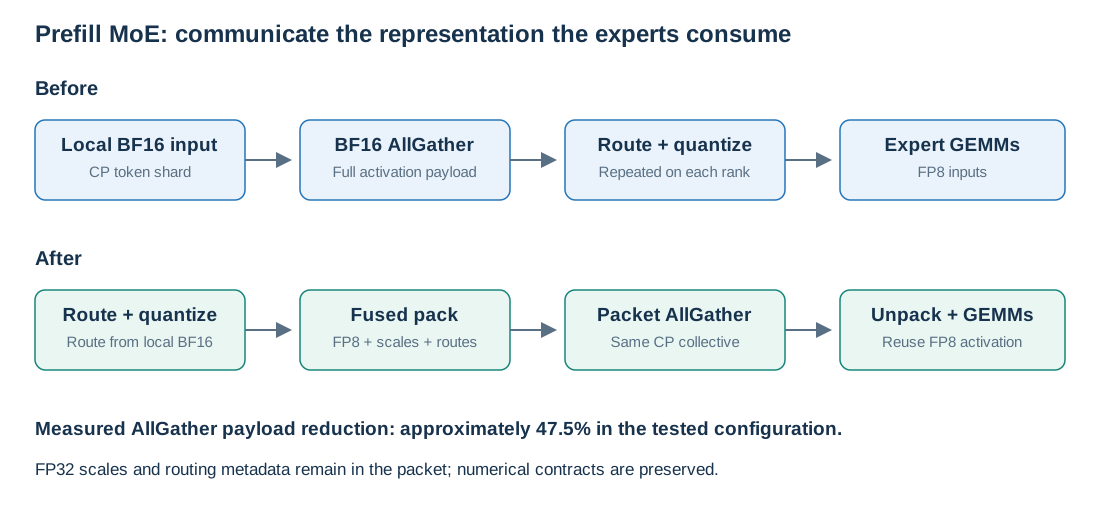
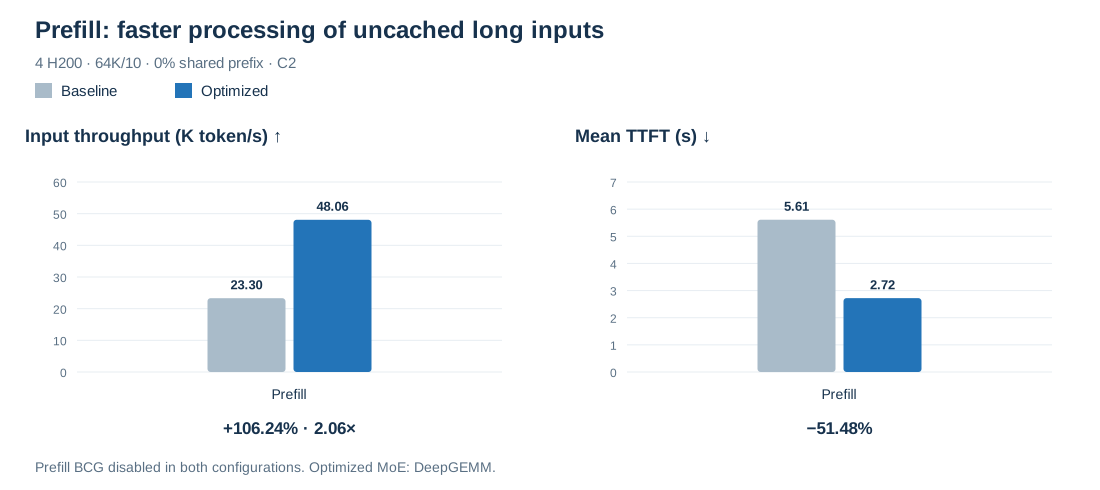
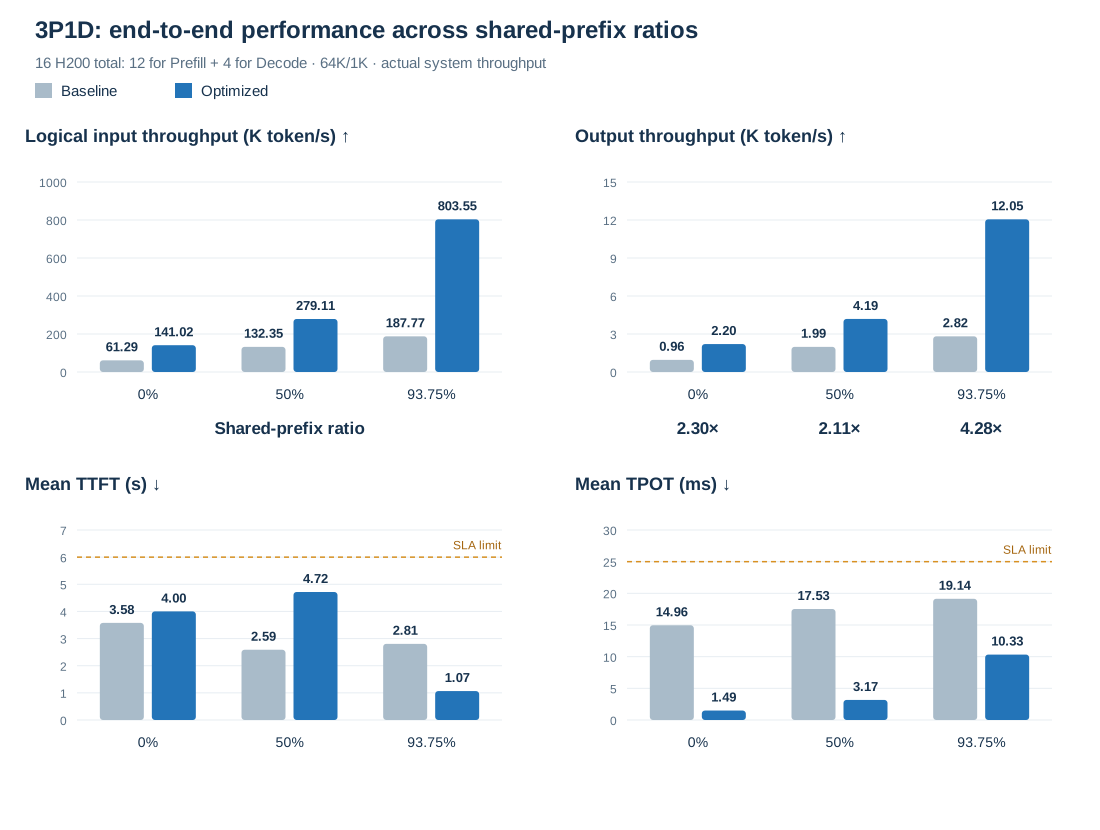
最終的に4枚のH200上で、prefill入力スループット48,064トークン/秒、decode出力スループット12,027トークン/秒を達成し、3P1Dエンドツーエンドのスループットが大幅に向上した。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接