
AMDとMilesチームは、ソフトウェアエンジニアリングエージェント向けの強化学習訓練手法を示した。AMD Instinct MI355X上で、Miles、SGLang、Megatron-LM、Harborを組み合わせ、Qwen3-30B-A3B-Instructに対して全非同期のagentic RL訓練を行う。最終的に、SWE-bench Verifiedの100問階層化サブセットで、モデルのpass@1はベースモデルの7.3%から27.5%へ向上し、ほぼ4倍になった。
この取り組みで最も核心的な知見は、単に「GPUを積み増す」ことではなく、エージェント訓練に特有のシステムボトルネックをどう処理するかにある。すなわち、長尾trajectory、CPU sandbox、KV cacheの爆発、そして訓練と推論の間のデータ移動である。チームは、これらの知見はDeepSeek-V4-Flash、GLM-5.3、Kimi K3のような、より大きなモデルにも同様に適用できると考えている。
主要な結果
- SWE-bench Verifiedサブセットのpass@1:7.3% → 27.5%。評価には100個の階層化サンプリングタスクを用い、各タスクで4回試行した。モデルにはSFTとagentic RLを適用した。
- rolloutスループットは約4倍向上:約860 → 3,480 trajectories/hour。モデルとRLレシピを変えずに、推論側を1個の8-GPU MI355Xノードから3個のノードへ拡張し、クラウドsandboxと並行修復を導入した。
- RL stepは約3倍高速化:850秒 → 284秒。同一の8-GPU推論ノード上で、trajectory長を制限することにより長尾を大幅に圧縮した。
- 最大規模の実行では、384個の同時agent sandboxに達した。この実験では3個の推論ノードと1個の訓練ノードを使用し、各ノードには8基のMI355Xを搭載した。
なぜcoding agentic RLはより難しいのか
ソフトウェアエンジニアリングの場面では、1つの訓練サンプルは単発のQ&Aではなく、複数ターンからなるepisode全体である。モデルはGitHub issueを読み、sandbox内で20本から100本超のshellコマンドを実行し、コードを修正し、最後にリポジトリのテストに合格した場合にのみ報酬を得る。これは、訓練サンプルの長さ、所要時間、リソース消費が極めて不均一であることを意味する。
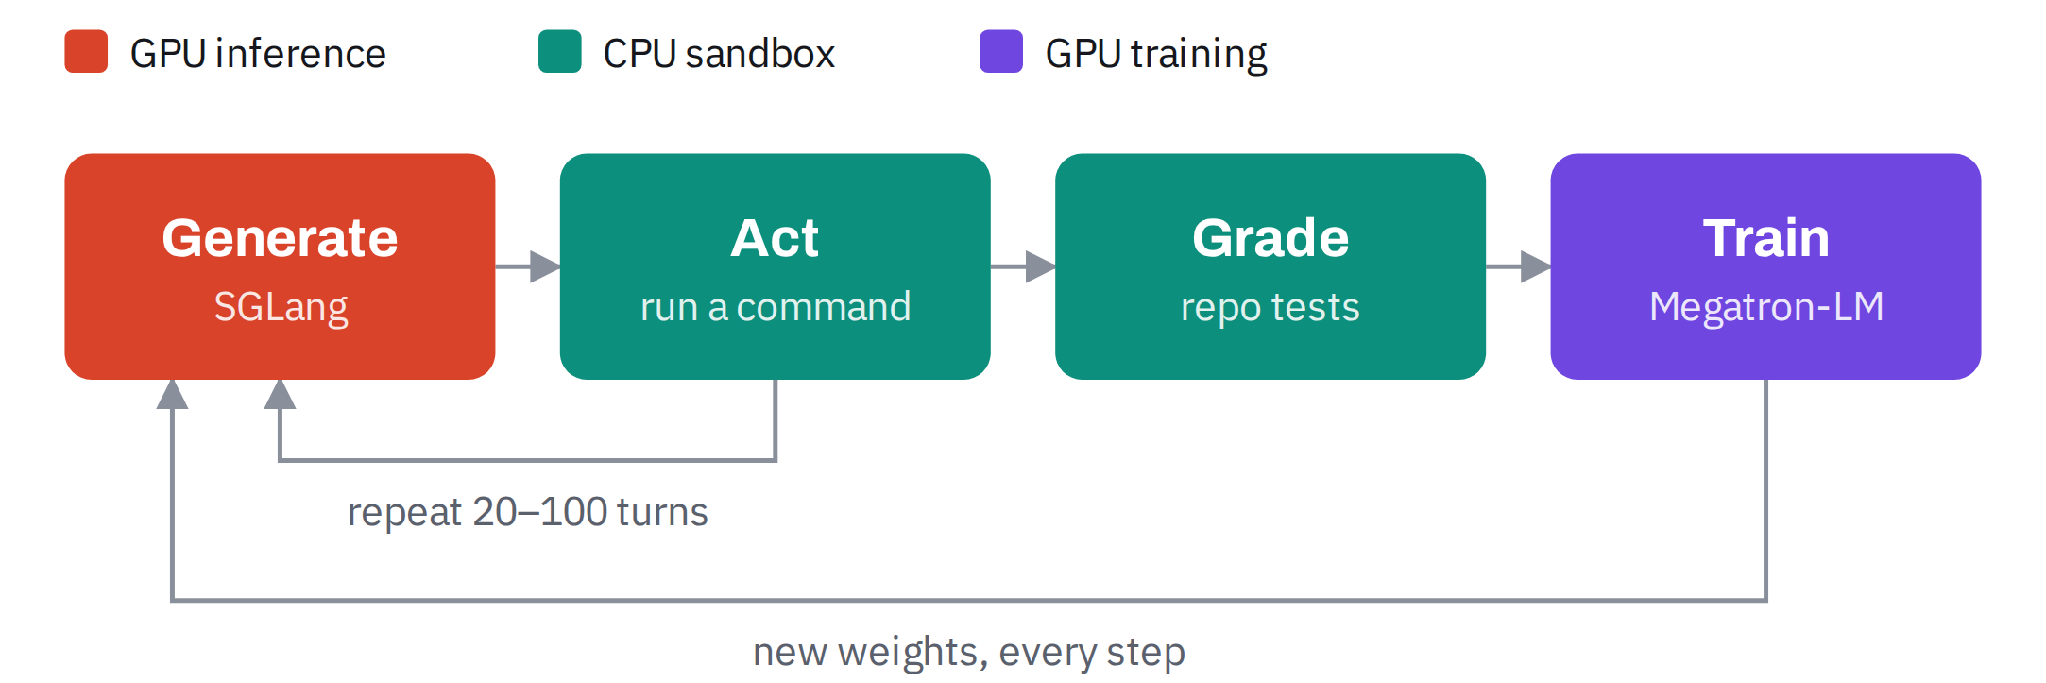
図1:agentic RLループ。SGLangがアクションを生成し、CPU sandboxが実行と採点を行い、Megatron-LMが得られたtrajectoriesを用いて訓練する。
単発RLと比べると、この種の負荷は3つの新たな問題をもたらす。第1はlong-tail stragglersである。同じタスクの異なる試行で所要時間が2.5倍異なることがあり、GRPO groupは最も遅いtrajectoryが完了するまで採点できない。第2は、CPU fleetがクリティカルパスに入ることだ。各trajectoryには、コードをビルドしてテストするための隔離環境が必要になる。第3は、コンテキストが継続的に増大することである。tool outputがコンテキストに次々と書き込まれ、KV cacheへの圧力がさらに拡大する。
システムアーキテクチャ:訓練と推論の分離
このシステムでは、推論と訓練を別々のノードにデプロイする。推論ノードでは8個の単一GPU SGLang engineを実行し、Harborがsandboxを管理する。訓練ノードではMegatron-LMを実行し、新しい重みを推論engineへ送り返す。訓練全体は全非同期である。rolloutと訓練は重ねて実行でき、trainerは最も遅いサンプルを待つ必要がなく、完了済みのtrajectoriesが十分に集まった時点で処理を進められるため、空転を減らせる。
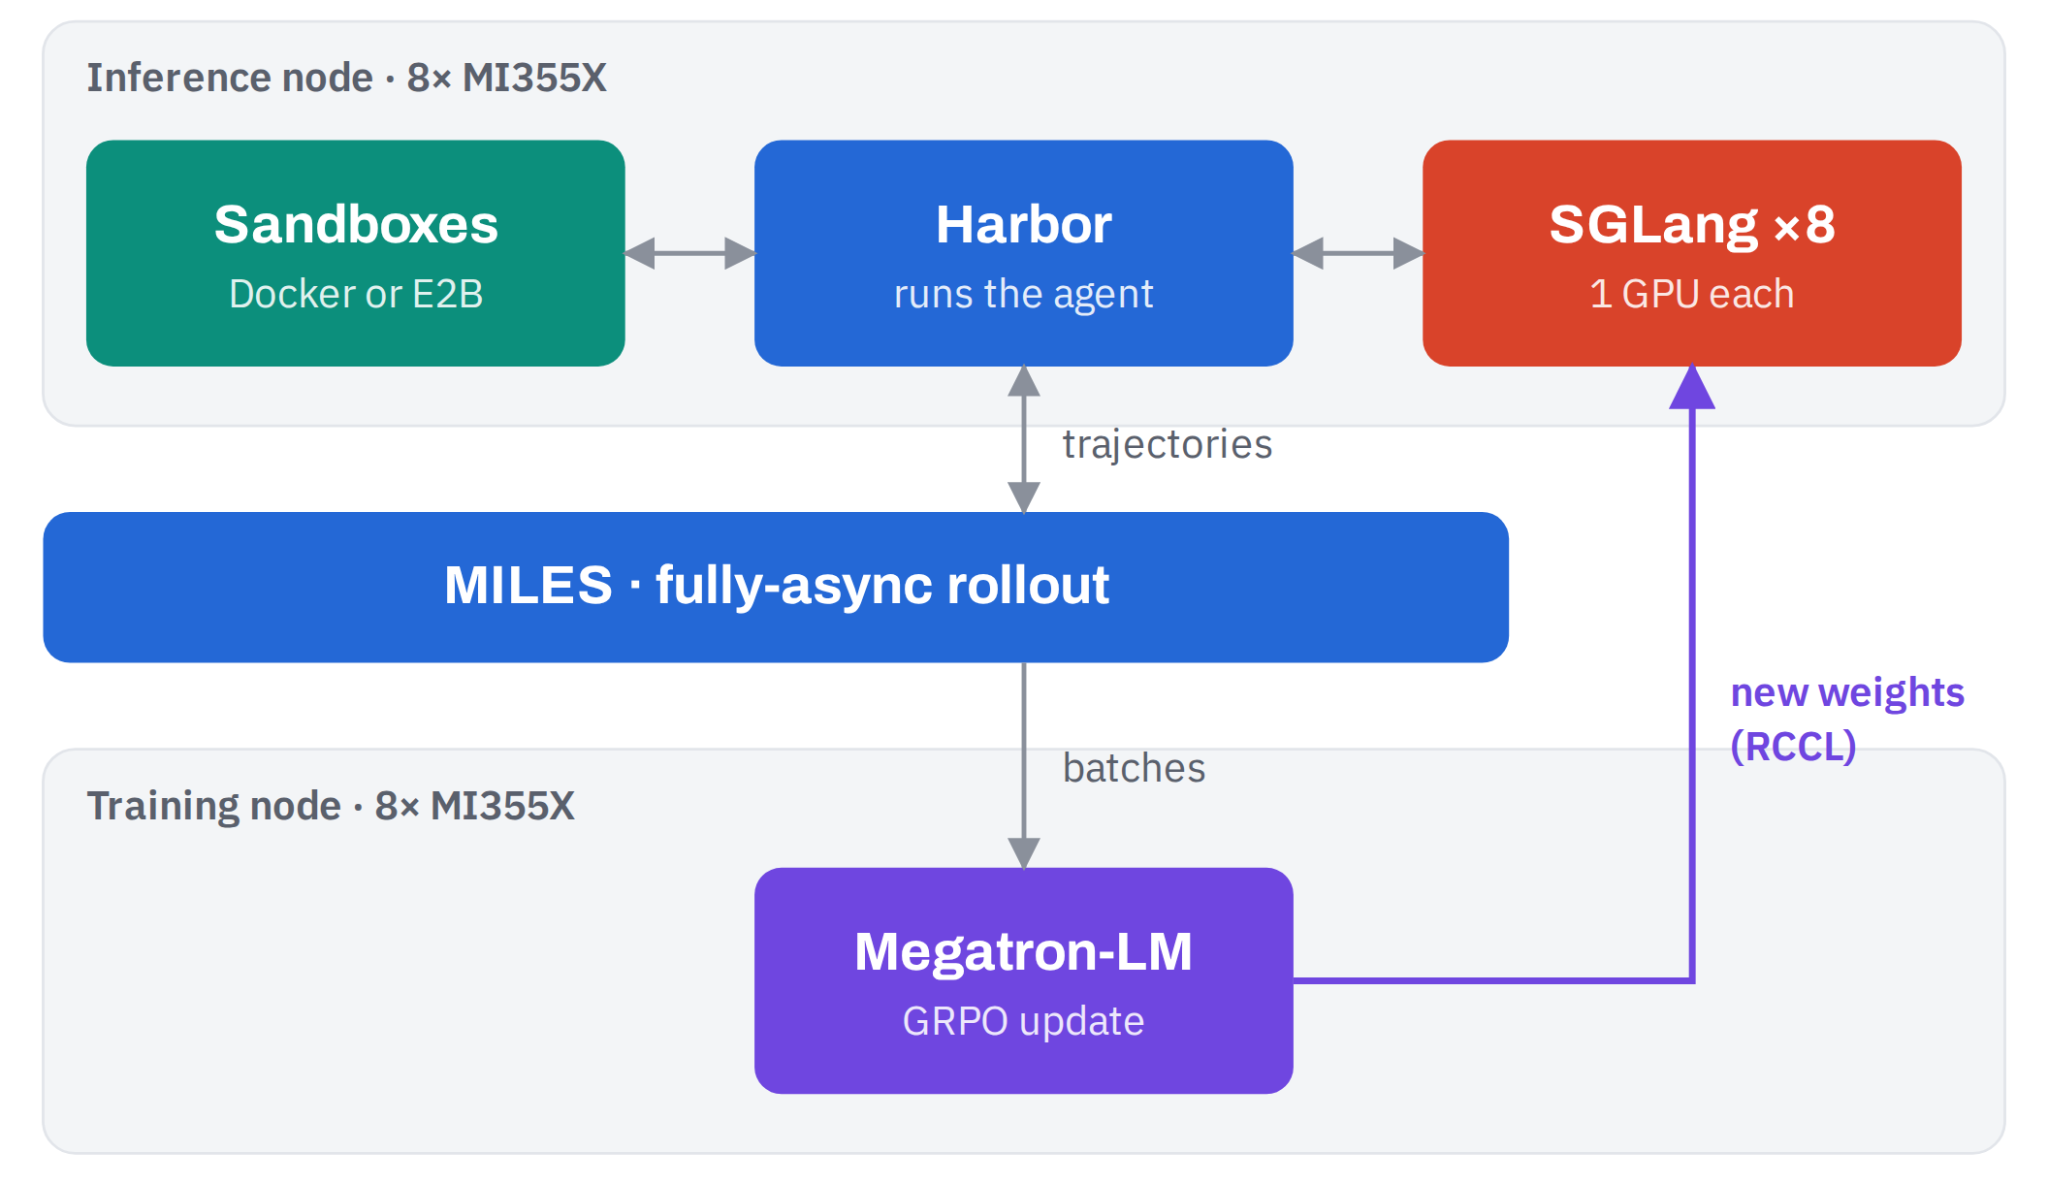
図2:アーキテクチャ概略。推論ノードと訓練ノードはそれぞれ8基のMI355Xを備え、MilesとHarborを通じて連携する。
ソフトウェアスタックはすべてオープンソースコンポーネントに基づき、1つのROCm containerとして提供される。訓練レシピは2段階に分かれる。まず、約4,000件のOpen-SWE-Tracesの公開成功agent tracesでSFTを行い、モデルにツール呼び出しの形式を習得させる。その後、約1,350個のSWE-smithタスクでRLを実施する。これらのタスクは、SWE-bench Verifiedに含まれていない47個のリポジトリに由来する。
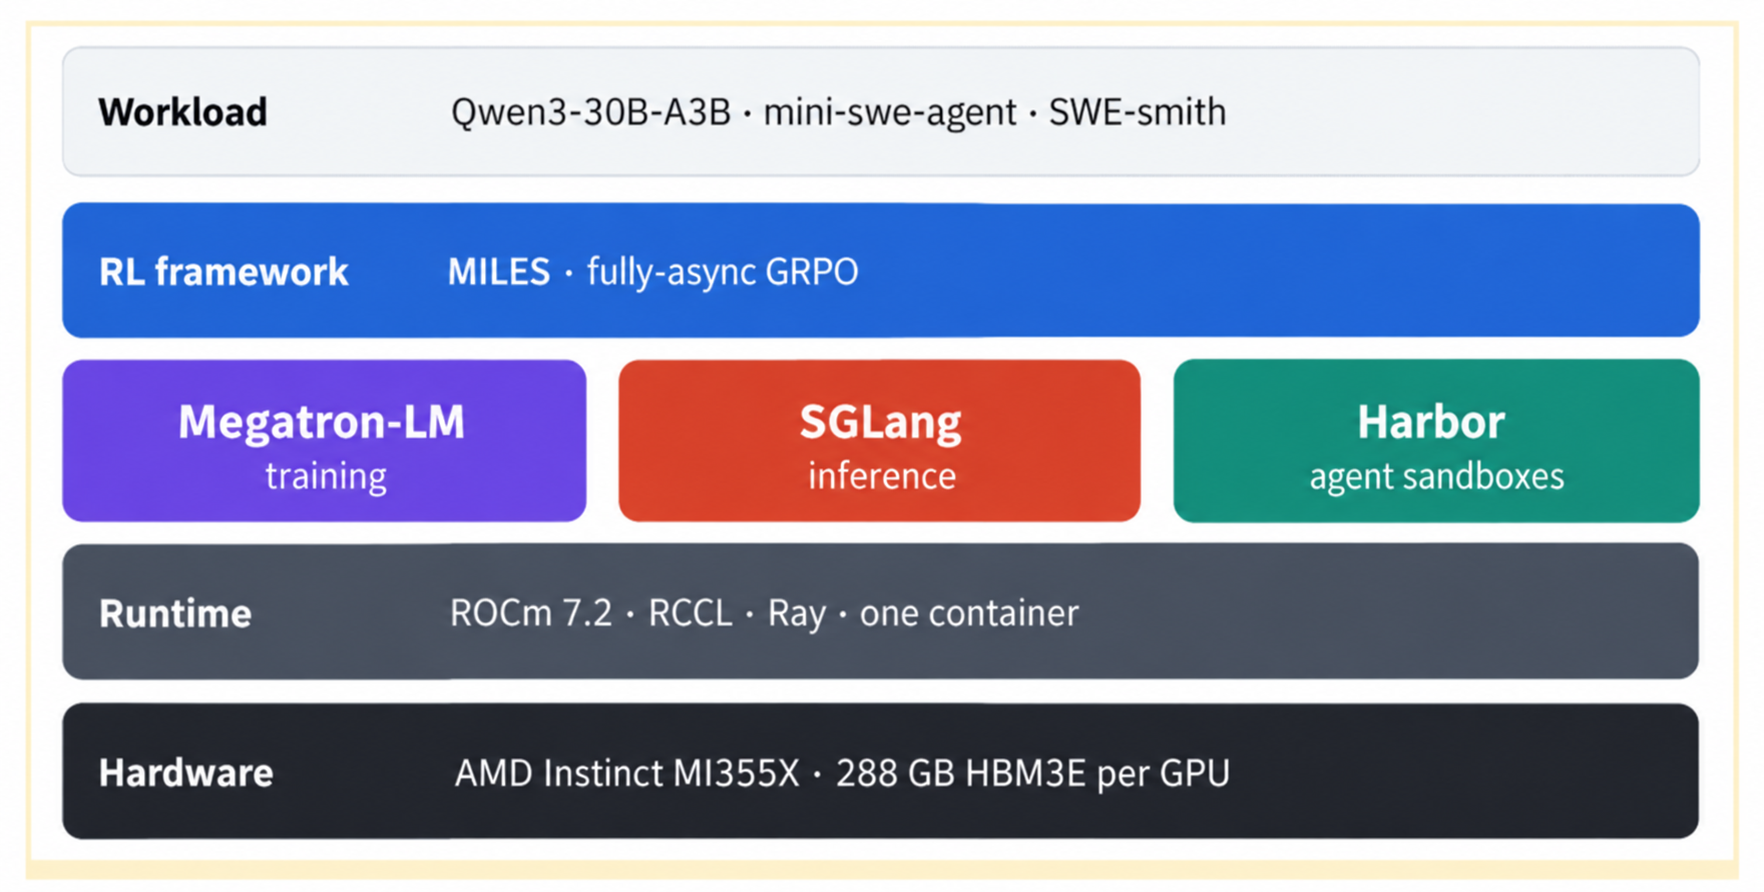
図3:ソフトウェアスタックには、Qwen3-30B-A3B、mini-swe-agent、Miles、Megatron-LM、SGLang、Harbor、ROCm 7.2、AMD Instinct MI355Xが含まれる。
実験設定
実験はQwen3-30B-A3B-Instructから開始し、まず1 epochのSFTを行い、その後、全非同期GRPOでRLを実施した。RL段階では各タスクを8回サンプリングした。リポジトリのテストに合格した場合のrewardは1、そうでなければ0とした。訓練ではKL penaltyを使用しない。各trajectoryの制限は、各ターンで最大8,192 tokens、合計で最大65,536 tokens、最大80ターンである。
| 項目 | 設定 |
|---|---|
| モデル | Qwen3-30B-A3B-Instruct |
| ハードウェア | AMD Instinct MI355X。各GPUは288 GB HBM3Eを搭載。通常構成は1個の推論ノードと1個の訓練ノードで、各ノードに8基のGPUを搭載。最大E2B実験では4個のノードまで拡張 |
| ソフトウェア | Miles、SGLang、Megatron-LM、Harbor、ROCm 7.2。同一のcontainerにパッケージ化 |
| Agent | mini-swe-agent。各trajectoryは1つのsandboxを使用し、local DockerまたはE2B microVMsを選択可能 |
| SFTデータ | 約4,000件のOpen-SWE-Traces公開agent traces |
| RLデータ | 約1,350個のSWE-smithタスク。SWE-bench Verifiedに含まれない47個のリポジトリに由来 |
| 評価 | SWE-bench Verified。100問の階層化サンプル、各問4回試行、指標はpass@1 |
時間はどこに使われているのか
チームは訓練パイプラインのprofilingを行った。trainer側のstep breakdownによると、384-trajectory実行1回において、平均measured stepは208秒だった。actor updateが131秒で約63%、rollout待ちが60秒で約29%、log-probability recomputationが16秒で約8%を占めた。重み同期は別途記録され、約23秒だった。
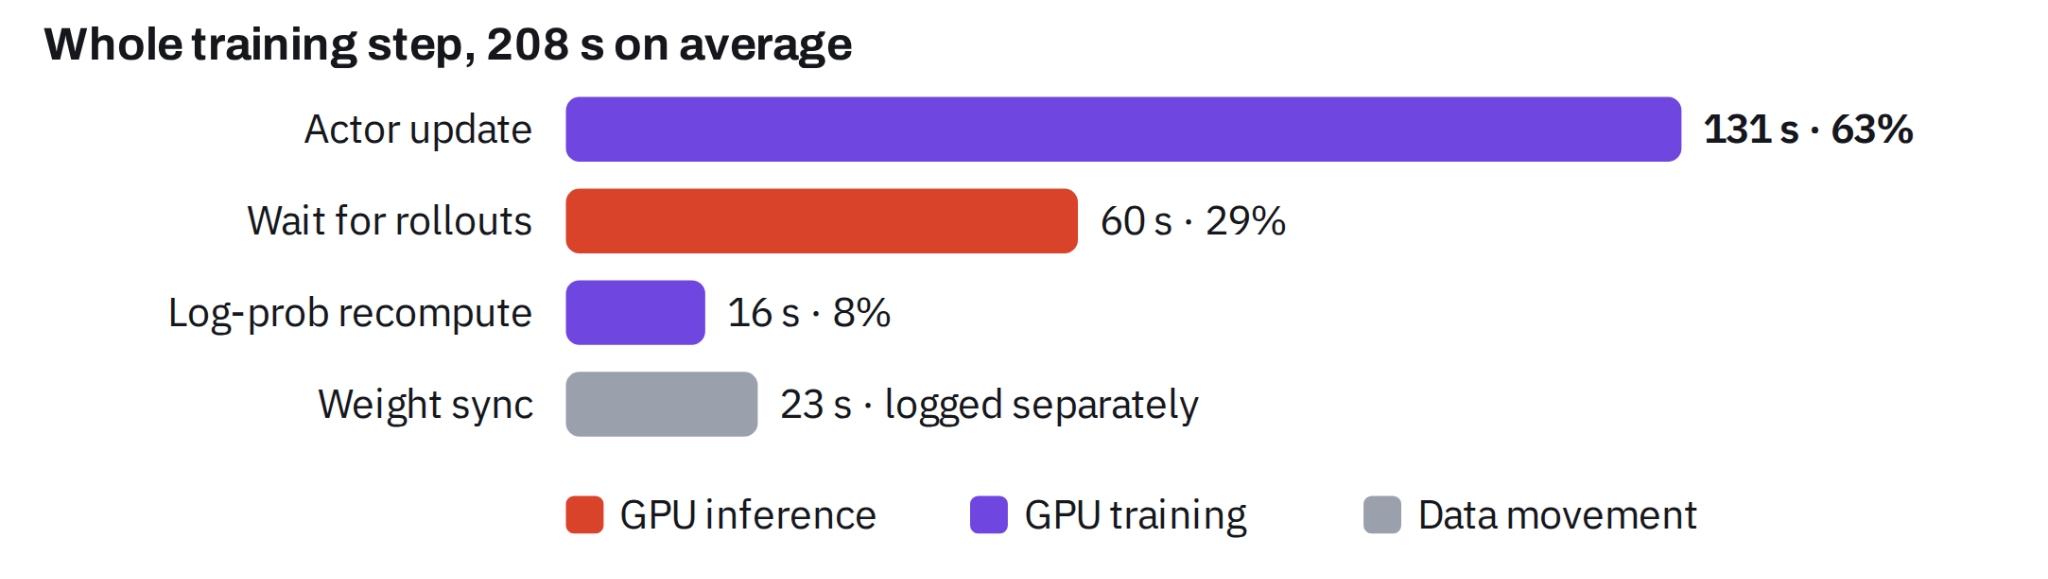
図4:384-trajectory実行におけるtrainer側のstep breakdown。平均stepは208秒で、重み同期は別計上。
長尾trajectoryが最大の敵
GRPOでは、1つのgroupが最も遅いtrajectoryの完了を待たなければならない。問題は、agentがper-turn contextを容易に使い切ったり、turn capに達したりすることだ。実験では84%のtrajectoriesがturn capまで実行されていた一方、成功サンプルの中央値はわずか8ターンで済んでいた。長尾段階に入ると、SGLang engineではdecode中のシーケンスが少数だけ残ることが多く、batch sizeは1に近づき、GPU利用率は明らかに低下する。チームは、rollout時間の32%が、90%のtrajectoriesがすでに完了した後に発生していることを確認した。
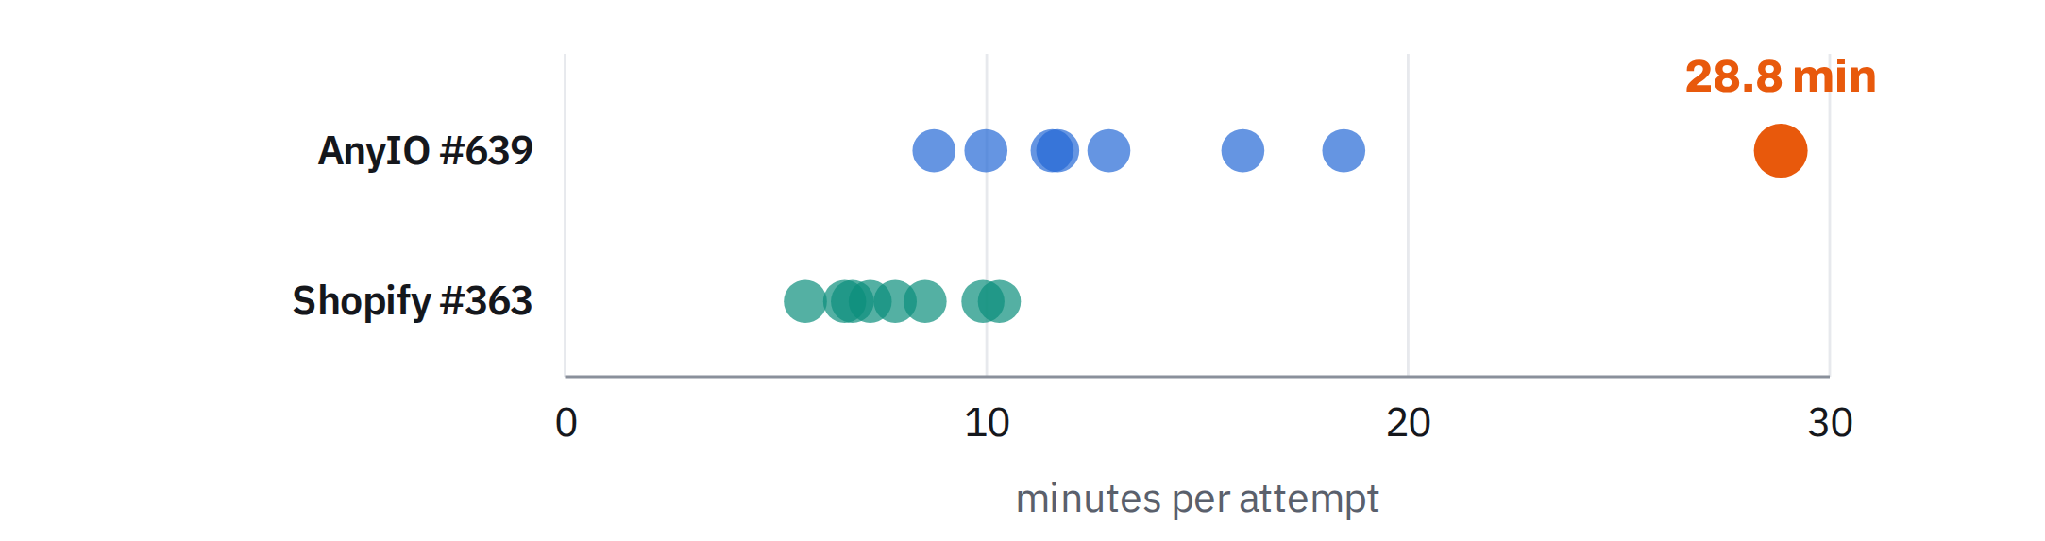
図5:2つのタスクそれぞれで8回試行した際の所要時間分布は非常に不均一であり、最も遅いAnyIOの試行は28.8分を要した。
チームは複数の緩和策を試し、最終的に最も効果が大きかったのは2点だと分かった。全非同期訓練と、より厳しい長さ上限である。同一の8-GPU推論ノード上で、trajectory長を制限するだけで、RL stepを850秒から284秒へ圧縮でき、約3倍の高速化となり、しかも成功サンプルには影響しなかった。
コンテキスト増大とKV cache
各ターンのツール出力はコンテキストに追加される。1 tokenあたり約96 KBとして計算すると、1本の64K-token trajectoryには約6.3 GBのKV cacheが必要になる。context capを設定していない実行では、少数の生成が113K〜186K tokensまで増大し、約10件のリクエストだけでengineの1.5M-token KV cacheを埋め尽くした。その結果、同じengine上の他の99件のリクエストは、タイムアウトするまでtokenを取得できなかった。チームはその後、engine側のcontext capを64Kに設定し、この問題を解決した。MI355Xが1カードあたり288 GBのHBMを備えるおかげで、1台のMI355X engineは数十本の64K-token trajectoriesを同時に収容できる。
CPU側のボトルネック:sandbox
各trajectoryには、リポジトリの取得、依存関係のインストール、テスト実行のために、クリーンな環境が必要になる。同時実行数が増えるにつれ、sandboxは周辺コンポーネントではなくなり、訓練のクリティカルパスに入るCPU fleetとなる。agentがsandboxを待っている間、対応するGPU slotもアイドル状態になる。
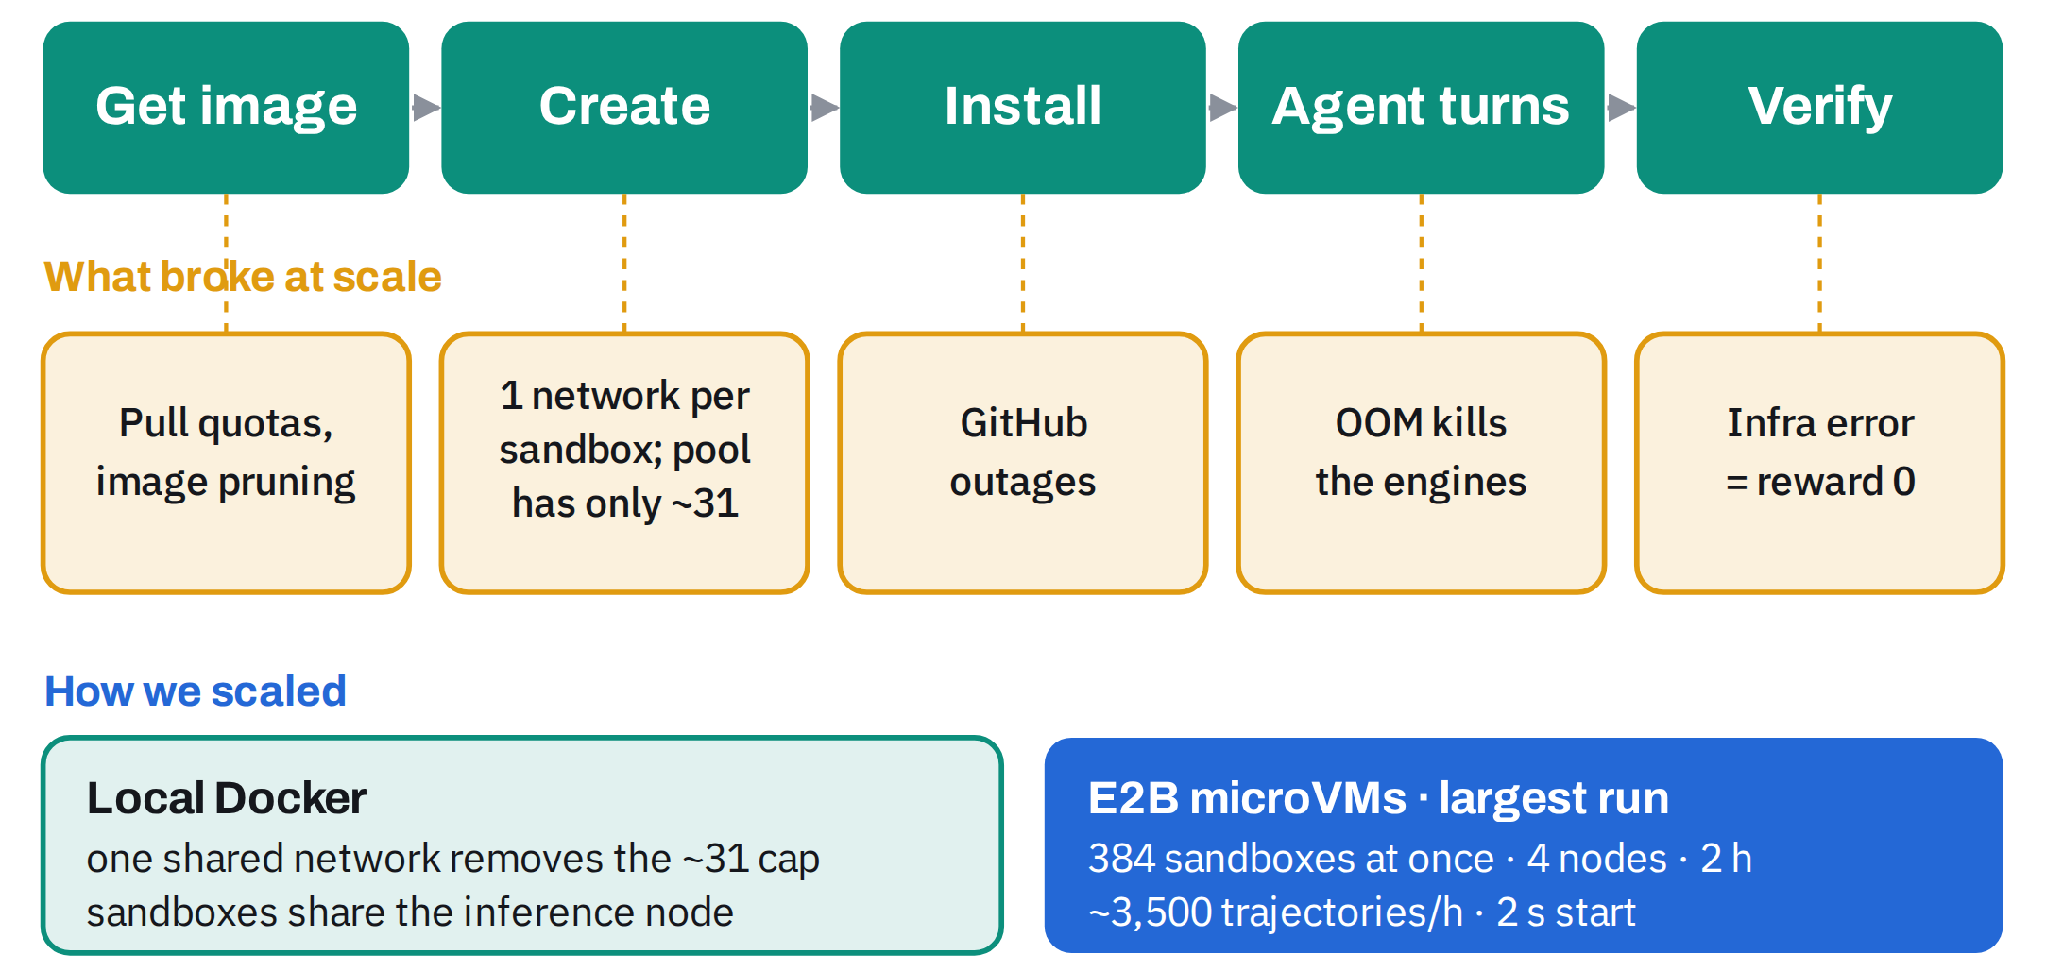
図6:sandboxのライフサイクルと拡張の制限。同時実行が数百に達すると、各段階がボトルネックになり得る。
sandboxをE2B microVMsへ移行
sandboxの負荷を推論ノードから切り離すため、チームはE2B cloud microVMsを使用した。各microVMは2 vCPUsと4 GBメモリ構成である。最大実験では、4個のノード上で384本のtrajectoriesを同時に実行した。24個の単一GPU SGLang enginesがあり、各engineは16本のtrajectoriesを処理した。途中で一度再起動を経た後、rolloutスループットは約3,480 trajectories/hourに達し、local Docker baselineの約4倍となった。
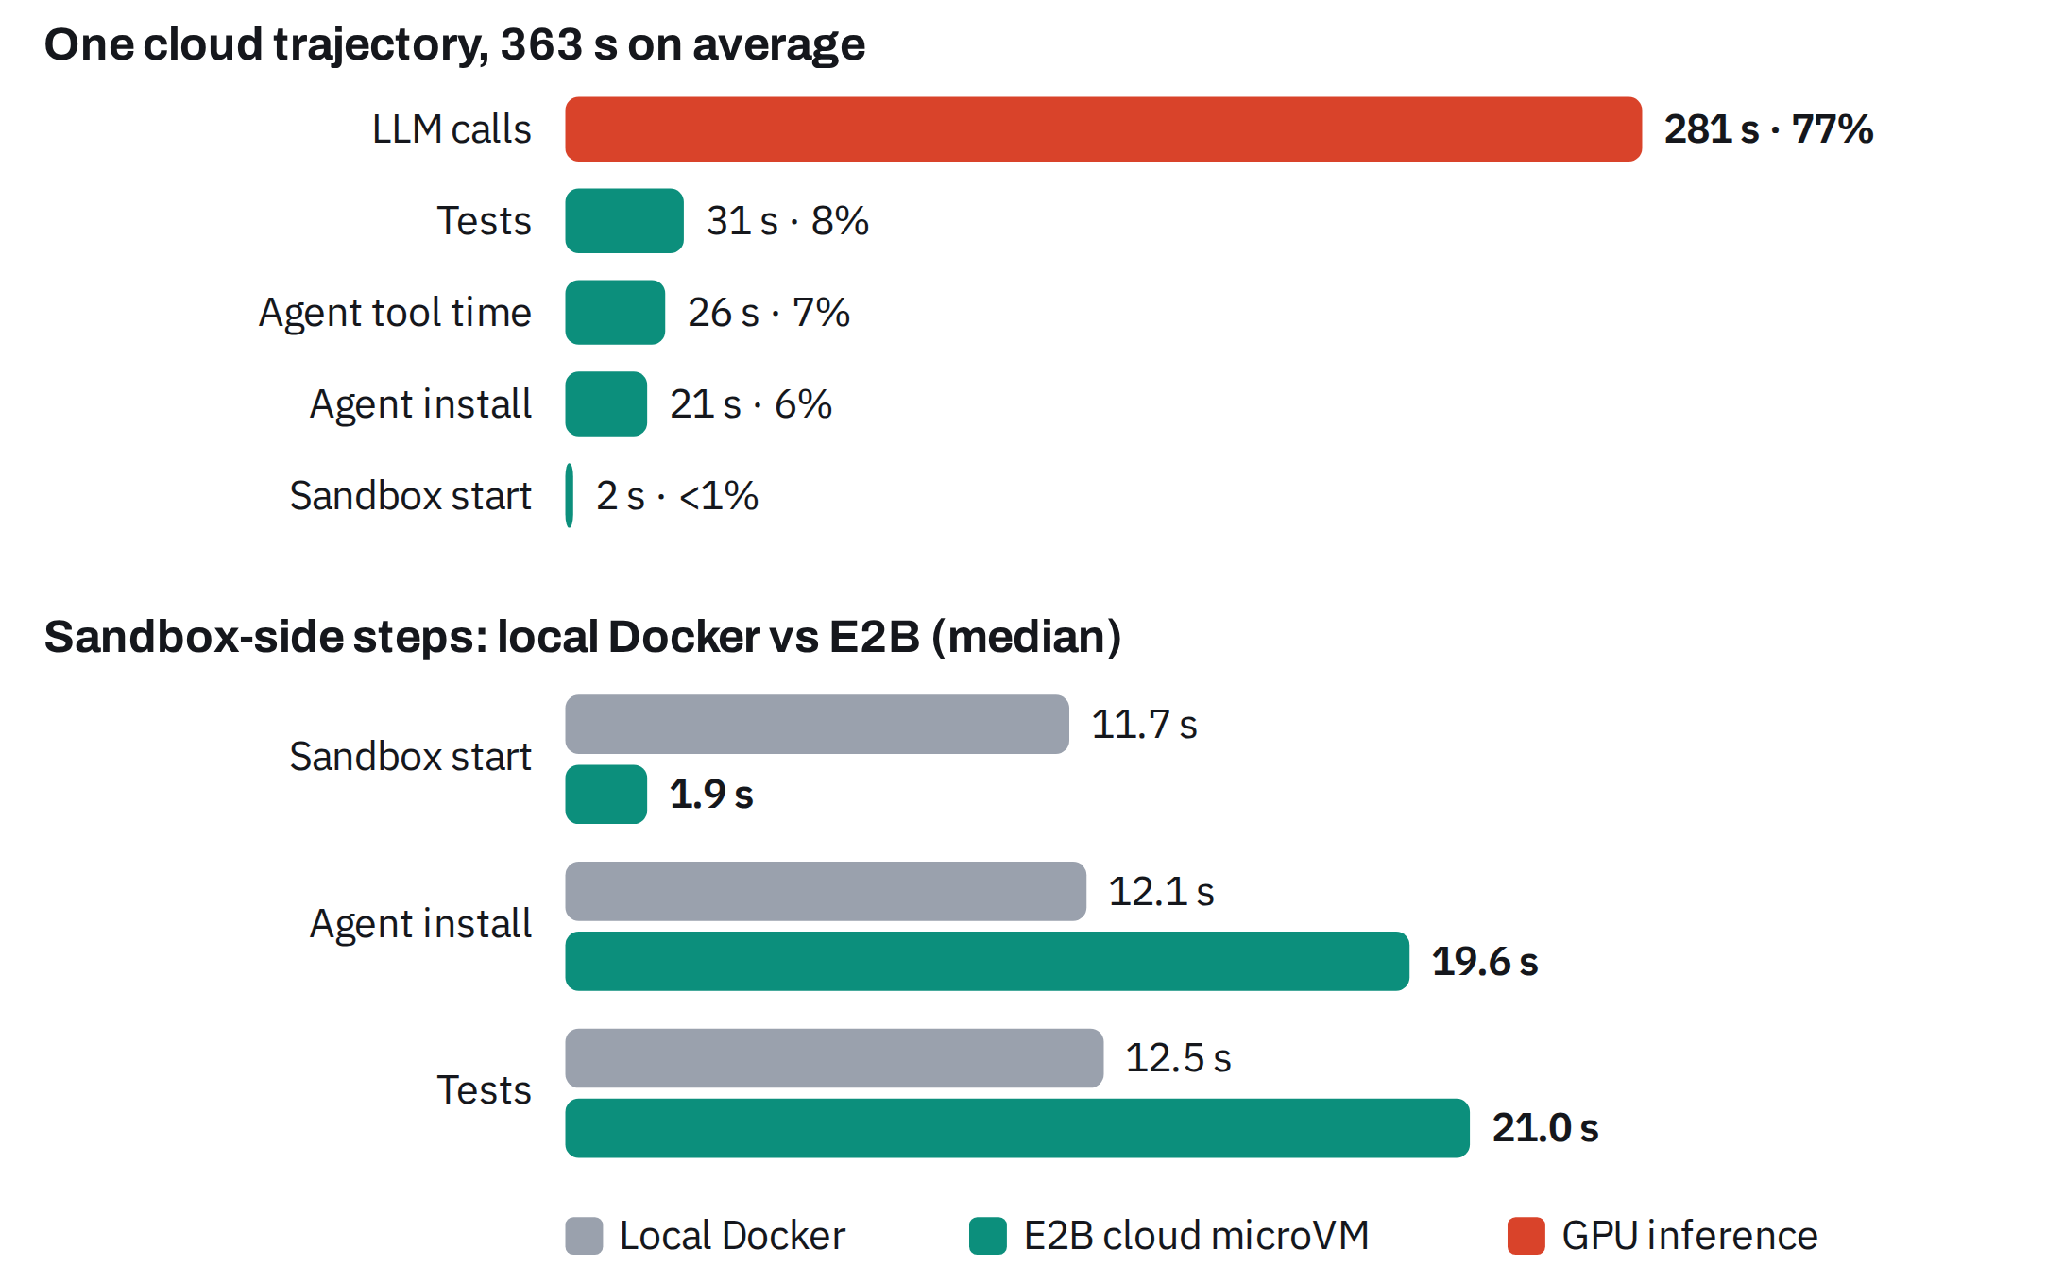
図7:クラウドtrajectoryの時間構成、およびlocal DockerとE2Bの起動、インストール、テスト段階における中央値の所要時間比較。
- sandbox起動はもはや主要コストではない。E2B cloud sandboxのready中央値は1.9秒、p99は3.7秒で、384同時実行でも安定していた。一方、local Dockerは高負荷時に約11.7秒だった。
- 取得や計算を伴うステップは遅くなる。2-vCPU microVMでは、agentのインストールに約7.5秒、テスト実行に約8.5秒余計にかかる。各LLM callもtunnelを通過するため、約0.26秒増える。そのため、1本のtrajectoryあたり15〜40秒増加し、総時間の約4%〜11%を占める。
- sandbox側はtrajectoryのおよそ5分の1を占める。クラウド実行では、LLM callsがtrajectory時間の77%を占めた。テスト、ツール呼び出し、agentインストールなどのsandbox側操作は、合計で残りの部分を占めた。
モデル効果:SFTは有効だが、agentic RLこそが重要な飛躍
最終評価では、ベースモデルのSWE-bench Verified 100問階層化サブセットにおけるpass@1は7.3%だった。SFT後は12.8%に向上し、さらにagentic RL後には27.5%に達した。これは、SFTが主にモデルにツール形式と基本フローを学ばせるのに役立つ一方、ソフトウェアエンジニアリングタスクでモデルを大きく進歩させる真の要因は、複数ターンの相互作用環境における強化学習であることを示している。
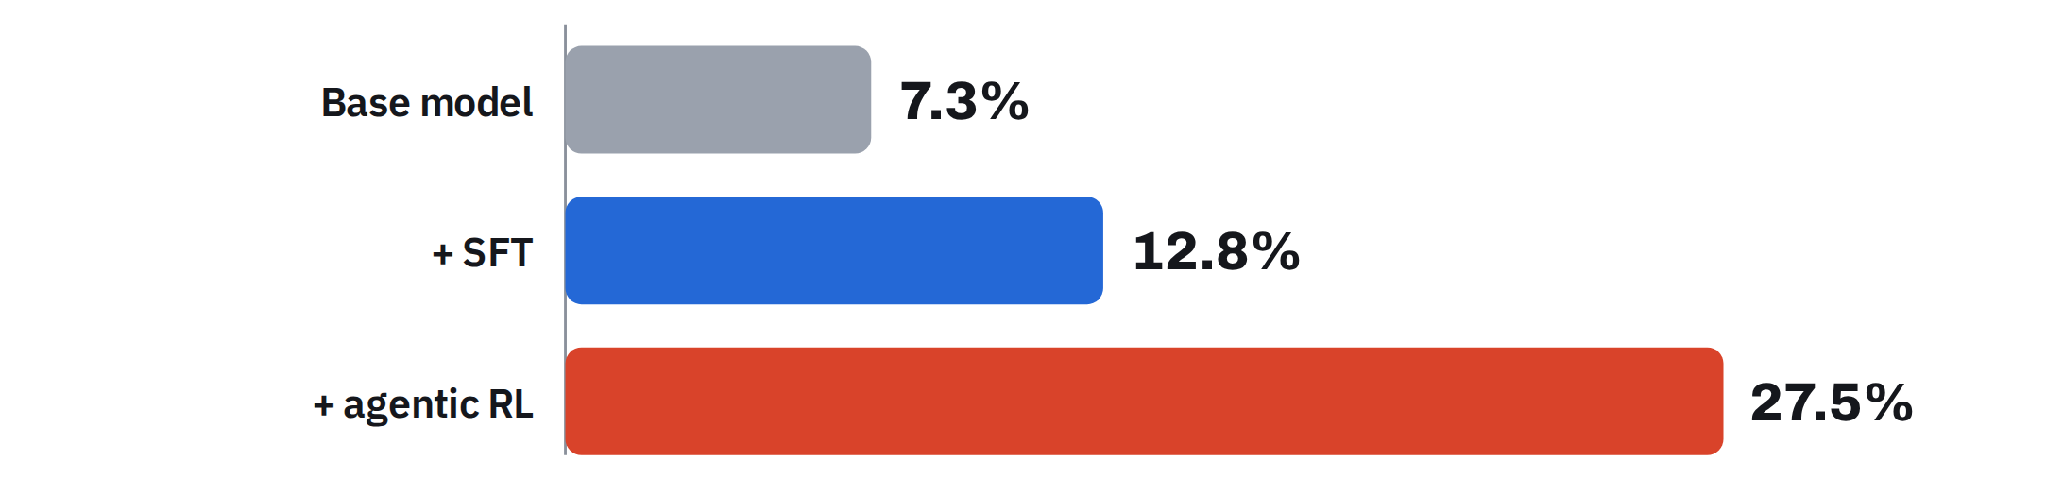
図8:SWE-bench Verifiedサブセットのpass@1は、ベースモデルの7.3%からSFT後に12.8%へ向上し、agentic RL後には27.5%に達した。
訓練中、チームはreward、response length、gradient norm、そしてtrainerとSGLangの間のlog-probability gapを継続的に追跡した。145回のRL stepsと3回のrestartの曲線は、システムが非同期訓練、重み同期、rolloutの長尾がもたらす複雑性に対処する必要がある一方で、全体的な学習傾向は進み続けられることを示している。
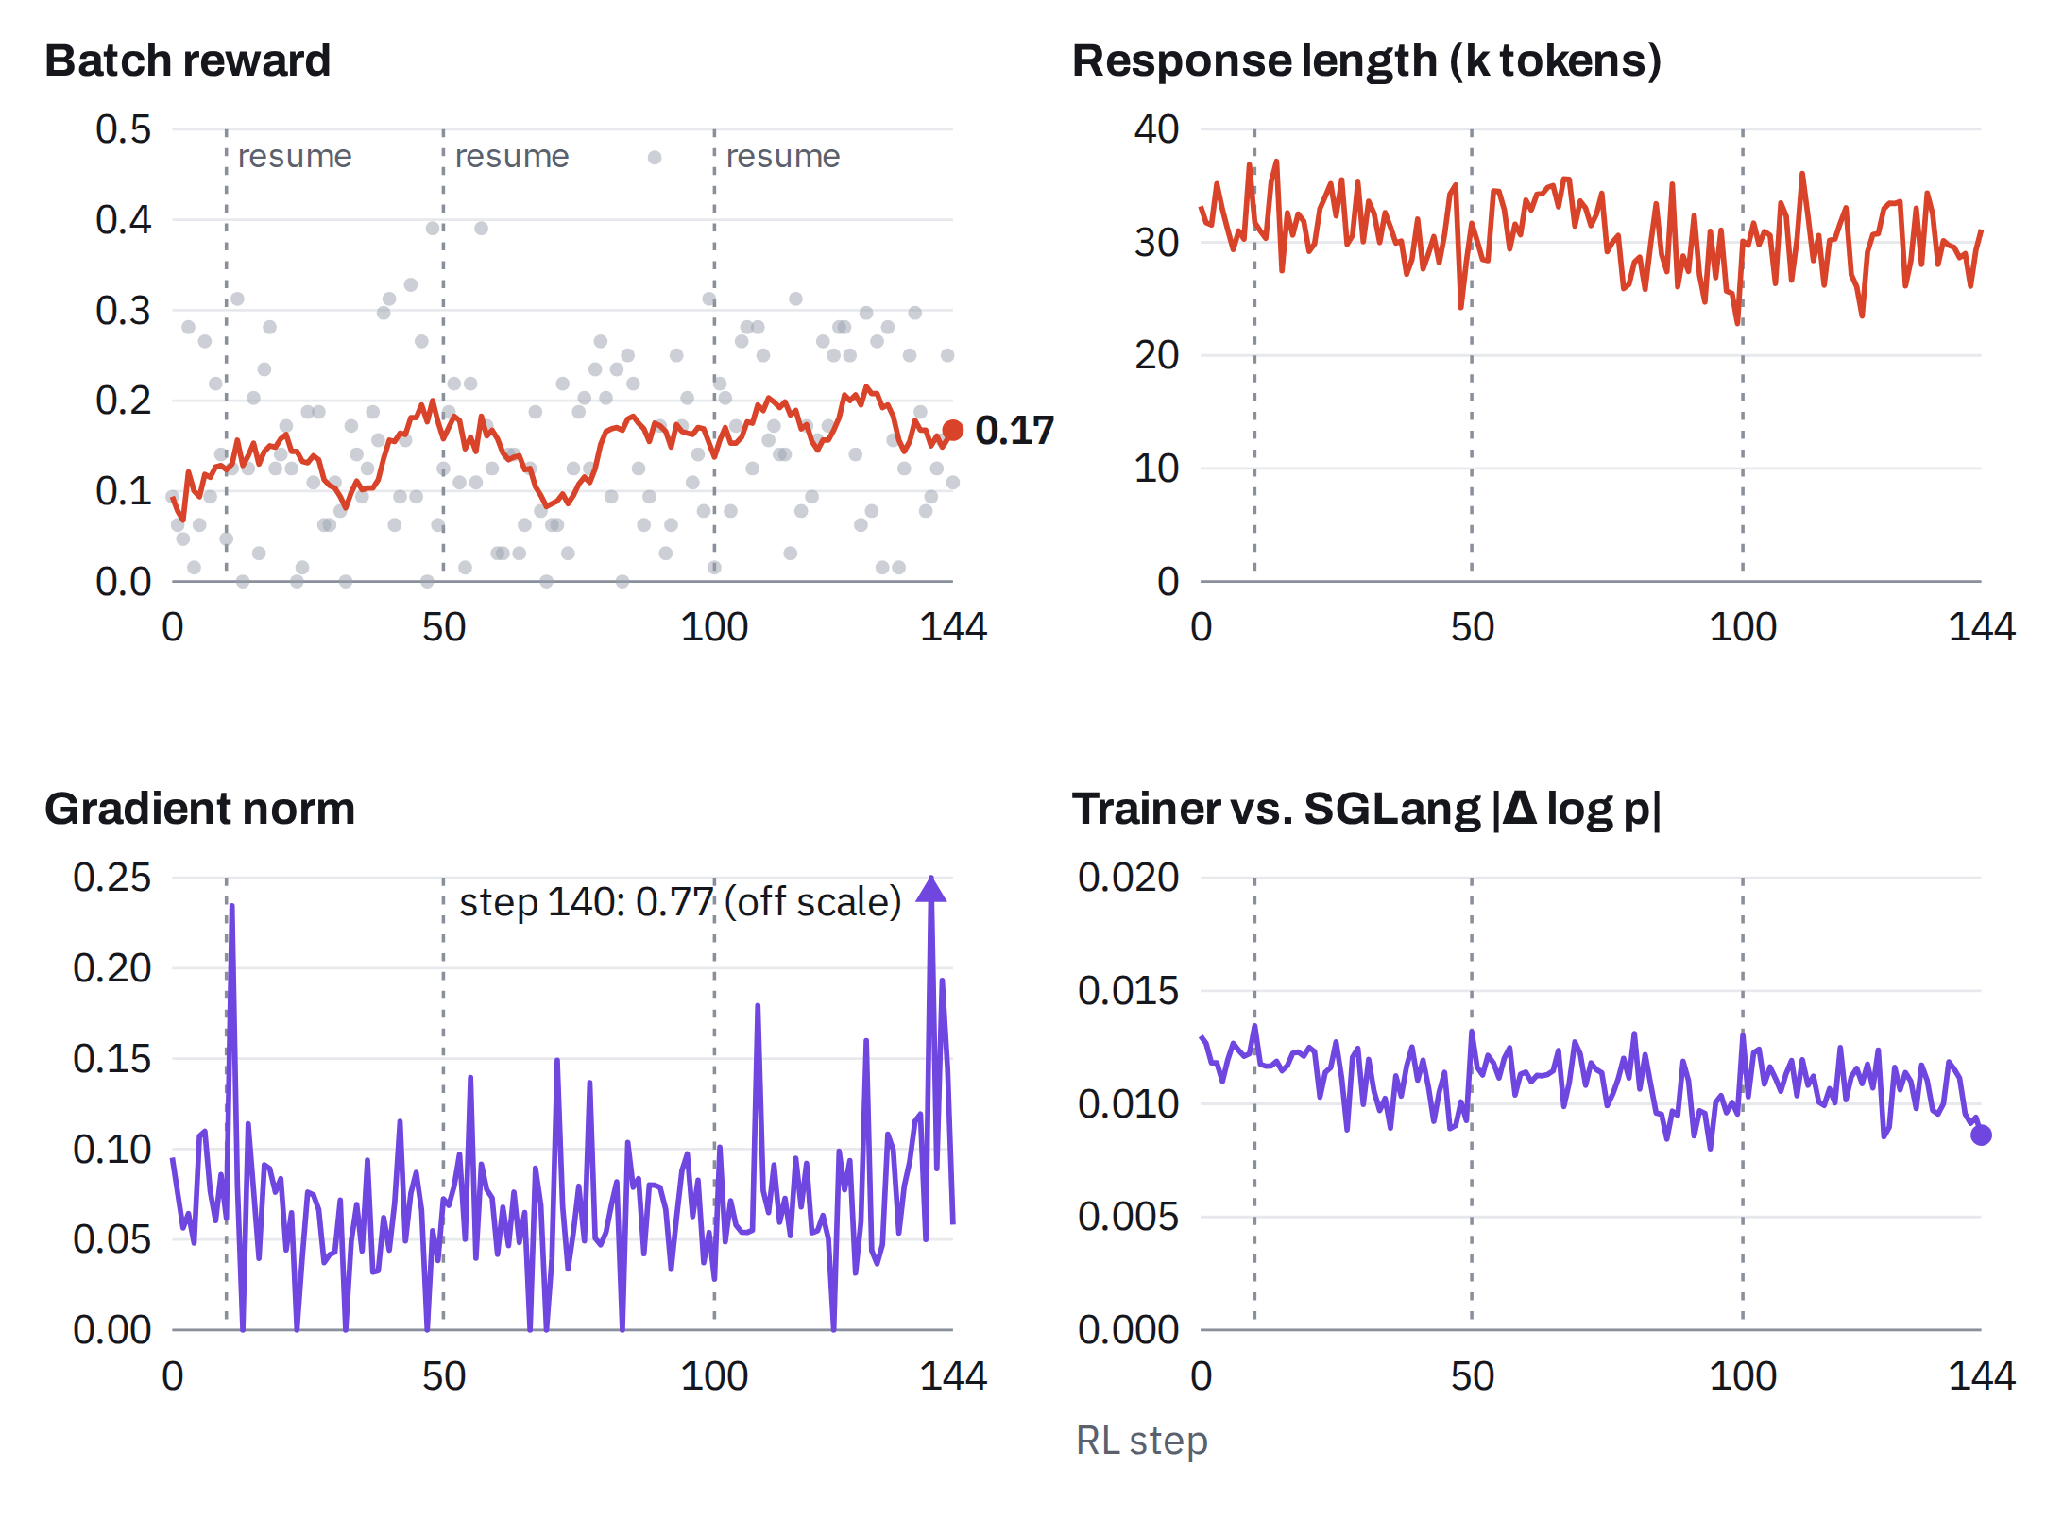
図9:145回のRL stepsと3回のrestartにおけるreward、response length、gradient norm、log-probability gap。
結論:agentic RLのボトルネックはシステムエンジニアリング
この実験は、ソフトウェアエンジニアリングエージェントの訓練が、モデルを大きくしたりGPUを増やしたりするだけではないことを示している。スループットと学習速度を真に左右するのは、一連のシステム連携である。trainerを最も遅いtrajectoryに足止めされないようにする方法、SGLang engineのKV cacheが少数の異常リクエストに占有されるのを避ける方法、sandboxをGPUノードのクリティカルパスから切り離す方法、そしてMiles、Harbor、SGLang、Megatron-LMの間でデータと重みの流れを効率的に保つ方法である。
MI355X上で、チームは全非同期GRPO、trajectory length cap、cloud sandbox拡張、マルチノード推論により、Qwen3-30B-A3B-InstructのSWE-bench Verifiedサブセットpass@1を27.5%へ引き上げた。今後、より大規模なコードエージェントを訓練するうえで、長尾、sandbox、データ移動に関するこれらの知見は、単純な計算能力の拡張よりも重要になる可能性がある。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接