
Agenticワークロードでは、リクエストが非常に長く、かつ大部分が変わらない履歴コンテキストを繰り返し伴うことが多い。Radix cacheはGPUメモリ内でプレフィックスKVを再利用でき、HiCacheはこの再利用をホストメモリと外部ストレージへ拡張する。実際に本番環境に入ると、キャッシュシステムはContext Parallelism、Pipeline Parallelism、Speculative decoding、prefill-decode disaggregationなど、複数の並列・分散推論メカニズムにも同時に適応しなければならない。
本稿では、これらのシナリオにおけるHiCacheの中核設計を整理する。Context Parallelism下で統一された論理プレフィックスを維持すること、Pipeline Parallelismで各stageに一貫したキャッシュ判断を行わせること、Speculative decodingでdraftモデルの状態を復元すること、統一KVレイアウトによって並列構成をまたいでキャッシュを共有すること、そしてP/D分離シナリオで欠落KVだけを転送することである。
本番運用では、iFLYTEK Astron MaaSチームがPipeline Parallelism、prefill-decode disaggregation、MTPを組み合わせ、GLM-5.1/5.2 CodingPlanワークロードの提供に利用している。リクエストは通常30Kから200K入力tokenを含み、少数は100万tokenに達する。HiCacheを有効化していない場合、キャッシュヒット率は約30%で、ユーザーは長時間待つ必要があった。外部ストレージを備えたHiCacheを導入した後、ヒット率は95%に向上し、median TTFTは3秒未満に低下した。
Context Parallelism × HiCache:ページベースのKVシャーディング
Context Parallelismはprefill計算を複数のrankに分散するが、KV cacheが各rankで複製されたままだと、大量のGPUメモリを浪費する。HiCacheはpageベースのKV shardingを採用し、重複コピーを取り除きつつ、各リクエストの統一された論理ビューを維持する。
統一論理Radix treeとページ所有関係
CPシナリオでは、各rankが同一の論理Radix treeを維持し、同じlogical page IDを使用する。2つのrankを例にすると、偶数pageはrank 0に、奇数pageはrank 1に属する。これにより、A/B/Cという3つのプレフィックスページのKVが実際には異なるGPU上に分散していても、任意のrankがA/B/Cにヒットした際に、同一グループの論理キャッシュページであると認識できる。
N個のshard rank、pageサイズがp token、論理スロットがxの場合、HiCacheは単純な算術マッピングでKV位置を決定する。q = floor(x / p)はlogical cache page IDを表し、r = q mod Nはowner rankを表し、l = floor(q / N) * p + (x mod p)はowner側のローカルrowを表す。このマッピングでは、ページごとのテーブル参照は不要である。
リクエストがA/B/Cを再利用し、さらにpage Dを追加する場合、allocatorはプレフィックスのownerシーケンスを継続する。0、1、0の次は1となる。tree構造はこのownership rotationを記録し、互換性のないページローテーションが同一プレフィックスに混入することを避ける。
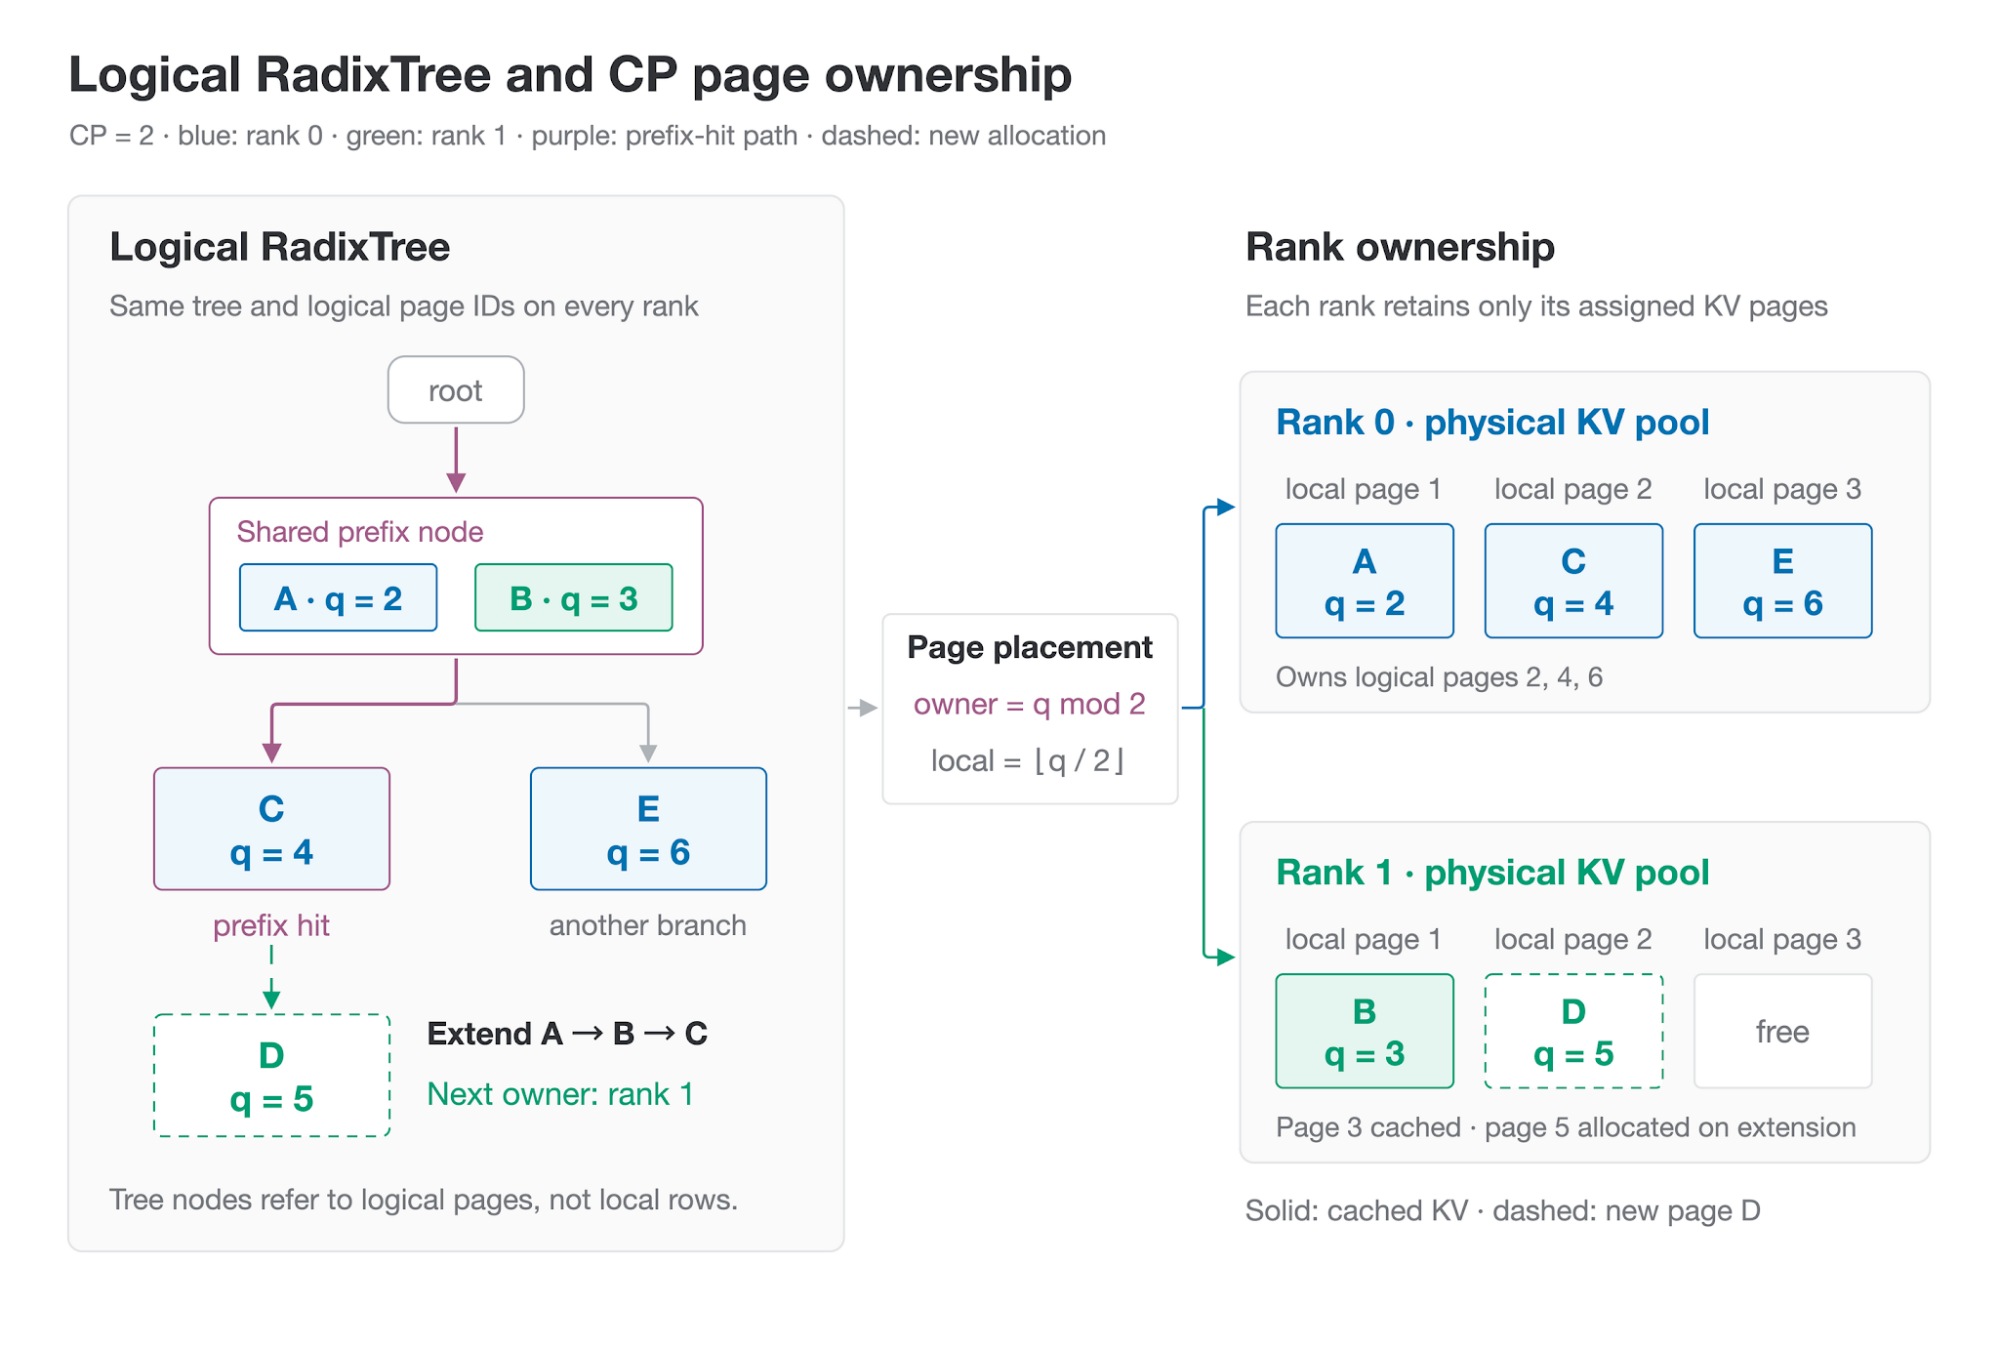
図1:2つのCP rankが同一の論理Radix treeを共有し、logical page IDがページownerを決定する。A/B/Cプレフィックスを拡張する際、Dはrank 1に割り当てられる。
層ごとに分割KVを読み取る:各層で1回のgather
KVが分割されると、単一rankのローカルcacheには完全なコンテキストの一部だけが保持される。attentionが完全なプレフィックスを読み取れるように、各rankは特定の層を処理する前に、自身が所有するpagesをall-gatherに提供し、その層の一時bufferに書き込む。
例えばrank 0はAとCを提供し、rank 1はBとpadding pageを提供する。gather後のbufferはownerごとにグループ化され、attentionはpage-table mappingを通じて論理順序A、B、Cで読み取るため、物理的な並べ替えは不要である。システムは2つの一時scratch bufferを層間で交互に使用する。現在の層でattention計算が行われている間に、次の層のgatherを並列に実行できるため、assembled KVに伴う追加GPUメモリを2つのlayer buffer以内に抑えられる。
サポートされる構成では、gatherはNCCL SM kernelsではなくGPU copy enginesを使用し、モデル計算とのSMリソース競合を減らす。言い換えれば、プレフィックスヒットは重複したprefill計算を回避するが、分散KV gatherのコストは依然として支払う必要がある。
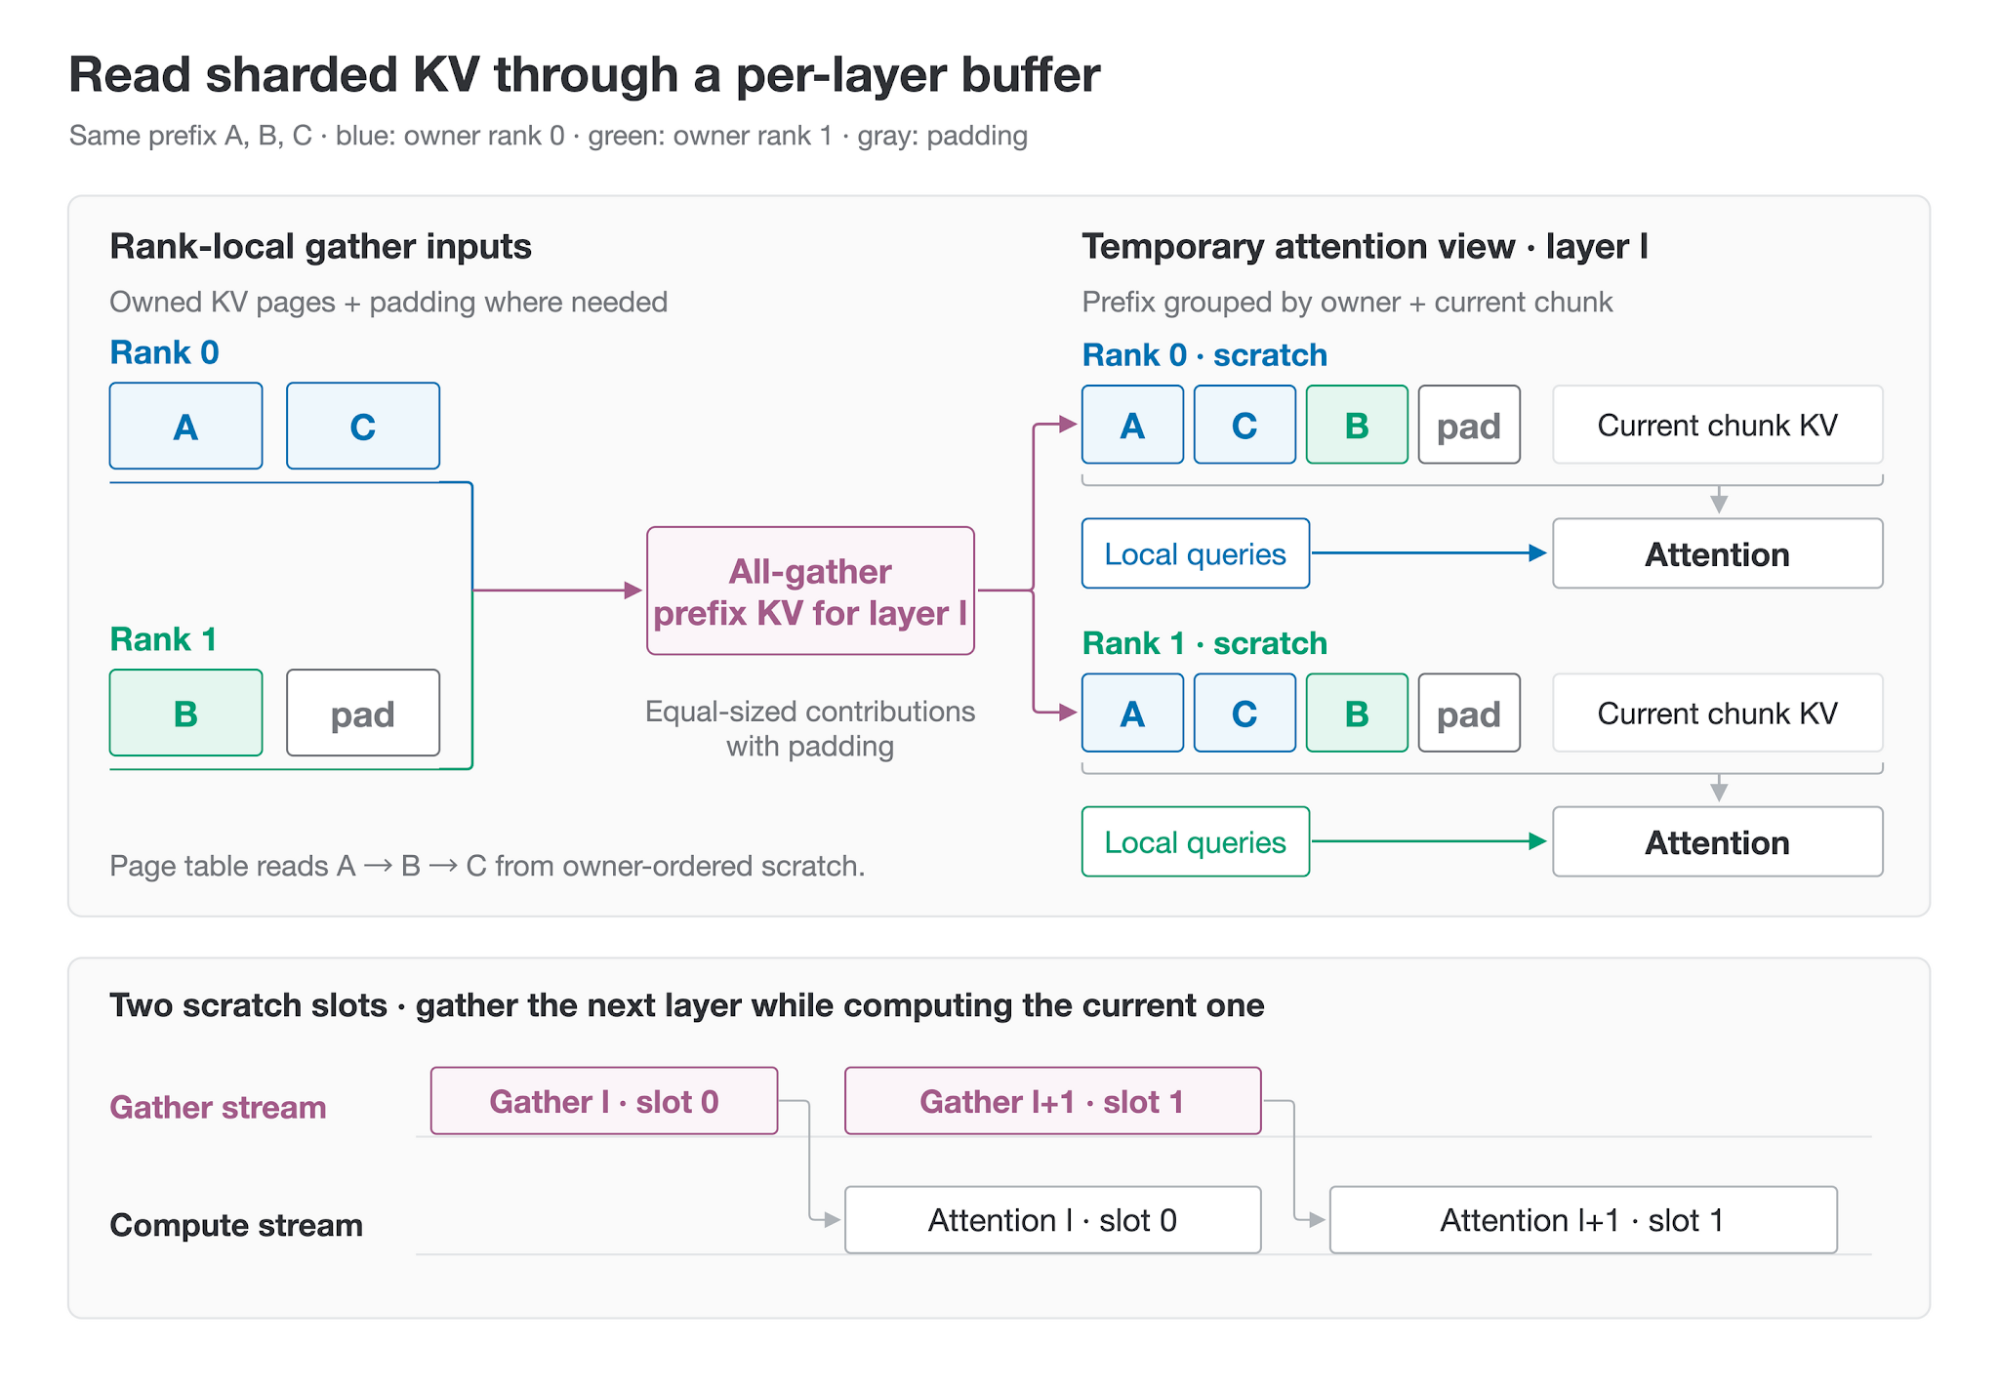
図2:各rankは当該層で自身が所有するpagesを提供し、all-gatherによって同一のowner-ordered scratch bufferを生成する。二重scratch slotにより、次の層のgatherを現在の層のattentionと重ね合わせられる。
HiCache統合:まず各shardを復元し、その後gatherを実行する
HiCacheがGPUとhost memoryの間でKVを移動する際にも、ページの所有関係を保持しなければならない。そうしなければ、復元後のpageが誤ったrank上に置かれ、次回gather時に対応するKVを提供するrankがいなくなる可能性がある。上記の3ページを例にすると、rank 0はAとCをバックアップおよび復元し、rank 1はBをバックアップおよび復元する。GPUの物理アドレスが変わっても、owner関係は変わらない。
cache treeとtransfer queuesは引き続き論理インデックスを使用する。実際にコピーする際、各rankは自分に属するsource-destination page pairsを選択し、ローカルアドレスに変換する。実行順序は、まずtransfer streamでローカルpagesを復元し、次にgather streamがその層のrestore-completion eventを待ち、最後にattentionがgather bufferの完了を待つ。
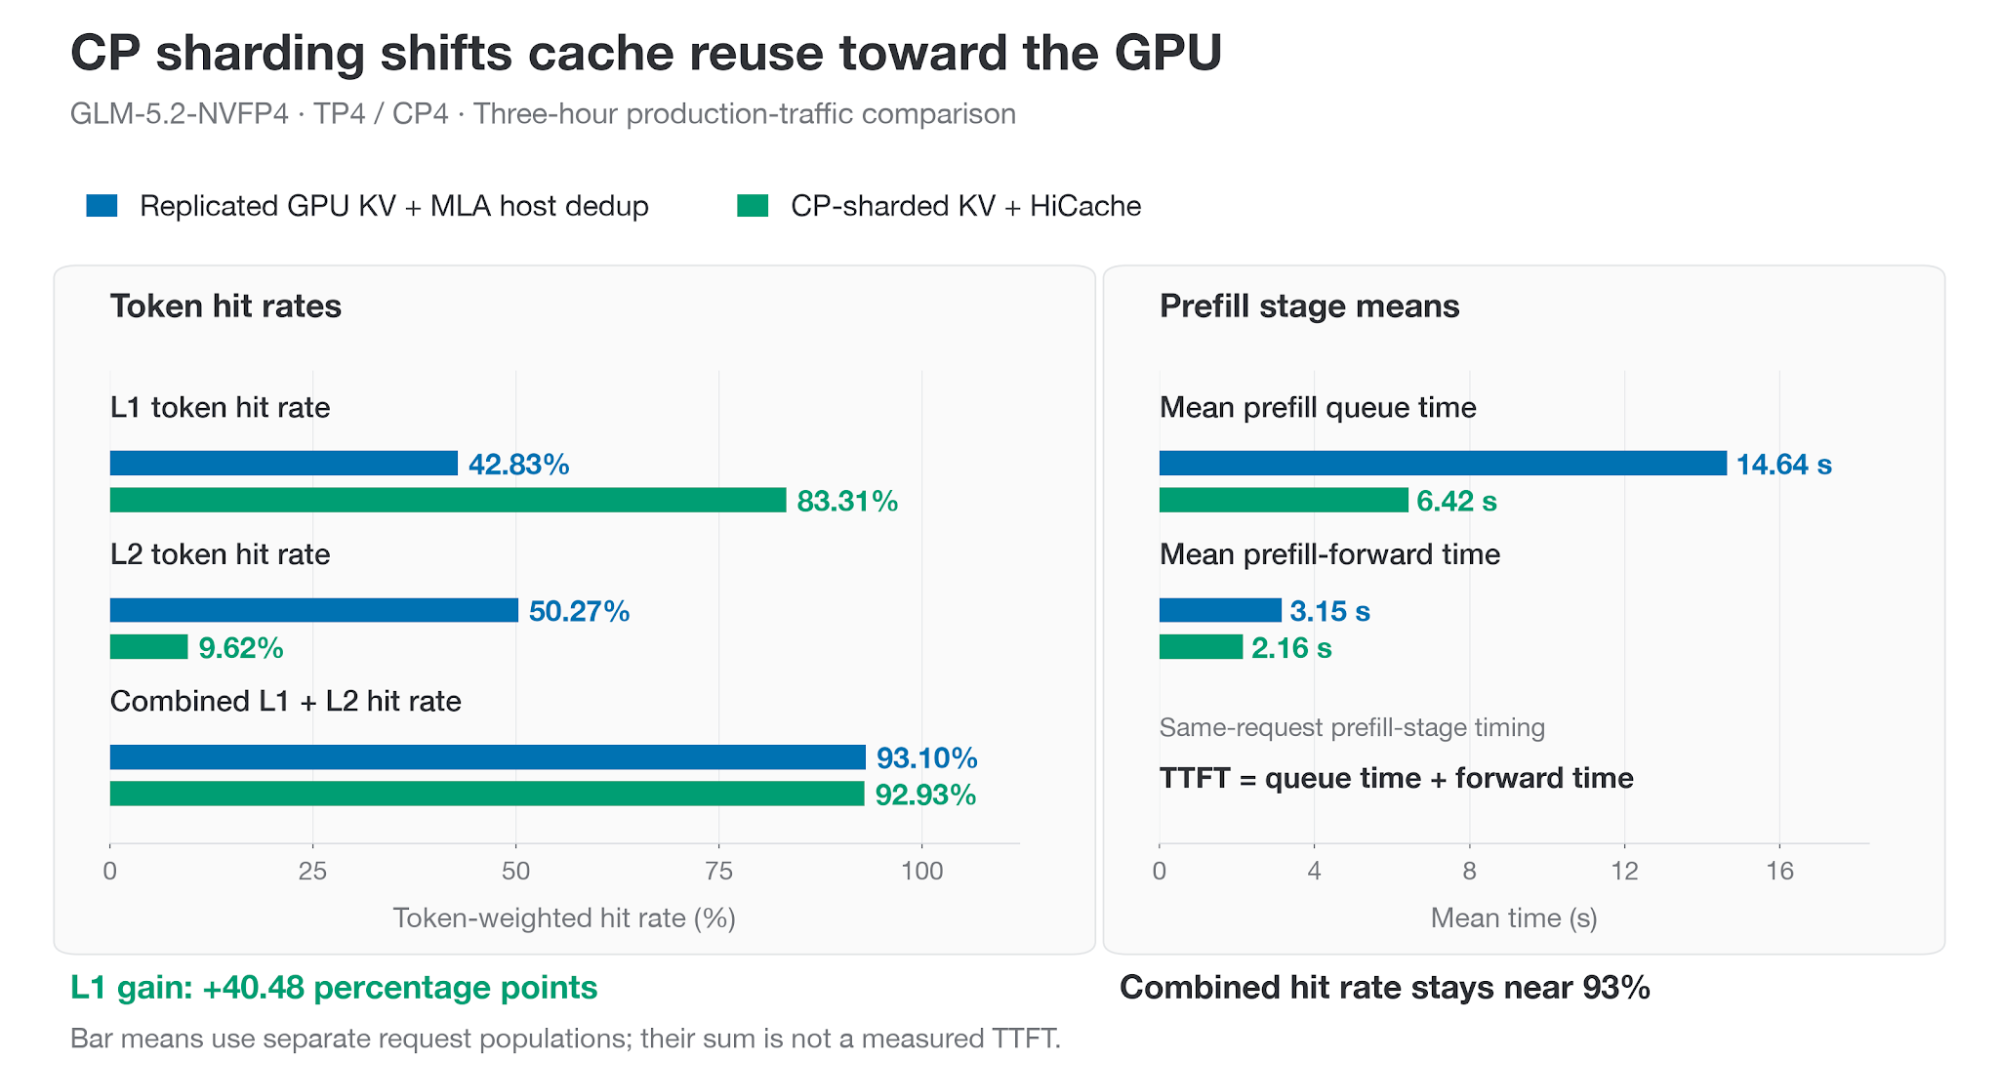
図3:HiCacheはバックアップと復元時にページownerを維持する。各rankはrestore、gather、attentionの順に処理を進める。
本番トラフィック下での性能結果
評価にはGLM-5.2-NVFP4を使用し、構成はTP4/CP4、EAGLE MTP、static memory fraction 0.9である。各deploymentには2つのprefill enginesが含まれ、各engineは4枚のNVIDIA GB300 GPU上で動作する。対照群はGPU上でKVを複製し、host memory内でMLA KVの重複排除を行う。HiCache群はCP-sharded KVを採用する。両群とも各engineの目標host-cache予算は960GBである。baselineは1つの重複排除pool、HiCacheは4つのshard rankがそれぞれ240GBである。
3時間の本番トラフィック期間において、各構成はcache-tierの内訳が付与されたリクエストを約24.5K件処理した。平均入力長は136Kから137K tokenで、総入力量の差はわずか1.8%だった。結果は、CP-sharded HiCacheがL1ヒット率を42.83%から83.31%へ引き上げ、L2ヒット率を50.27%から9.62%へ低下させ、総ヒット率を約93%に維持したことを示している。同時に、平均prefill待ち時間は14.64秒から6.42秒へ、forward時間は3.15秒から2.16秒へ短縮された。
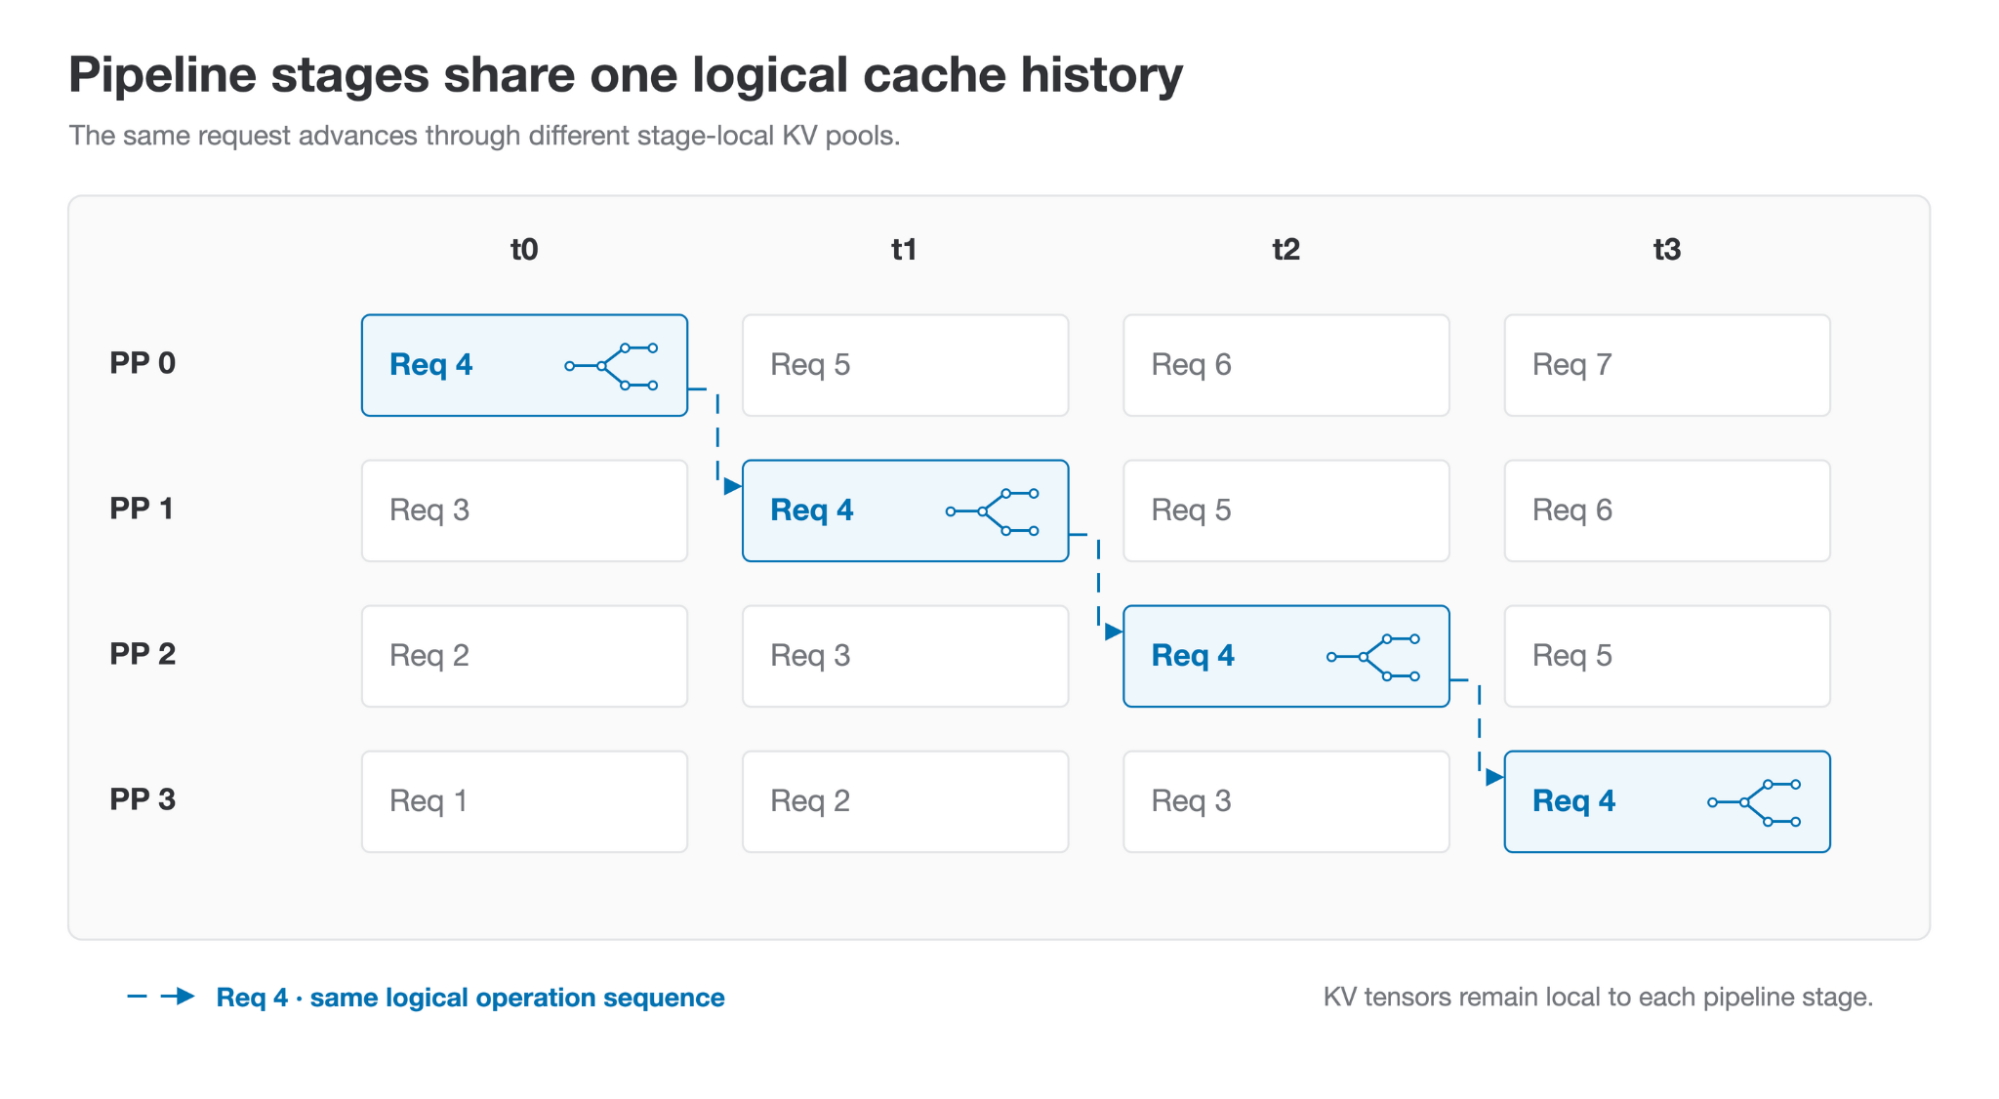
図4:CP-sharded HiCacheはGPU側のL1ヒット率を大幅に高め、prefill待ち時間とforward所要時間を短縮する。
Pipeline Parallelism:各stageに一貫したキャッシュ判断を保たせる
Pipeline Parallelismでは、モデル層が異なるstageに分割される。HiCacheの原則は、すべてのstageが同一の論理キャッシュ操作シーケンスに従う一方で、KV tensorは各stageのローカルにのみ保持する、というものだ。つまり、リクエストが異なるタイムステップでpipelineを通過する際、各stageは一貫したcache hit、restore、lock、unlock、evictionロジックを実行するが、対応するKVデータはstageをまたいで移動しない。
図5:4つのpipeline stageが連続するタイムステップで同一リクエストを処理し、各stageは同じ論理キャッシュ操作を実行するが、KVはローカルに保持される。
難点は、非同期転送の完了時刻が異なり得ることにある。PP0がAだけを消費し、PP1がAとBを消費すると、各stageのlock状態とeviction資格が分岐し、最終的にキャッシュ整合性の問題を引き起こす。HiCacheはpp_syncによって消費長を同期する。例えばPP0がn = 1を選択し、pp_syncを通じて伝達すると、PP1もAだけを消費し、Bは引き続きキューに残す。PP2はローカルのAが準備できるのを待ってから消費する。
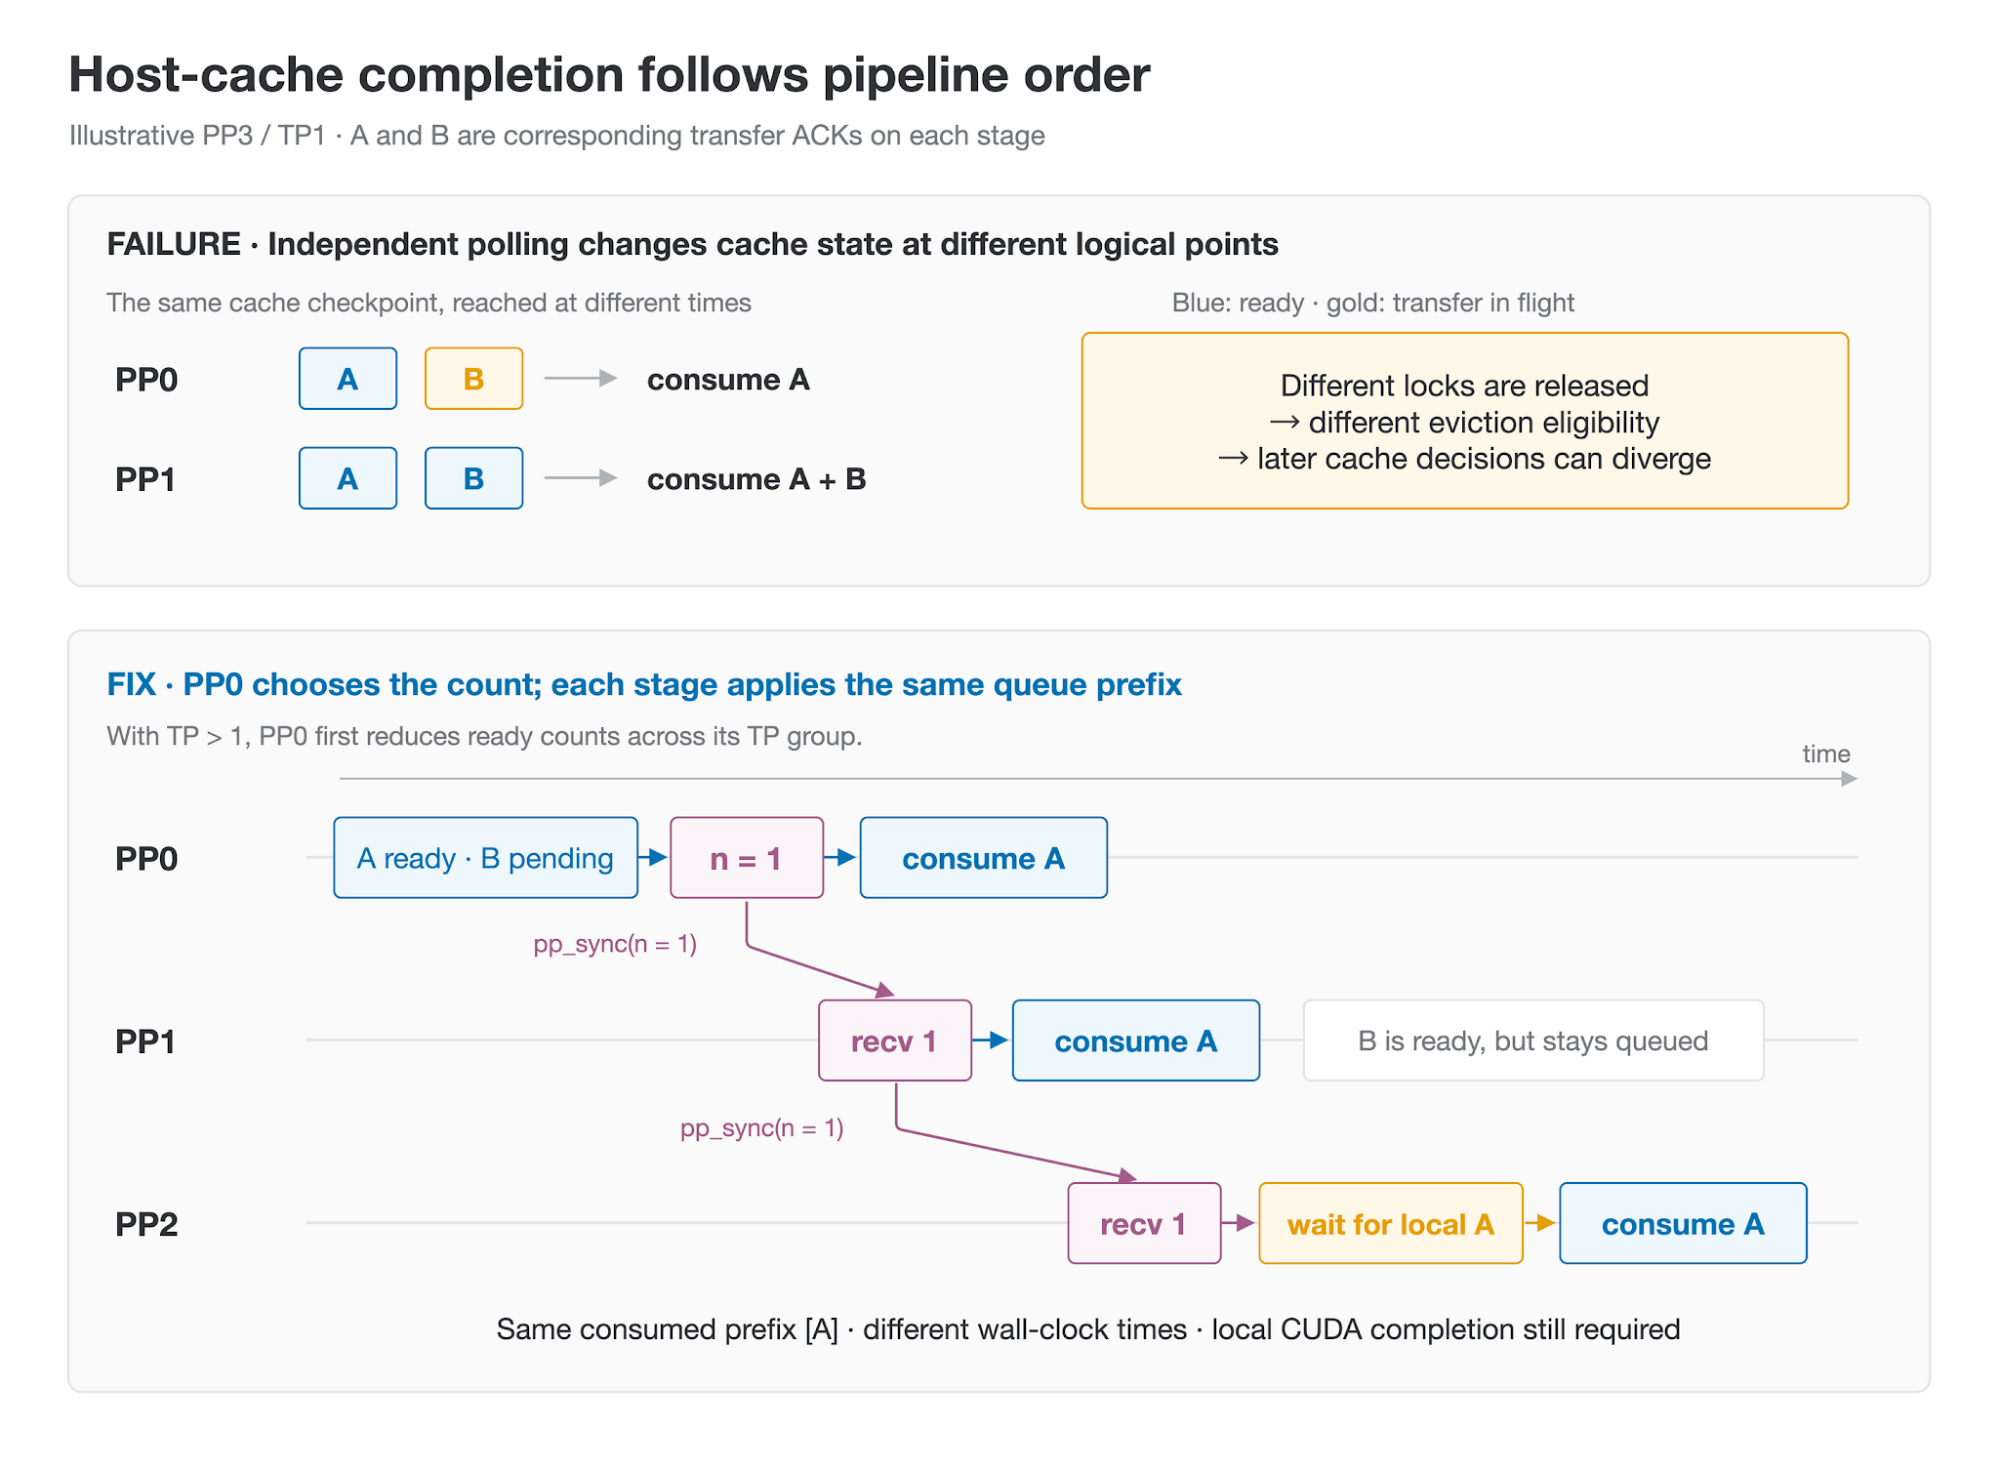
図6:異なるPP stageが異なるプレフィックスを消費すると、lockとeviction状態が分岐する。pp_syncは各stageに同じ長さを消費するよう強制する。
さらに、バックグラウンドスレッドが各rankの最小hit長と完了済み長を集計し、ACKを発行する。例えば先にACK(4)を発行し、その後ACK(6)を発行する。PP0はACK(4)を消費すると待機を停止し、PP1はpp_syncを通じてPP0に追随して同じACKを消費し、ACK(6)はキューに残す。これにより、非同期restore環境下でもpipeline各stageのキャッシュ状態の一貫性を維持できる。
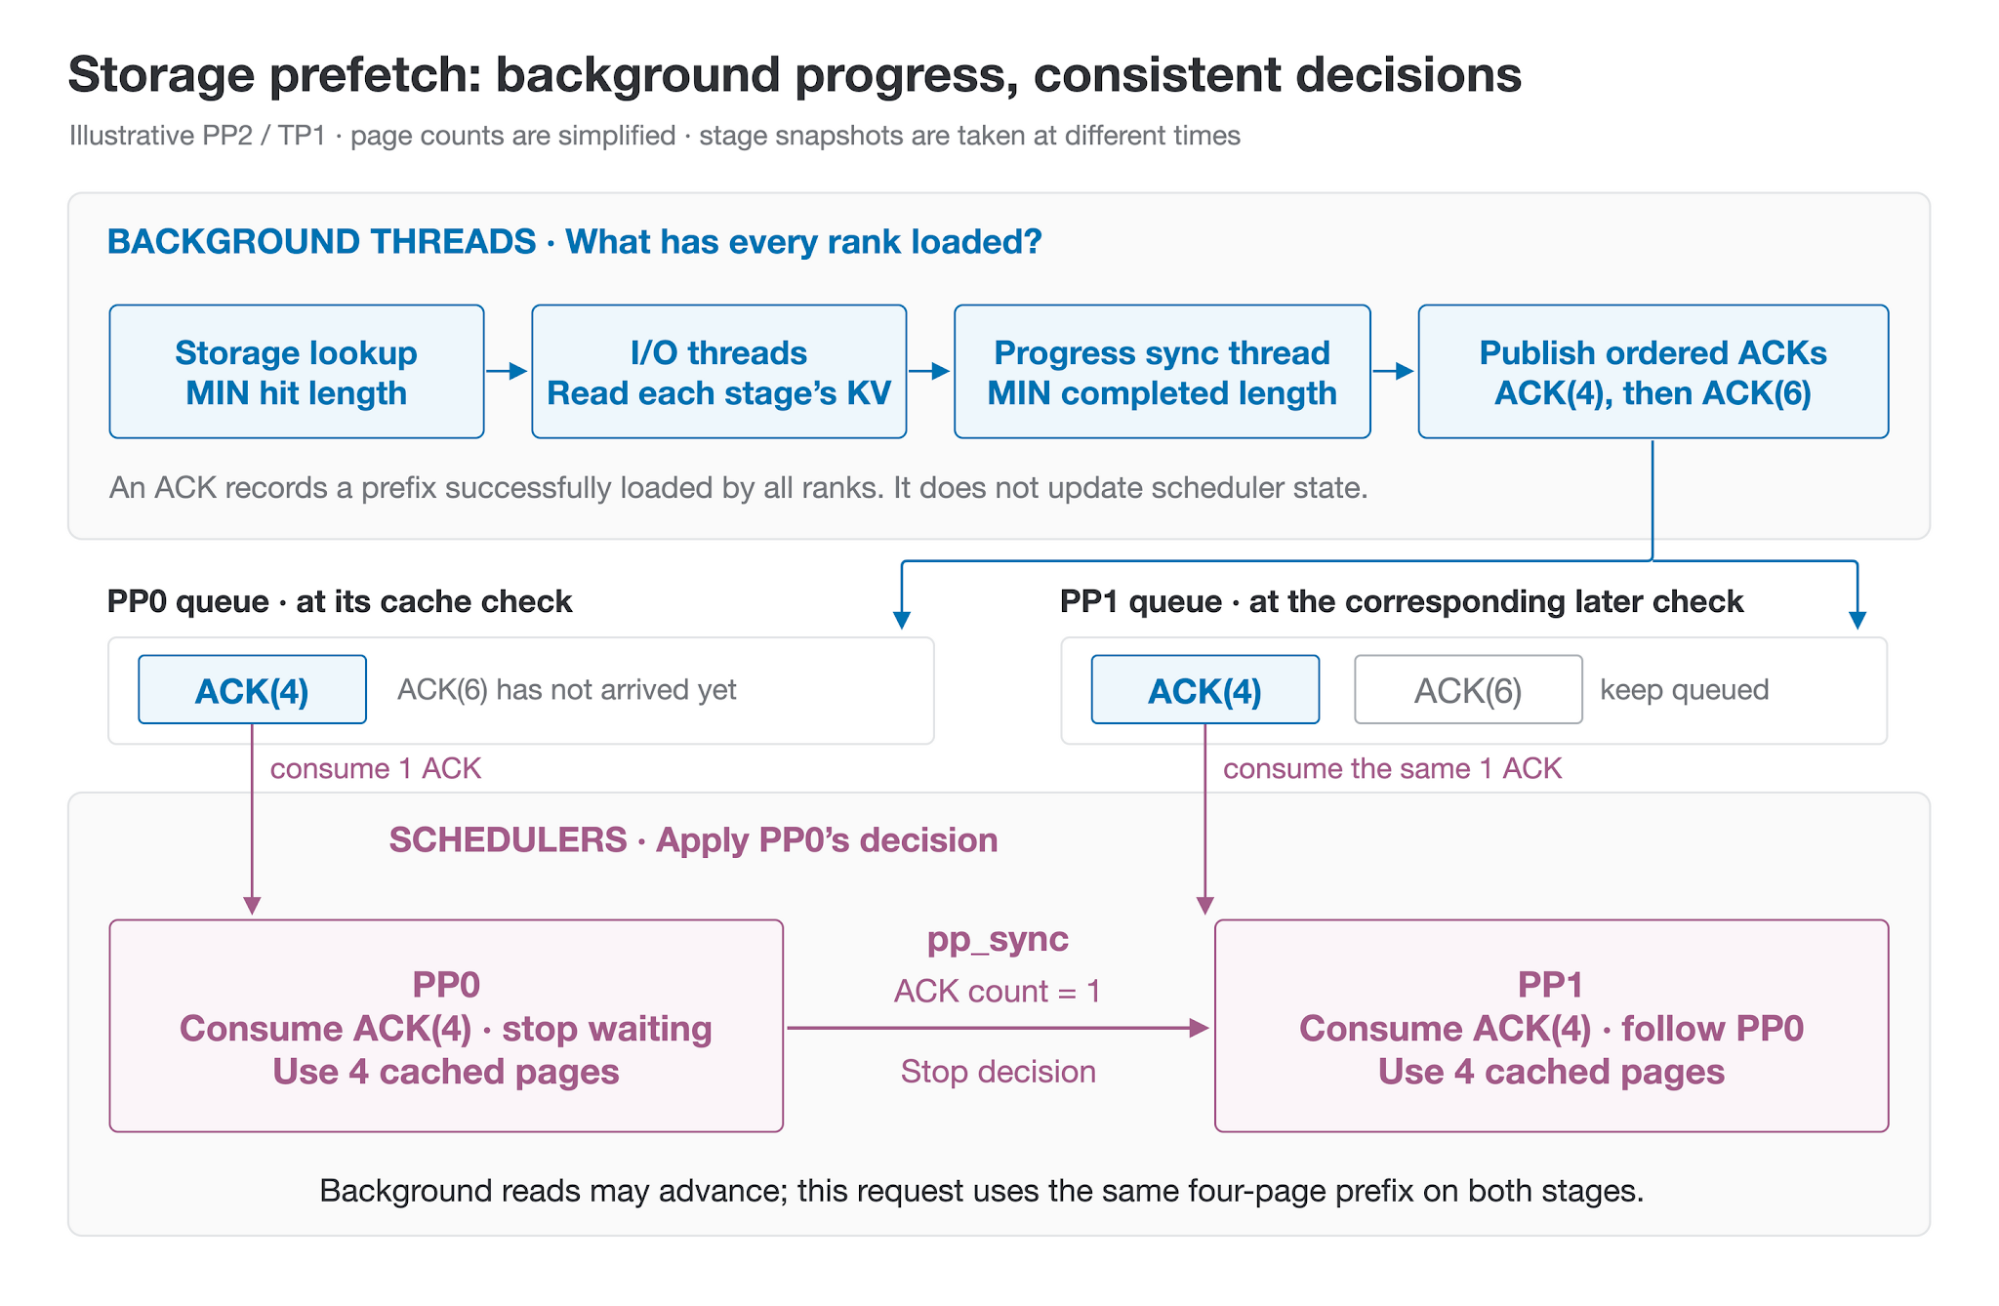
図7:バックグラウンドスレッドがACKを発行し、PP stageはpp_syncを通じて一貫した確認長を消費することで、キャッシュ判断のずれを回避する。
Speculative decoding:draftモデル状態も同時に復元する
Speculative decodingまたはMTPでは、システムはtarget modelのKV cacheだけでなく、draft model関連の状態も必要とする。そのためHiCacheは、target cacheを復元すると同時に、draftモデルに必要なcache stateも復元する必要がある。
実装上は2つのレイアウトがある。1つ目はpacked integrationで、draft layersをtarget KVとindexer host poolsの後ろに追加し、統一poolを形成する。2つ目はsidecar integrationで、draftは独立poolを使用するが、target KVのインデックス関係を継承する。どちらの方式でもhost slots 7、12、19をGPU slots 42、8、27へ復元でき、違いはdraft状態をどのように編成し、アドレス指定するかにある。
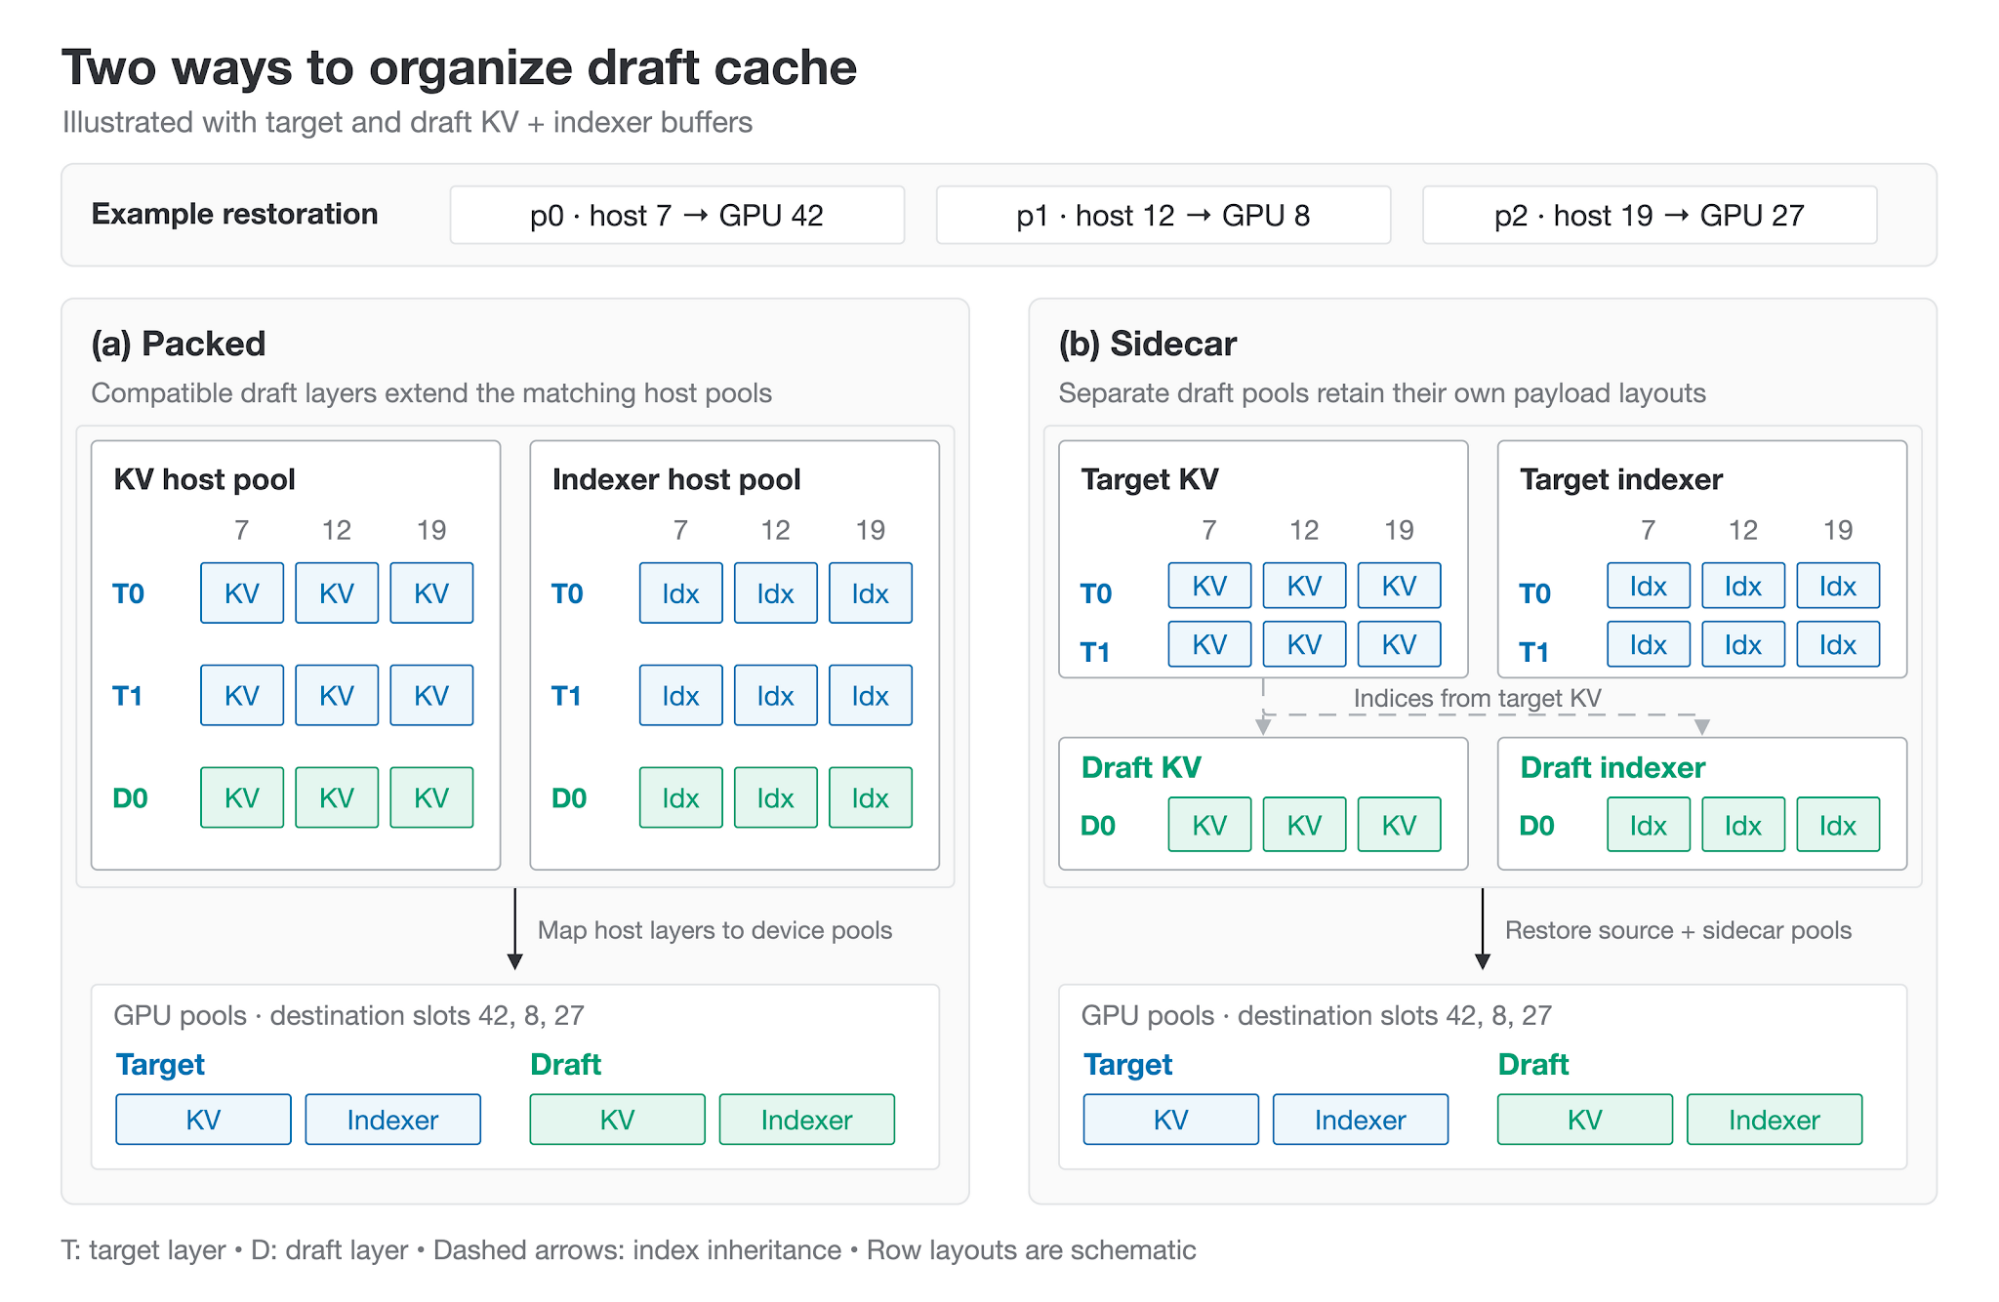
図8:draft cache stateにはpackedまたはsidecarレイアウトを採用でき、どちらもtarget cacheとともに復元できる。
統一KVレイアウト:並列構成をまたいでキャッシュを共有する
本番環境では、異なるworkerが異なるTP/PP構成を使用することがある。HiCacheは統一KV layoutによって、外部ストレージ内のKVを、互換性のある並列構成から読み取れるオブジェクトとして編成し、deployment形態の変化によるcache失効を減らす。
例えば、TP4/PP2 writerは各rankのKVセグメントを8つの共有L3オブジェクトとして書き込む。TP2/PP1 readerが読み取る際には、一度に4つのchunkを組み立てられる。拡張後のオブジェクトは、layers 30–59におけるheads 4–5のKとVを連続したrangeとして編成するため、異なる並列分割方式が互換条件下で同一の保存KVを再利用できる。
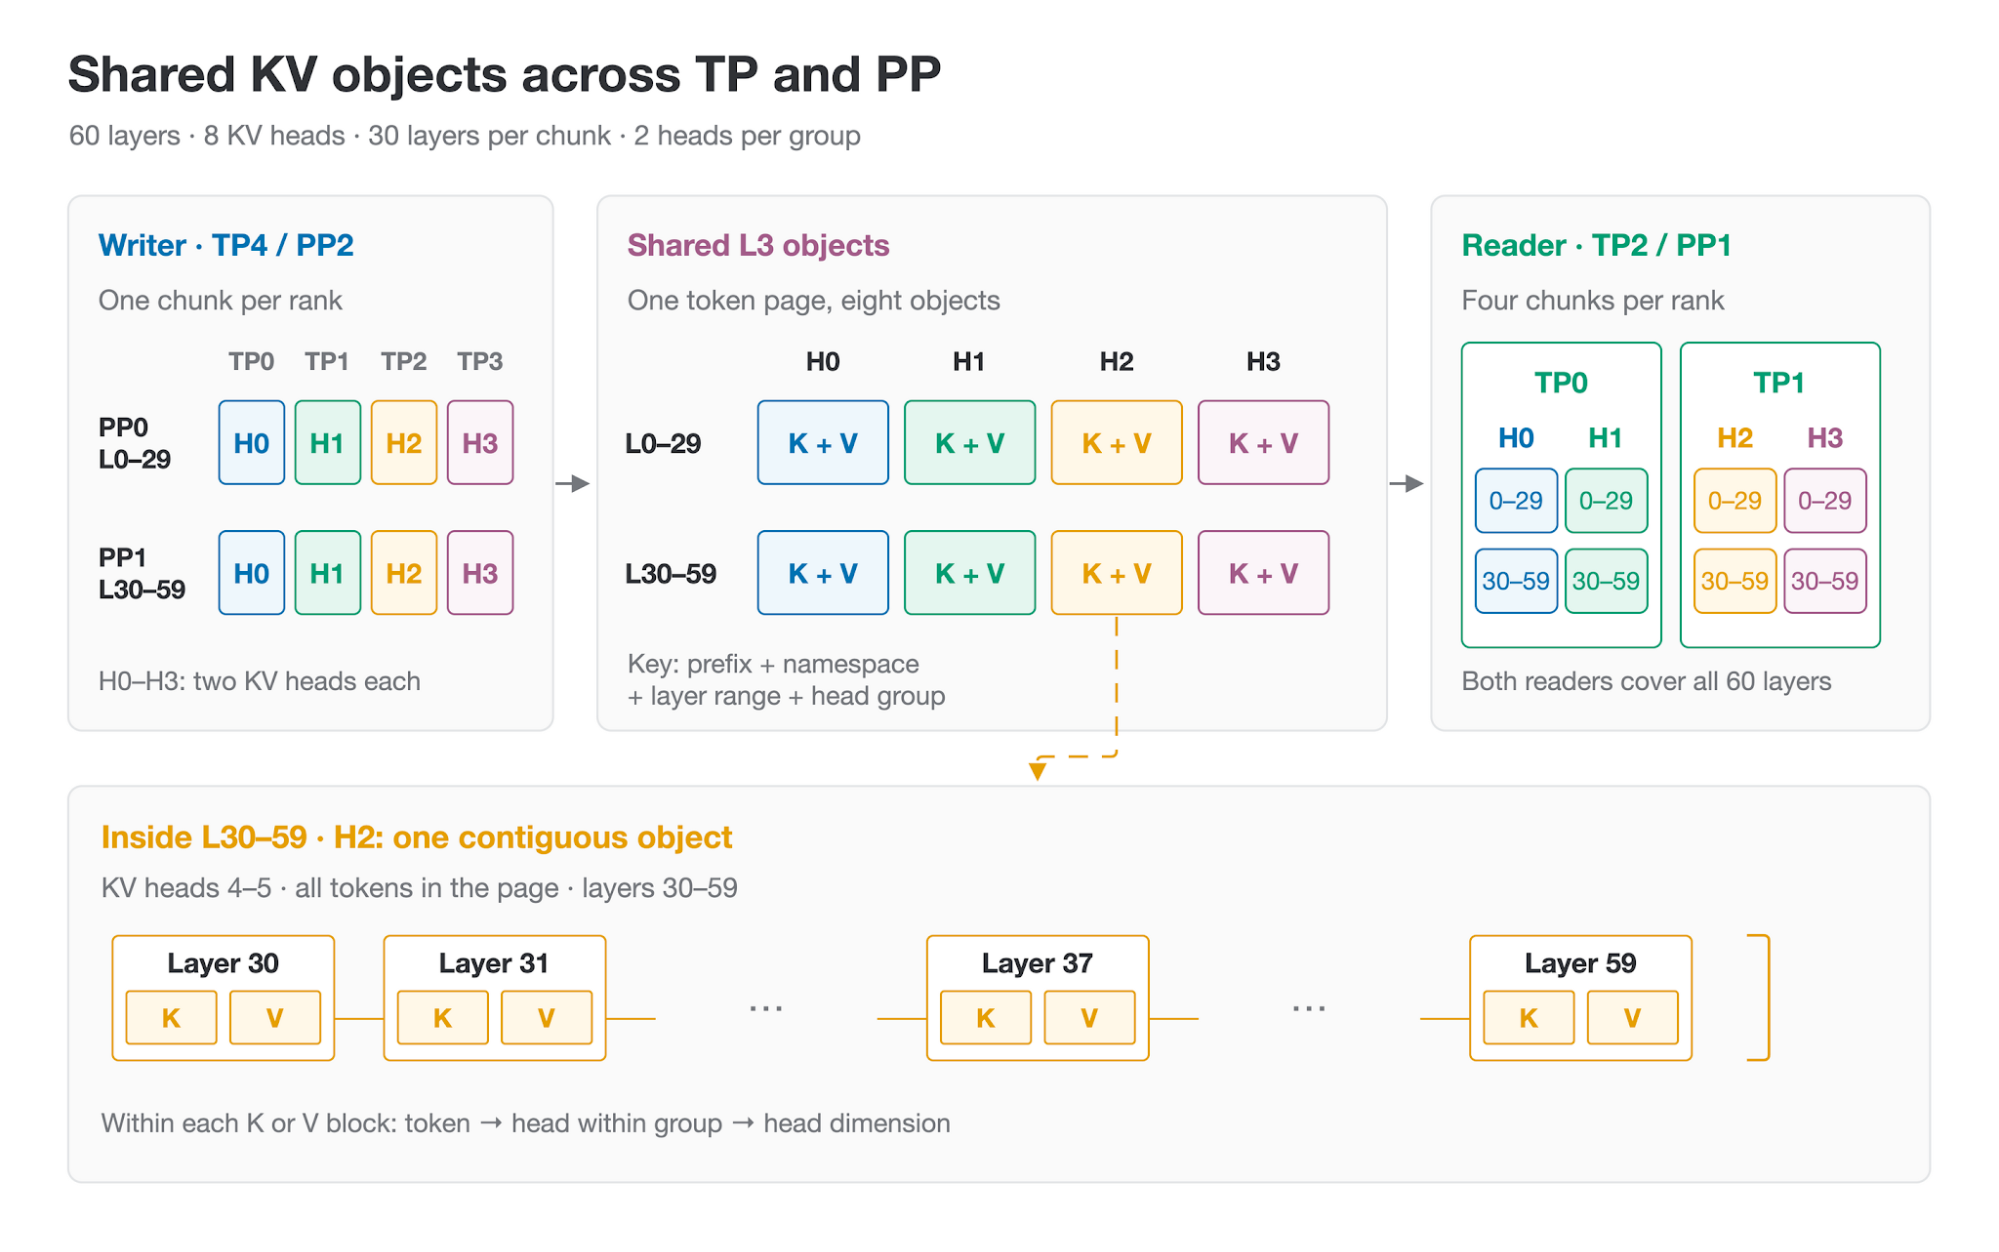
図9:統一KV layoutはTP4/PP2による書き込み、TP2/PP1による読み取りをサポートし、互換構成間で外部KVオブジェクトを共有する。
Prefill-decode disaggregation:欠落KVだけを転送する
P/D分離アーキテクチャでは、prefill workerがprefill KVの計算を担当し、decode workerが後続の生成を担当する。decode側がすでにプレフィックスの一部を保持している場合、HiCacheはdecodeローカルキャッシュを優先的に再利用する。これにはGPU resident cacheとhost cacheが含まれ、prefill側はP/Dリンクを通じて欠落したサフィックスだけを転送すればよい。
12K-token promptを例にすると、3つの4K spanに分割できる。Aはすでにdecode GPU上にあり、Bはdecode host poolから復元可能で、欠落しているCだけをprefill workerからP/Dリンクをまたいで転送する必要がある。これによりネットワーク転送を削減できるだけでなく、prefillからdecodeへの受け渡し遅延も低減できる。
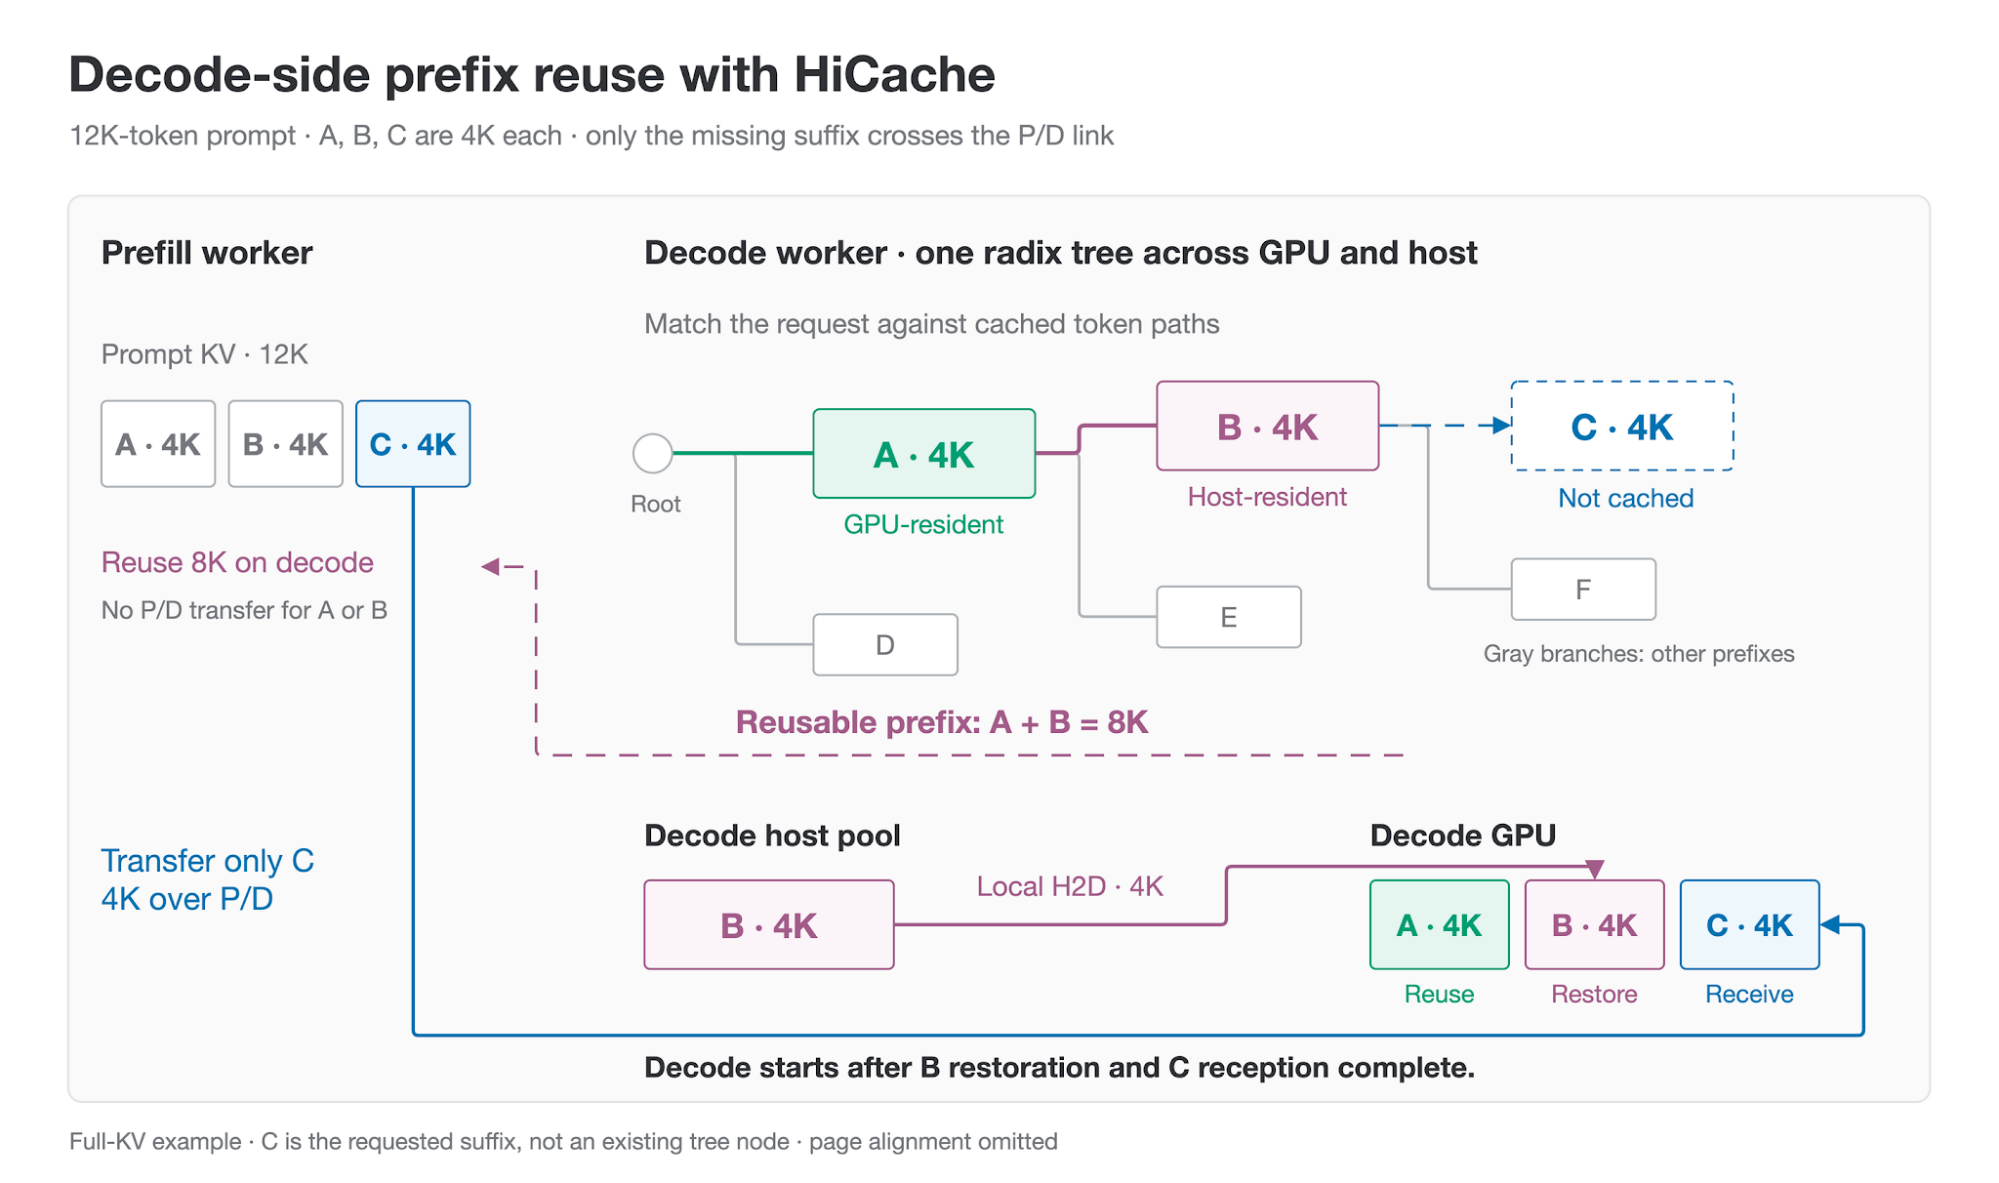
図10:P/D分離下では、decode側がローカルプレフィックスを優先的に再利用し、prefillは欠落したKVサフィックスだけを転送する。
デバッグ:rank_consensus_checkerで不一致を特定する
多並列システムで最も調査が難しい問題は、単一rankの失敗ではなく、異なるrankがキャッシュ状態について異なる判断をしていることに起因する場合が多い。HiCacheはrank_consensus_checkerを提供し、この種の問題を特定する。対象には、hit lengthの不一致、restore完了状態の不一致、lock/unlock順序の不一致、eviction資格の分岐、PP ACK消費の不一致などが含まれる。
全体として、HiCacheは単一マシンのRadix cacheを、本番分散推論向けの多層キャッシュシステムへ拡張する。GPU、host memory、外部ストレージの間でKVを移動しながら、CP、PP、Speculative decoding、P/D分離下での論理的一貫性を維持する。長コンテキストのAgenticアプリケーションにとって、この能力はより高いヒット率、より低いTTFT、より安定したサービスコストへ直接つながる。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接