
オンライン推論サービスの負荷は絶えず変化するため、スループットとレイテンシの目標を損なわずに容量を調整することが求められる。大規模なMixture-of-Experts(MoE)モデルに対する従来の選択肢は主に二つあった。一つは水平スケーリング(完全なモデル副本を追加する方法)、もう一つは垂直スケーリング(より幅広いexpert-parallelトポロジでデプロイを再起動する方法)である。
水平スケーリングは現在のサービスを中断しないという利点があるが、モデル全体をもう一セット用意するコストがかかる。垂直スケーリングは小さな増分で目標トポロジに到達できるが、分散状態の再構築、モデルの再ロード、ウォームアップが必要になる。SGLangが今回提案するElastic EP scale-upは第三の道を選ぶ:実行中のMoEデプロイメントに直接新しいGPUランクを追加するアプローチだ。
本記事の例では、20GPU構成のデプロイメントが既存のジョブを置き換えることも、新たな20GPU副本を作成することもなく、4つのランクを直接追加して24GPUへ拡張する。
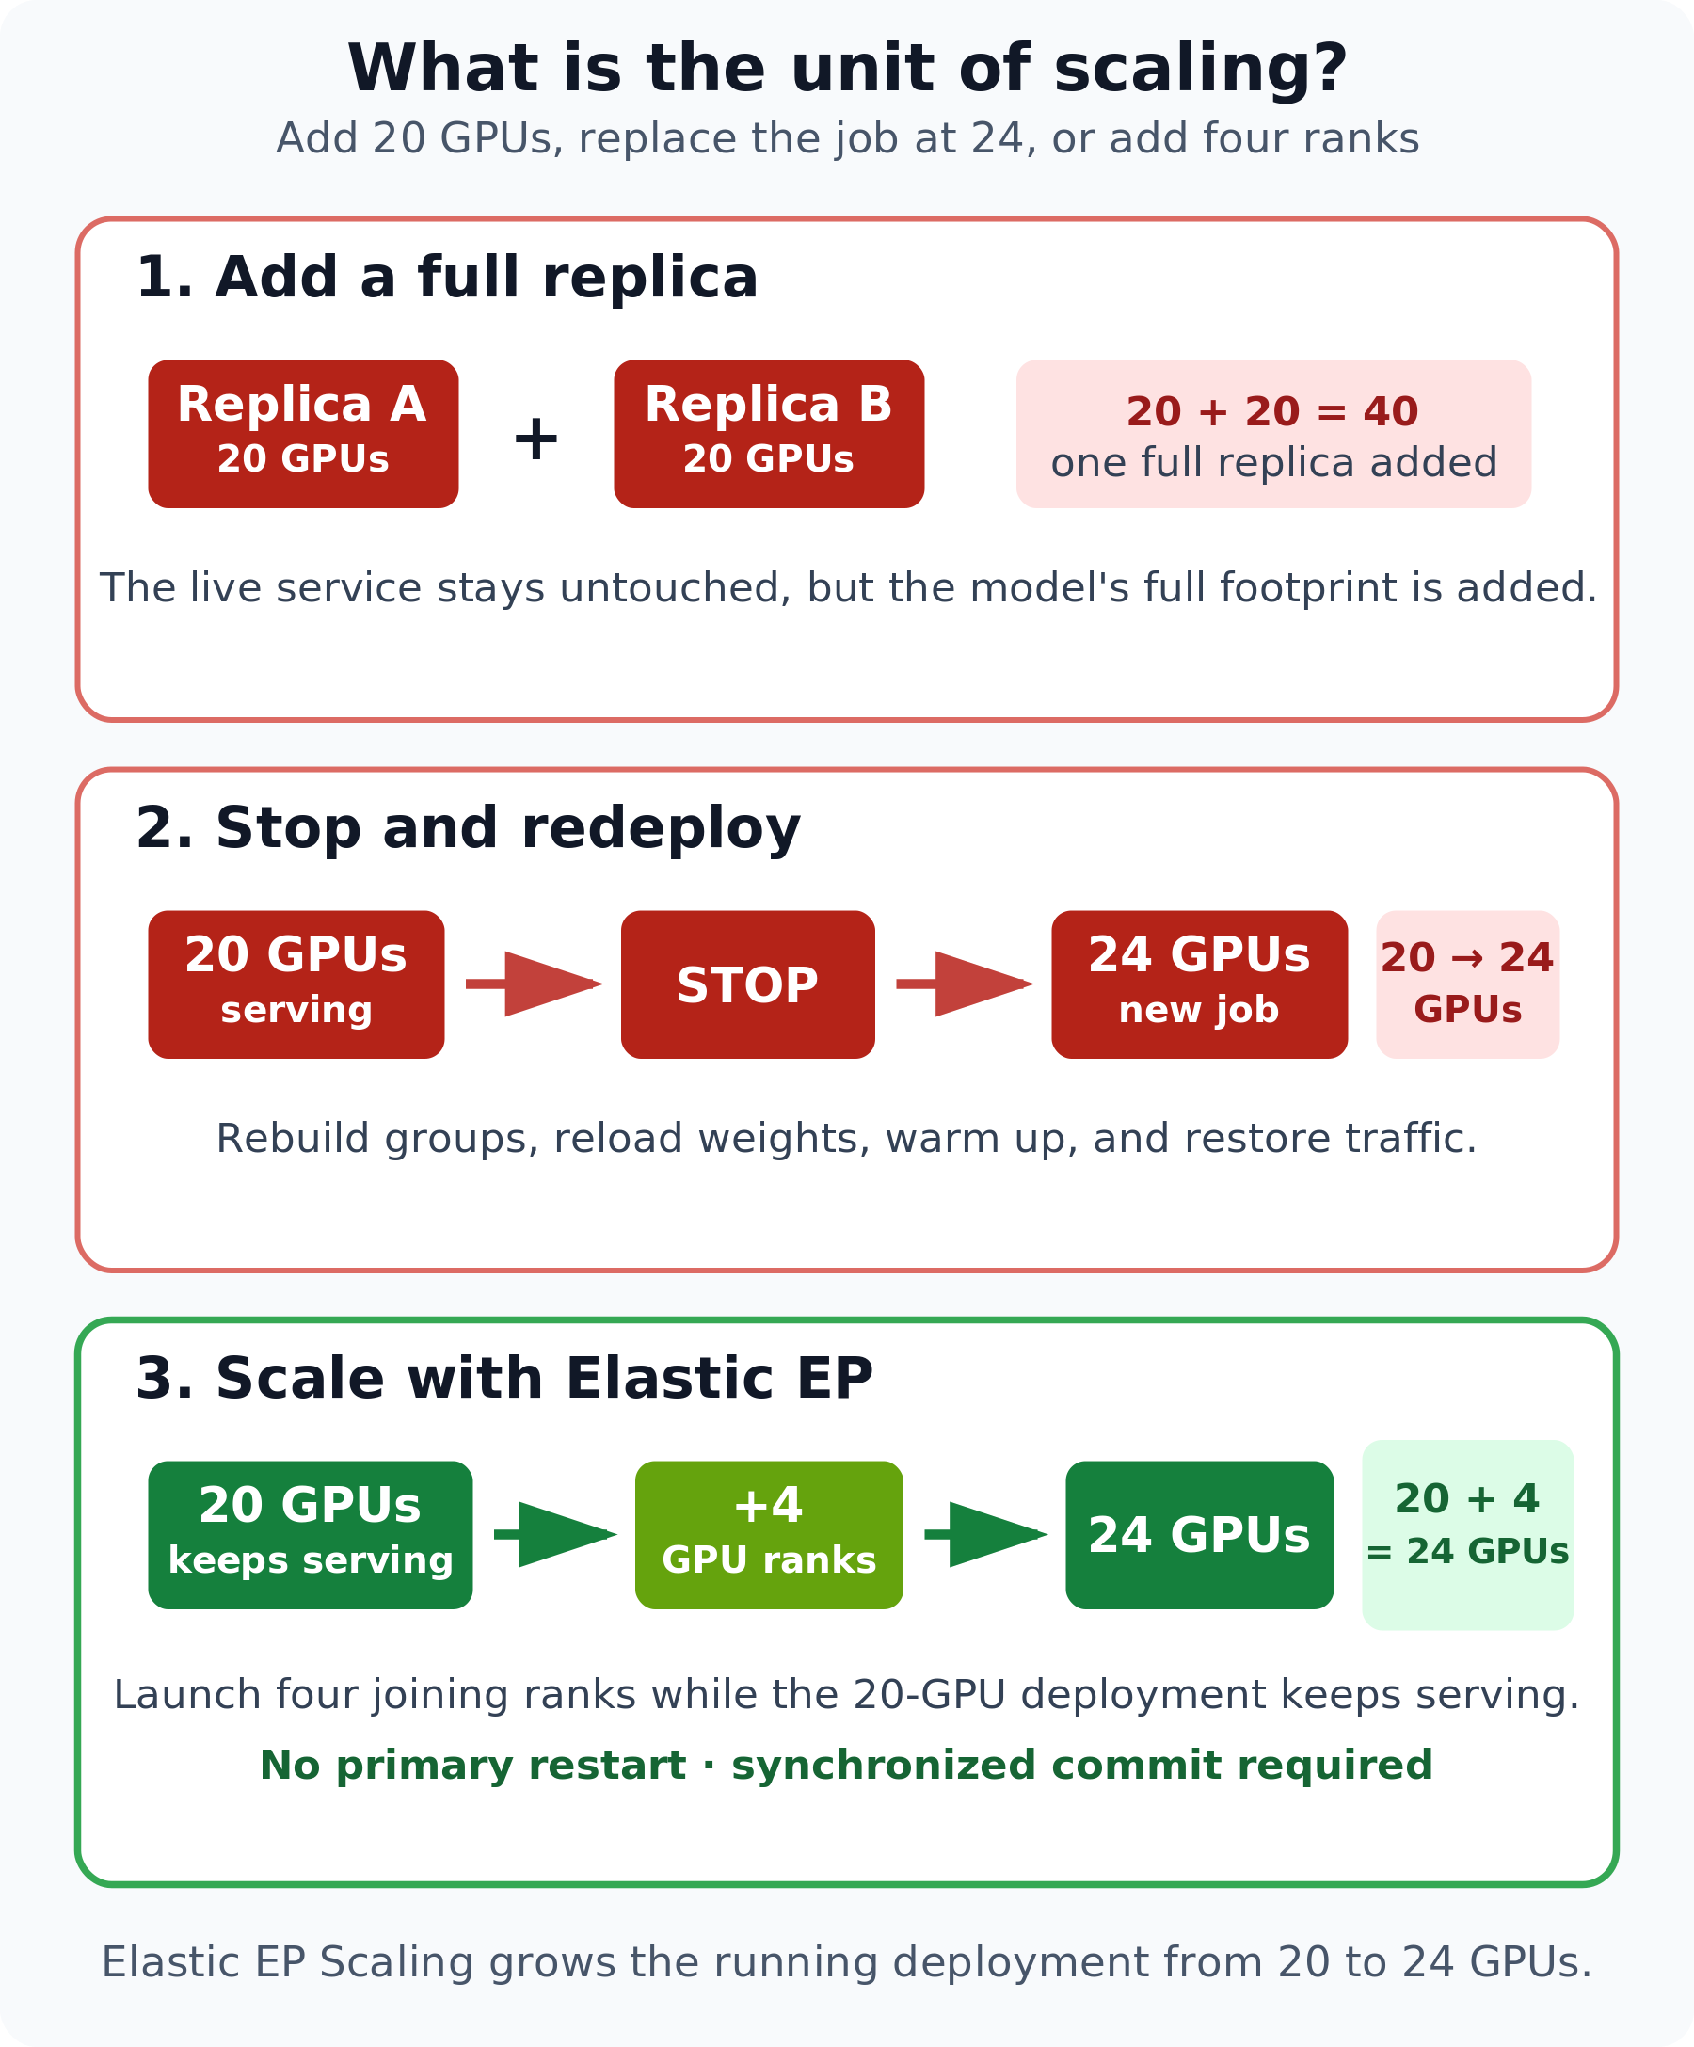
図1:20→24GPUの比較概要。Elastic EP Scalingは、別の20GPU副本を割り当てたりジョブ全体を置き換えたりせず、実行中のデプロイメントに4つのランクを追加する。
主要な結論
- Elastic EP scale-upにより、MoEモデルはより細かい粒度でGPUを追加でき、完全な副本のデプロイも現在のサービスの再起動も不要になる。
max_ep_sizeはデプロイメントが拡張可能な最大EPトポロジを定義する。システムは起動時にメタデータと通信バッファの容量を予約するが、追加のGPUランクは必要になった時点でのみ起動される。- 比較テストでは、Elastic EP Scalingは再起動と比べて最初のリクエスト完了までの速度が5.3×〜8.2×速い。
スケールアップ機構が障害回復機能を再利用する仕組み
MoEの各forwardパスにおいて、トークンのアクティベーションは選択されたexpertを保持するランクに送信され、expertの出力が元のランクに返される。SGLangの大規模EPに関する以前の取り組みで、expert dispatchパスが高並行・長コンテキストサービスにとって極めて重要であることが示されている。Data Parallel(DP)attentionを採用する場合、各論理DPワーカーは独自のスケジューラとKVキャッシュを保持し、expert layersはEPトポロジをまたいで通信する。
ランタイムスケールアップはSGLangのElastic EP failure-recovery機構の上に直接構築されている。両者ともactive/inactive メンバーシップ、Mooncake Process Group(Mooncake PG)のアドミッション、およびforward終了時のtransition hookに依存している。違いは、障害回復は特定のランクを既存のスロットと元のプロセスグループに戻す操作であるのに対し、スケールアップはactive_ranksベクターにおいて最大規模のために予約された末尾の空スロットを有効化し、新しく参加するランクを受け入れる操作である。
この設計には重要な制約がある:起動時に作成されるプロセスグループは静的である。そのため、元のランクと新たに参加する各グループは、固定されたTensor Parallel(TP)とbootstrapグループを保持しなければならない。その上に、MooncakeのWORLDと論理EPメンバーシップが継続的に拡張される。
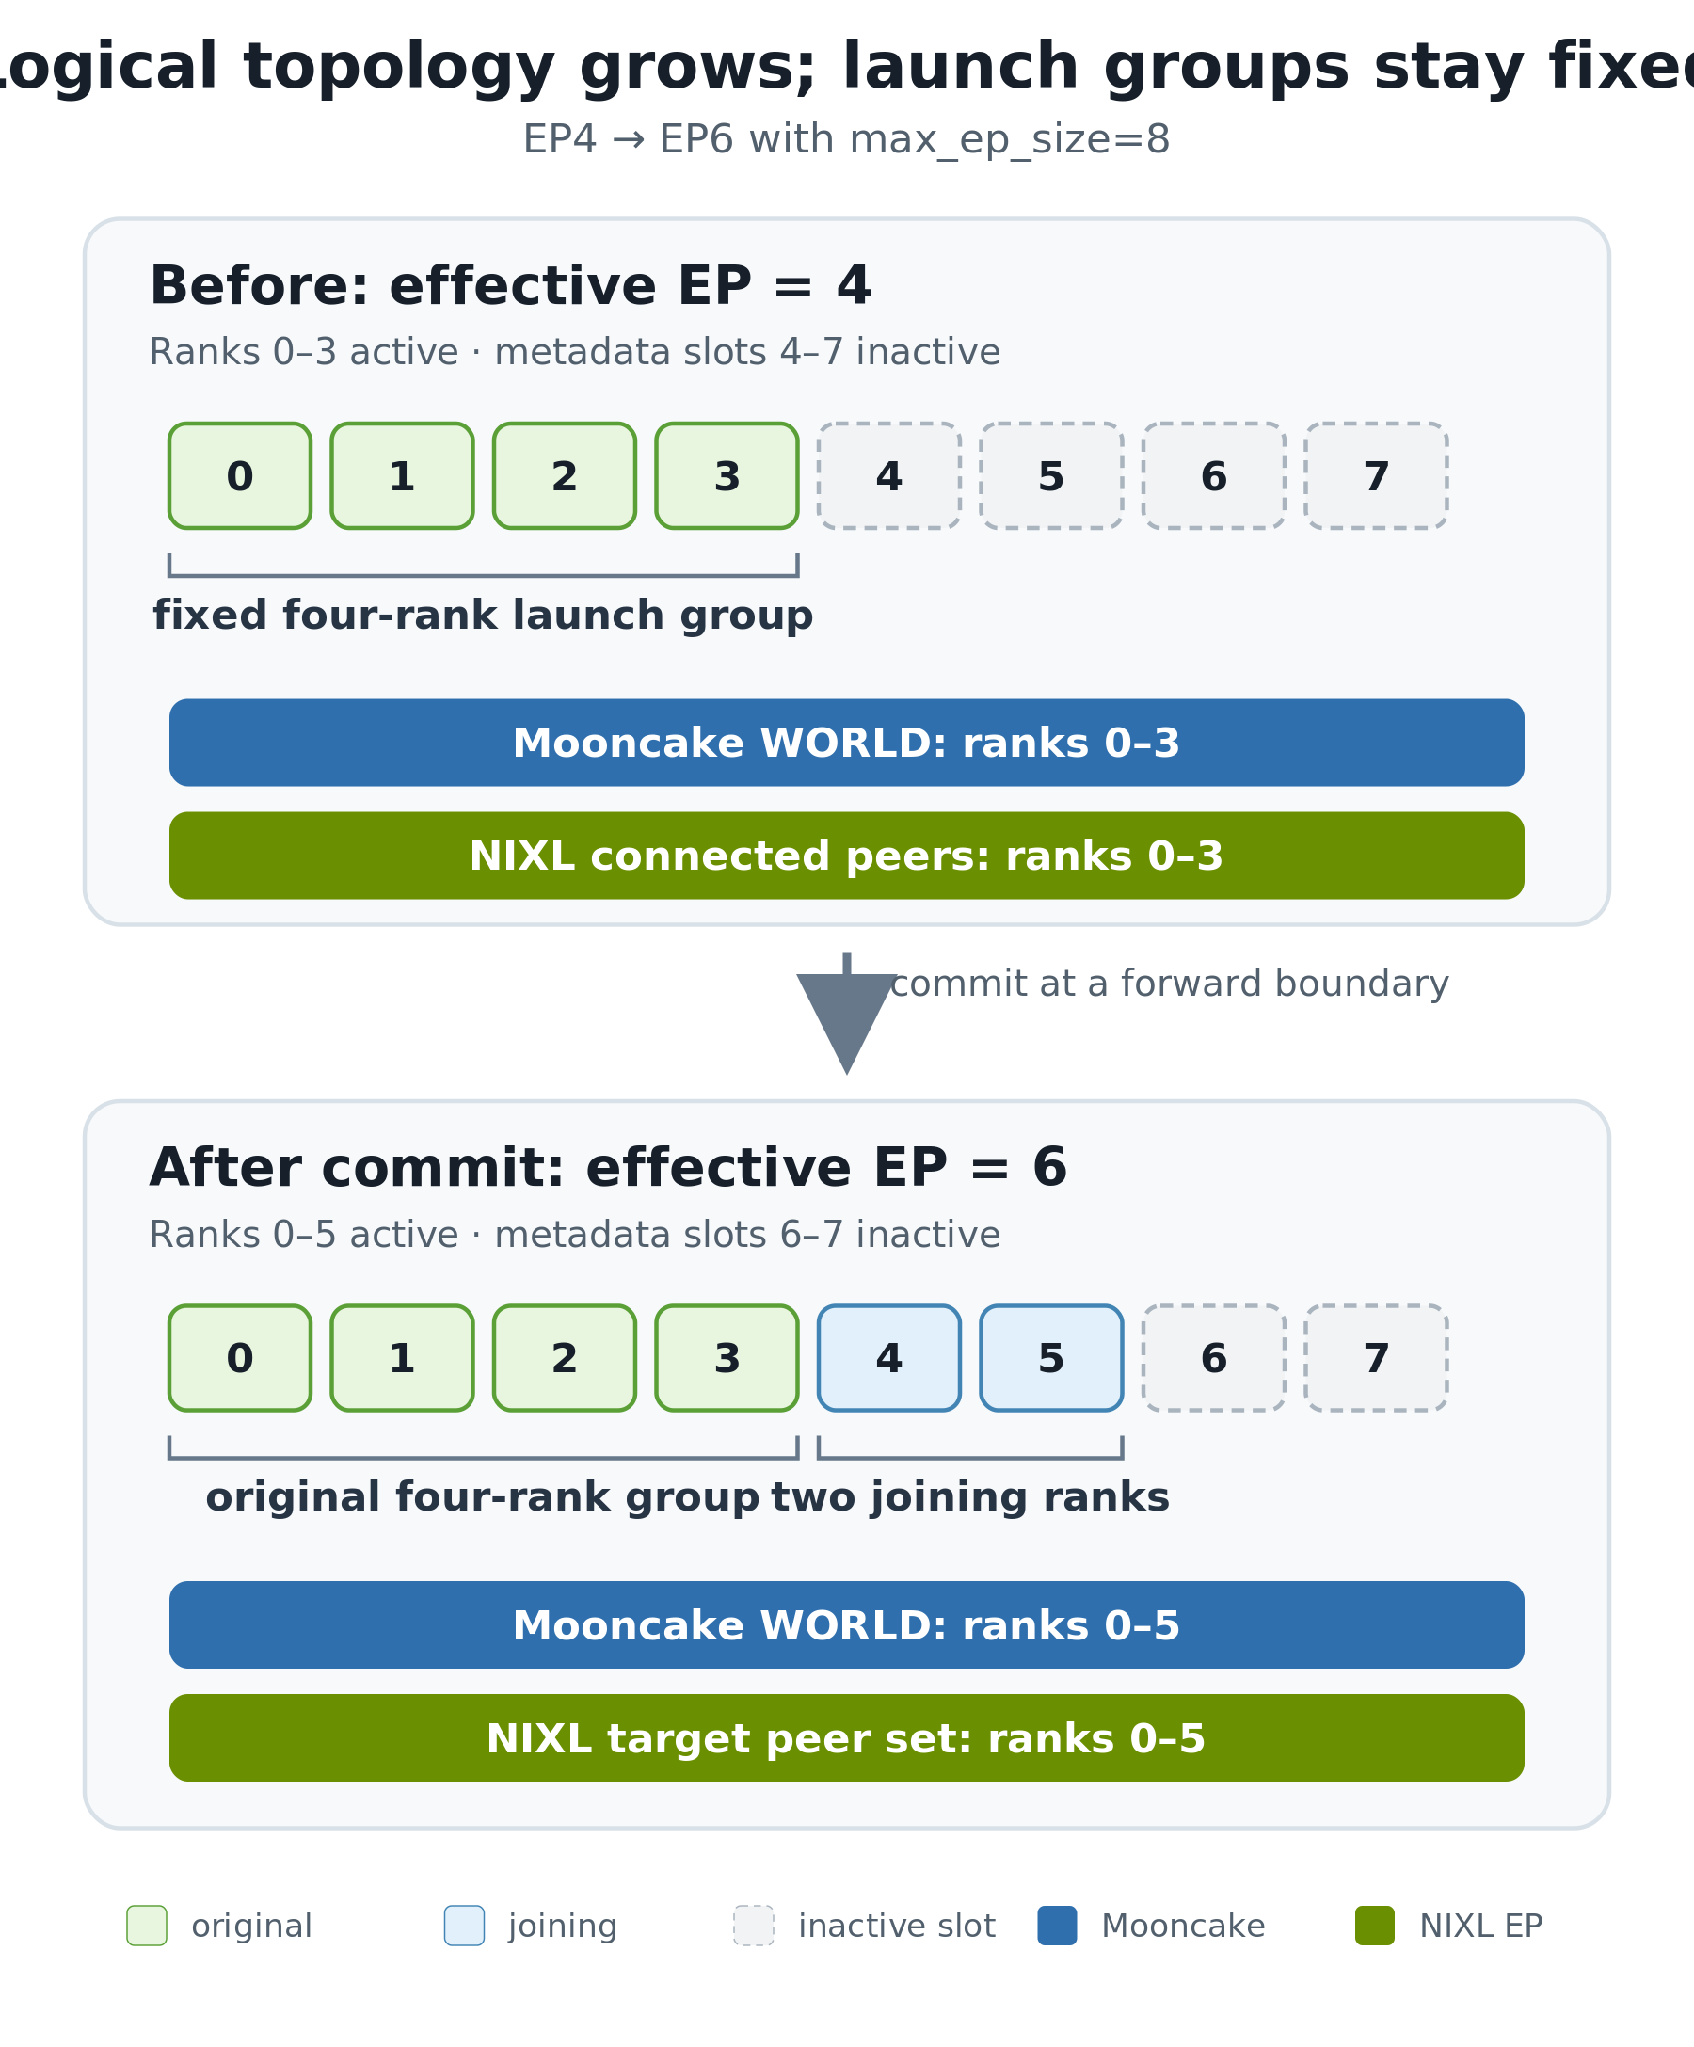
図2:EP4→EP6への拡張時、元の4ランクのlaunchグループは変化せず、2つの新しいランクがMooncake WORLDに参加し、NIXLのターゲットピアセットが拡張される。
一つの論理デプロイメント、三層の協調
1. SGLangがserving control planeを担当
SGLangは参加リクエストを待機するランクを待ち、pending_ep_sizeとeffective_ep_sizeをそれぞれ追跡し、forwardの終了時に目標のexpertおよびDP状態をインストールし、コミット後にのみ新しいschedulerスロットを公開する。
2. Mooncake PGがエラスティックメンバーシップと同期を担当
Mooncake PGの拡張可能なWORLDは参加者を受け入れ、既存ランクと新規ランクにまたがるバリアを提供する。SGLangはまた、スケールアップ後にEPLBを調整するためにMooncake PGのcollectivesとP2Pを利用する。
3. NIXLがexpert data planeを提供
NIXL EPは各MoE forwardにおいてトークンのアクティベーションの配信とexpert出力のマージを担当する。SGLangのインテグレーションはNIXL dispatcherに位置する。EPグループが拡大するにつれ、NIXLは既存のピア接続を保持する:例えばEP4→EP6の場合、元のランクは既存の接続を保持しつつランク4と5を新たに追加し、新しく参加したランクはEP6のピアセット全体に接続する。
SGLangは起動時にmax_ep_sizeに基づいてNIXLのメタデータとRDMAバッファを設定するが、初期段階ではアクティブなランクにのみ接続する。接続は遅延完了(lazy)方式で行われるため、より広いトポロジでの最初のdispatchには部分的な接続確立のオーバーヘッドが含まれる場合がある。
max_ep_sizeはデプロイメントが到達すると想定される最大トポロジに設定すべきである。上限が高いほど、アクティブなGPU上に予約される通信バッファのメモリが増え、KVキャッシュに使用可能なメモリが減少する。
実行中のEPグループの拡大方法
SGLangのオンラインスケールアップのフローは4ステップに集約される:
- 上限の予約。プライマリは
max_ep_sizeを通じてメタデータと通信バッファの容量を割り当てる。非アクティブなスロットはプロセスを起動せず、GPUも消費しない。 - 参加ランクの起動。外部オーケストレータがGPUを割り当て新しいランクを起動する間、既存のEPグループはサービスを継続する。
- アドミッションとコミット。SGLangは目標のランク範囲全体が揃うのを待ち、Mooncakeの
WORLDを拡張し、目標のアクティブランク・expert・DP・NIXL状態をインストールして全ランクを同期する。CUDAグラフが有効な場合、各ランクは新しい規模をコミットする前に拡張後のトポロジ用にグラフを再キャプチャする。これを経て初めてcommit_scale()がeffective sizeを更新する。 - ルーティングと再バランス。Data Parallel Controllerが新しい論理ワーカーを公開する。NIXLがより広い範囲での最初のexpert dispatchを実行し、その後EPLBがexpertを再分配できる。
注意すべき点として、参加ランクがMooncakeのWORLDに参加した後は、現時点では自動ロールバックをサポートしていない。finalization段階で失敗した場合、デプロイメントの再起動が必要になる可能性がある。
スケールアップ切り替えの実測結果
著者は8×H100上でDeepSeek-V3-Lite FP8を使用し、Elastic EP Scalingと再起動方式を比較した。Elastic EP Scalingのシナリオでは新しく参加するランクがバックグラウンドで初期化される間、既存のデプロイメントはサービスを継続する。再起動方式の計測は元のデプロイメントが終了される前から開始される。
複数回のElasticの実行において、すべてのtransitionが正常に完了し、スケールアップ後のGSM8K検証もパスした。図3はElasticの平均所要時間を示し、同一のCUDAグラフキャプチャ範囲を使用した再起動ベースラインと比較している。
テストの終点はreadiness後に発行された短いcanaryリクエストである。Elasticのreadinessは/is_scaling_elastic_epが目標規模のserving_expandedを返すことで判定し、再起動のreadinessは/health_generateがHTTP 200を返すことで判定する。Elasticのcanaryは新しい論理DPランクに転送され、再起動方式はround-robinルーティングを使用する。
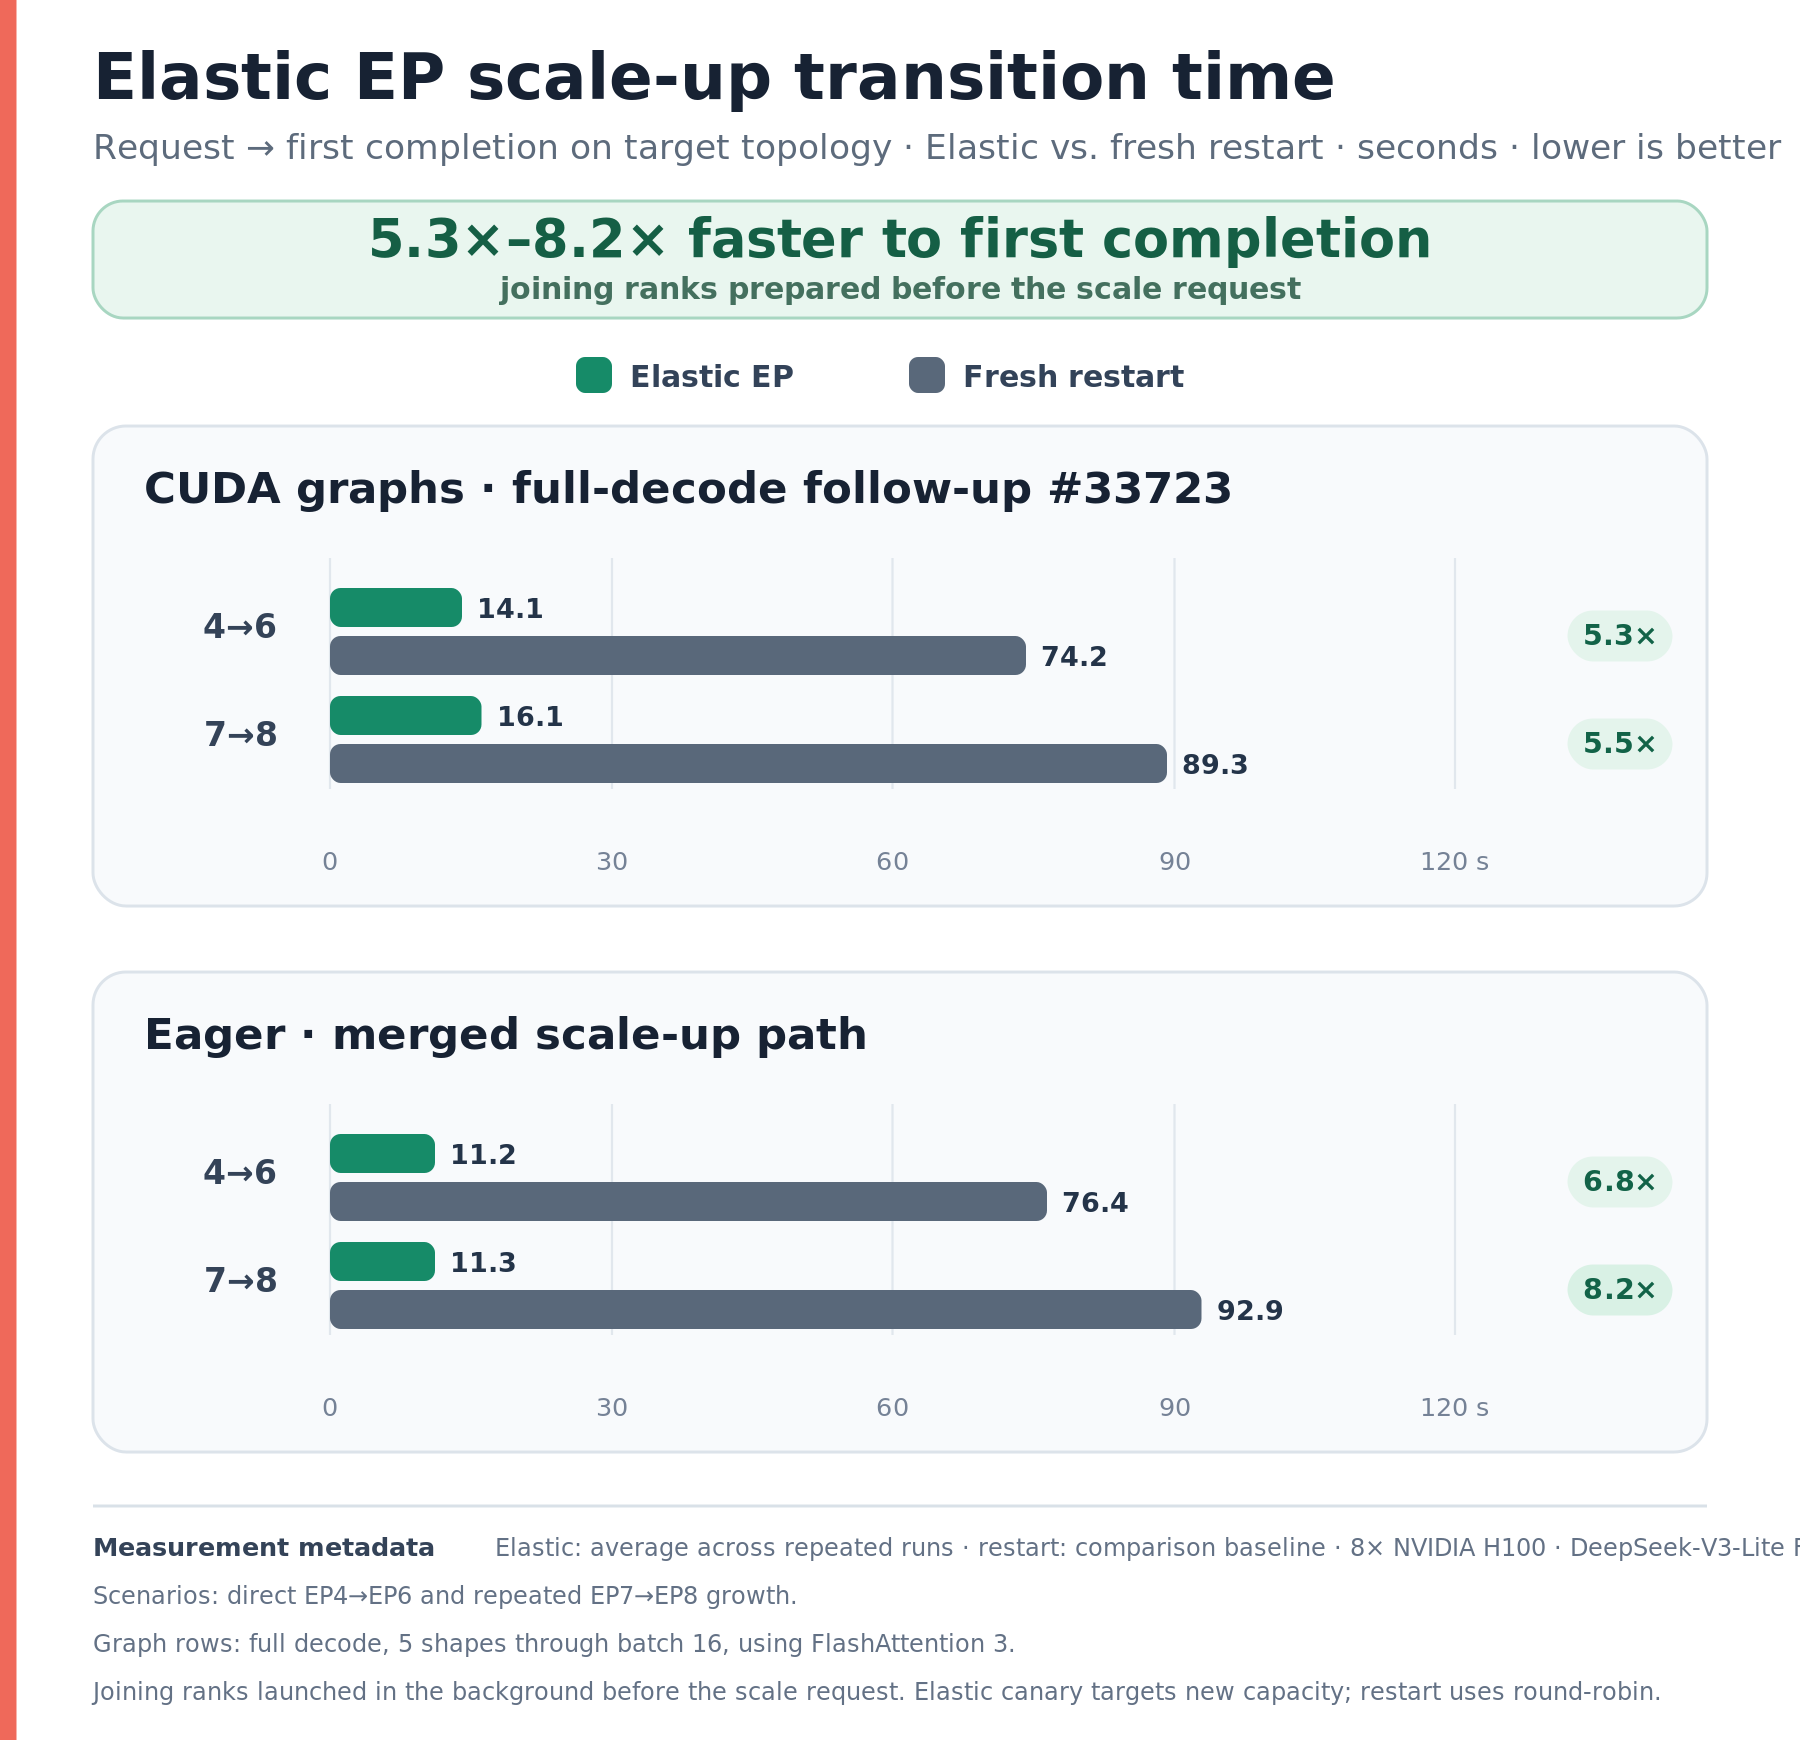
図3:スケールアップまたは再起動リクエスト発行から目標トポロジ上での最初のリクエスト完了までの時間。Elasticの棒グラフは複数回の実行の平均値、restartの棒グラフは比較ベースライン。CUDAグラフ行はバッチ16以内の5つのfull-decode shapeをキャプチャしている。
トポロジ切り替え中はトークンの配信が一時停止される。図3の統計範囲はスケールリクエストから拡張デプロイメント上での最初のリクエスト完了までの全過程をカバーしており、初回使用時に発生しうる接続確立のオーバーヘッドも含まれている。全体として、Elastic EP Scalingは再起動と比べて最初のリクエスト完了までの速度が5.3×〜8.2×速い。
ロードマップと現在の状況
| フェーズ | 機能 | 2026年10月4日時点のステータス |
|---|---|---|
| 1/N | Runtime eager EP scale-up | マージ済み、PR #30164 |
| 2/N | Scale-up後のEPLB | マージ済み、PR #30553 |
| 3/N | Full-decode CUDAグラフ再キャプチャ | マージ済み、PR #33723 |
| 4/N | DP-attentionシャード粒度でのスケールアップ | マージ済み、PR #33728 |
| Later | Scale-downとgrow-back | レビュー中、PR #33111 |
| Later | Fully idle progress | 計画中 |
| Later | Scale-up後のリカバリ | 計画中 |
Scale-up後のEPLB
スケールアップのコミット後、SGLangは拡張後のトポロジ上で既存のEPLB reshuffleを再開し、新たに参加したランクにもexpertが割り当てられるようにする。
CUDAグラフの再キャプチャ
EP4でキャプチャされたグラフはトポロジに依存した状態を含んでいるため、EP6上でそのまま再生することはできない。当初のスケールアップパスはeager executionをサポートしていたが、PR #33723のマージにより、SGLangはコミット前に拡張後のトポロジ用のfull-decode CUDAグラフを再キャプチャできるようになった。ただし、prefillとpiecewise recaptureはまだサポートされていない。
256件のGSM8Kサンプルと50リクエストスレッドを使用した複数回の実行において、スケールアップ後の平均出力スループットは以下の通りである:
| Transition | Eager | Full-decode CUDAグラフ |
|---|---|---|
| EP4→EP6 | 371 tok/s | 1,241 tok/s |
| EP7→EP8 | 358 tok/s | 1,120 tok/s |
この設定において、full-decode CUDAグラフの平均出力スループットはeager executionと比べて3.1×〜3.3×高い。
マルチランクDP-attentionシャード
マージ済みのレイアウトは当初、1つの物理EPランクを1つの論理DPワーカーにマッピングしていた。その後PR #33728により、1つのDP-attentionレプリカがattention TP × attention CP個の物理ランクにまたがることが可能になった(CPはContext Parallelismを表す)。例えばTP2、CP1の構成では、ランク4〜5を追加することでDP2/EP4がDP3/EP6に拡張され、さらにランク6〜7を追加するとDP4/EP8に達する。APIは引き続き物理EPユニットで目標規模を表現する。
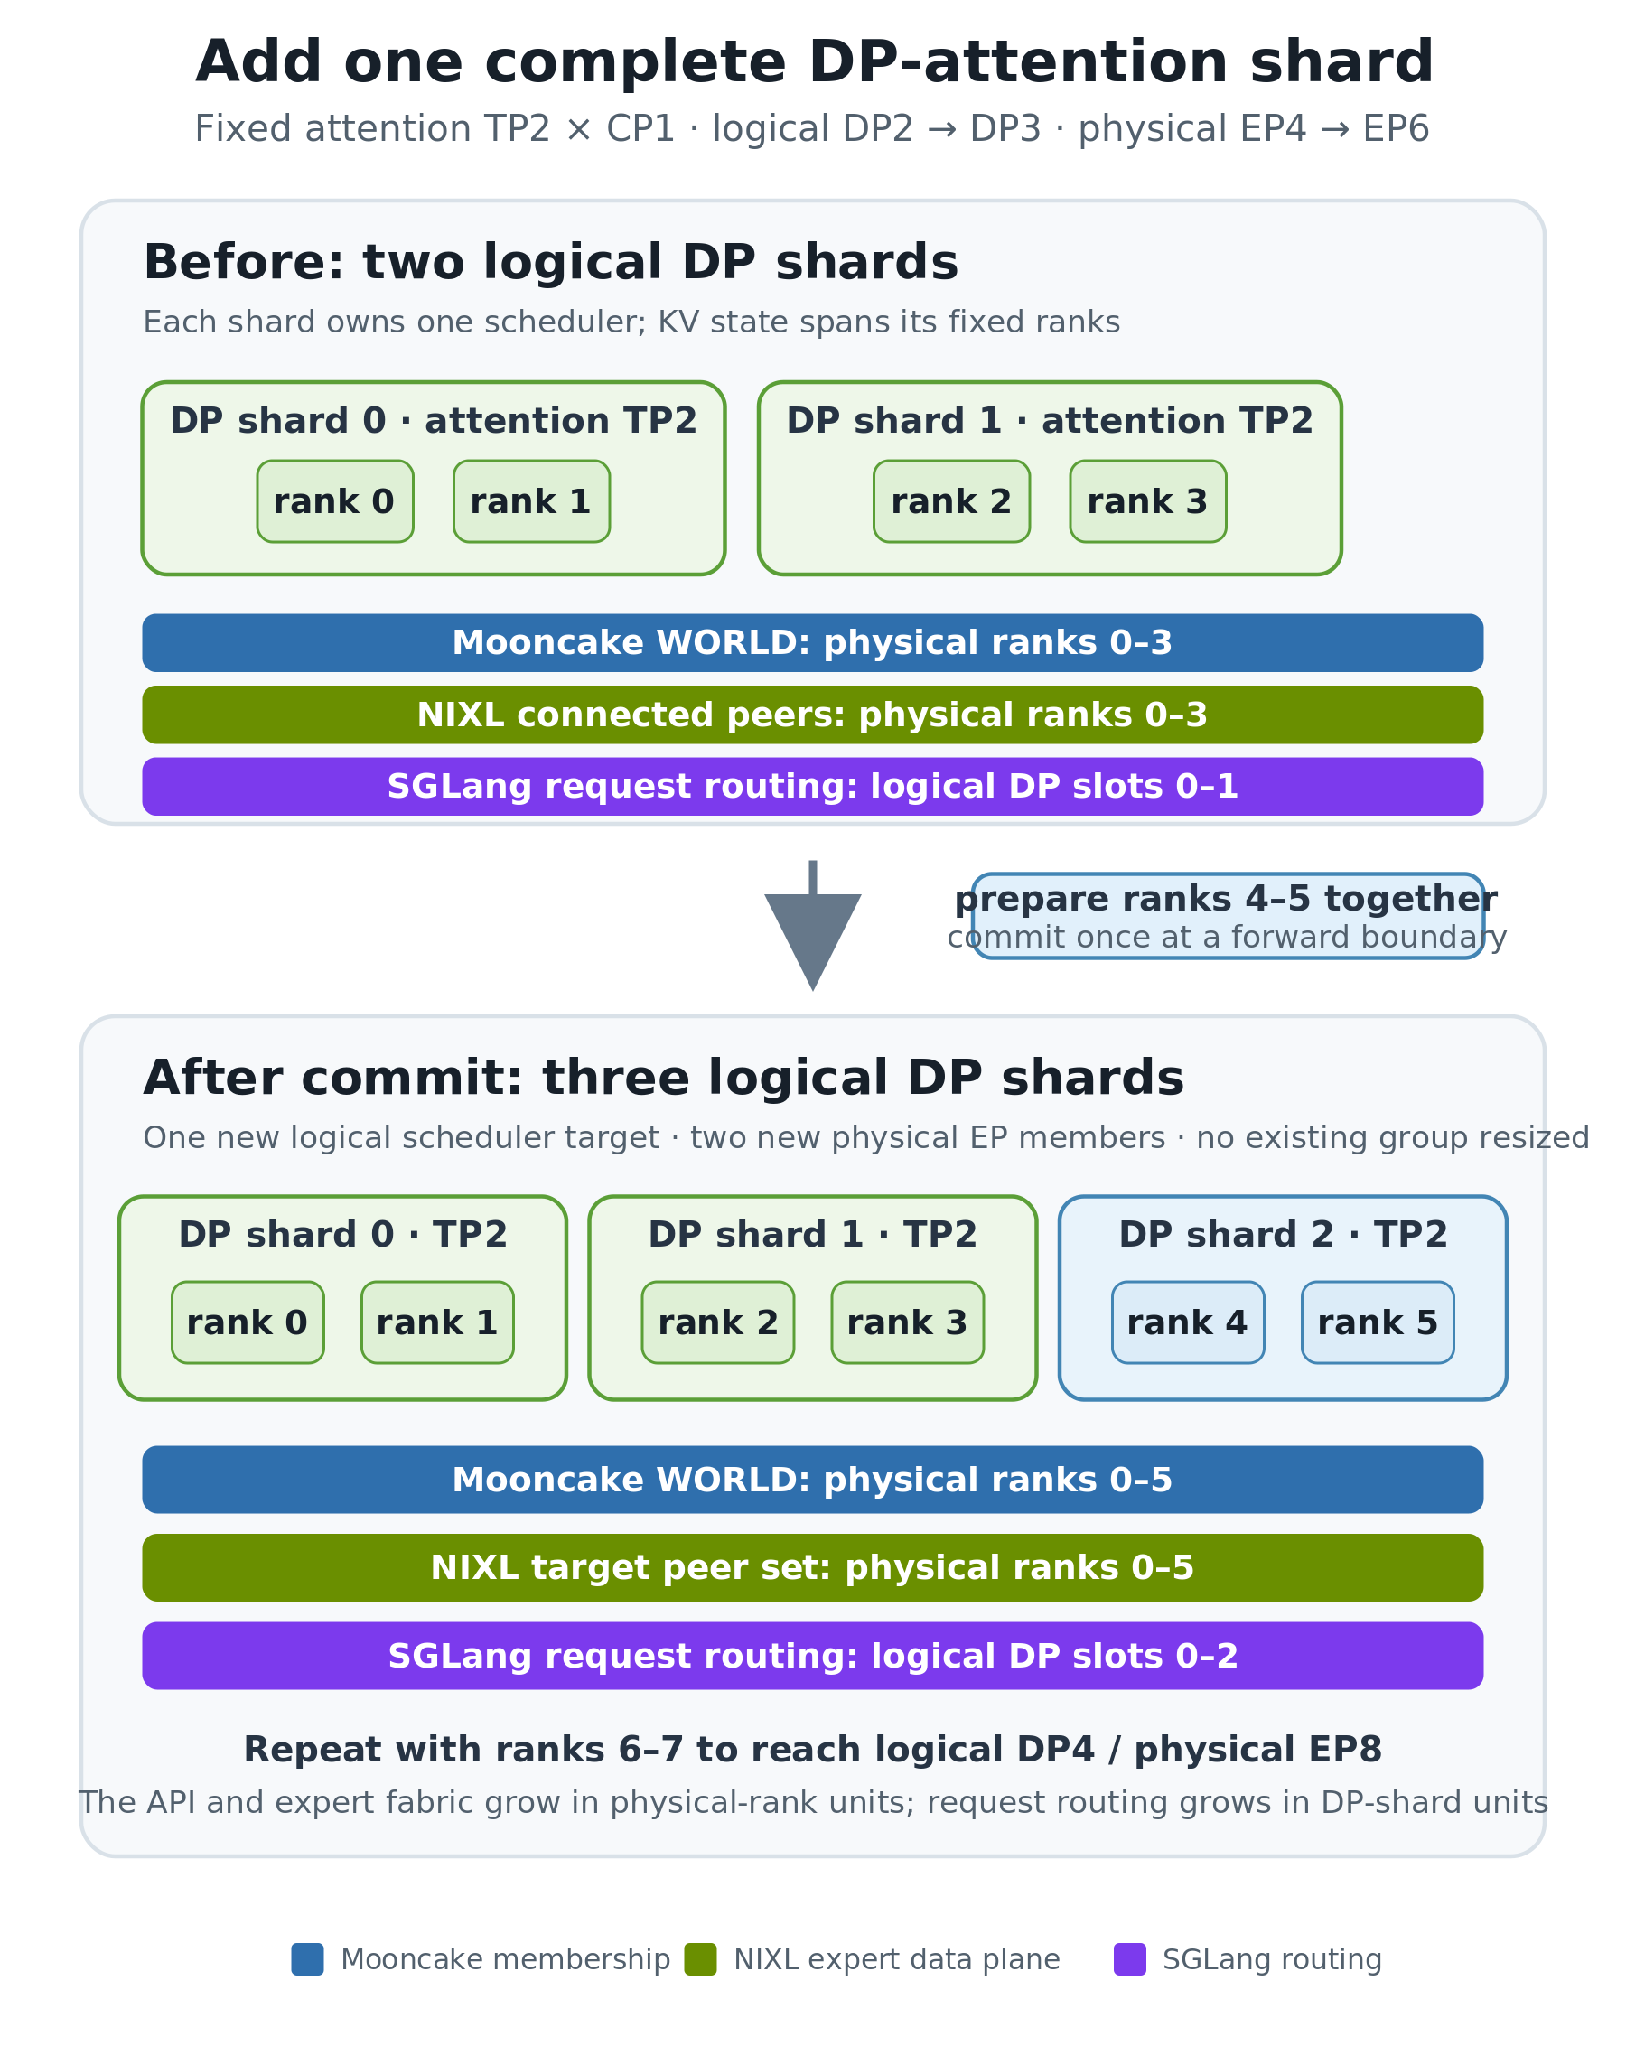
図4:TP2/CP1のDP-attentionシャードを1つ追加することで、DP2/EP4をDP3/EP6に拡張できる。
まとめ
Elastic Expert Parallelism Scalingにより、SGLangのMoE推論デプロイメントはよりクラウドネイティブなサービスに近い弾力性を持つようになる:完全な副本の追加や全量再起動の二択ではなく、ランク単位で細かく容量を増やすことができる。その核心は、SGLangのコントロールプレーン、Mooncake PGのエラスティックメンバーシップ、そしてNIXLのexpert data planeを組み合わせることで、実行時にEPトポロジを安全に拡大することにある。
現時点では、eager scale-up、スケールアップ後のEPLB、full-decode CUDAグラフ再キャプチャ、DP-attentionシャード粒度でのスケールアップがカバーされている。今後のscale-down、grow-back、fully idle progress、スケールアップ後のリカバリ機能により、完全なエラスティック推論ライフサイクルがさらに充実する予定だ。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接