
InfiX.ai、Slime、SGLangチームはminiTE Technical Reportを発表し、現実的な問題に焦点を当てた。大規模言語モデルの強化学習(RL)においてネイティブのNVFP4計算を直接使用すると、潜在的な性能向上をもたらす一方で、学習後期に不安定化する可能性がある。報告は、量子化誤差、活性化値のスケーリング、KV cacheの精度、学習フレームワークとサンプリングフレームワークの実行経路の違いといった観点から診断を行い、アルゴリズム側のTRIAGEとエンジニアリング側のminiTEを提案している。
中核的な結論は、低精度演算子そのものだけでは安定した学習を保証するには不十分だということだ。学習側とサンプリング側の双方がNVFP4を使用していても、依然として顕著なlog-probability mismatchが存在し得る。また、mismatchがより小さく、局所的な計算がより高速であっても、BF16レベルの最終的な学習効果に必ず到達できるとは限らない。
TL;DR:問題、手法、効果
- 問題と診断:ネイティブNVFP4によるRLは、学習後期に不安定化する可能性がある。チームは量子化形式、活性化値のスケーリング、KV cache、実行経路などの要因を体系的に検査し、これらの誤差が方策更新にどのように影響するかを分析した。
- アルゴリズムとエンジニアリング:TRIAGEは更新方向を制御することで残存するmismatchリスクを抑える。miniTEは数値実行の差異を減らし、低精度計算経路を最適化する。報告では両者を個別に評価している。
- 性能向上:8×B300上で、miniTEはBF16 backwardと組み合わせた場合、完全なlearner updateにおいてBF16比で約1.33–1.37×の高速化を達成した。別の固定出力servingテストでは、約1.64×のスループットを達成した。
- 制約と未解決課題:報告のonline RL実験では、重み変換と同期のオーバーヘッドがサンプリングの利得を相殺した。実用的なminiTE checkpointは、5タスク平均では依然としてBF16を下回っている。演算子の整合や小さなgapは、BF16レベルの学習効果を保証しない。誤差許容度、更新規則、最終結果については、さらなる研究が必要である。
なぜネイティブNVFP4 RLは後期に不安定化するのか?
大規模モデルのRLでは通常、rollout、方策確率の再計算、勾配更新、重み同期を繰り返し実行する。回答長が増えるにつれ、生成と学習はいずれも大量のtokenを処理する必要があり、そのため低精度計算は非常に魅力的になる。BlackwellアーキテクチャはネイティブNVFP4 matrix multiplicationをサポートしており、これまでの事前学習の研究でも、適切なscaling、mixed precision、rounding戦略の下では低ビット学習が実行可能であることが示されている。
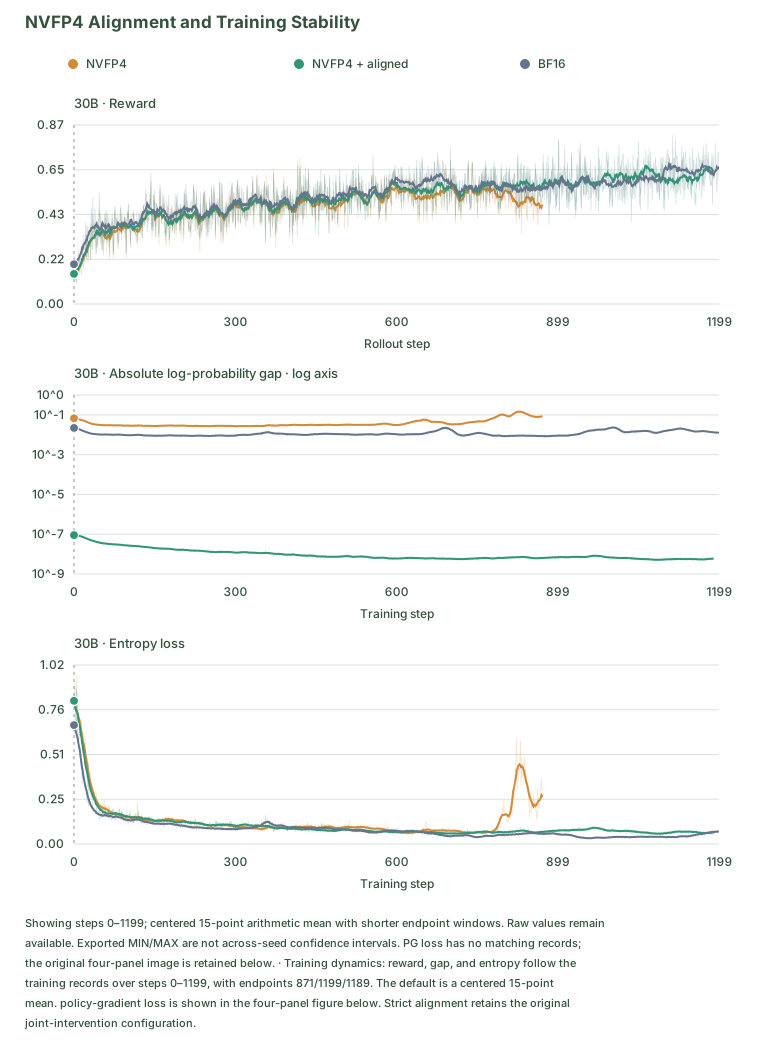
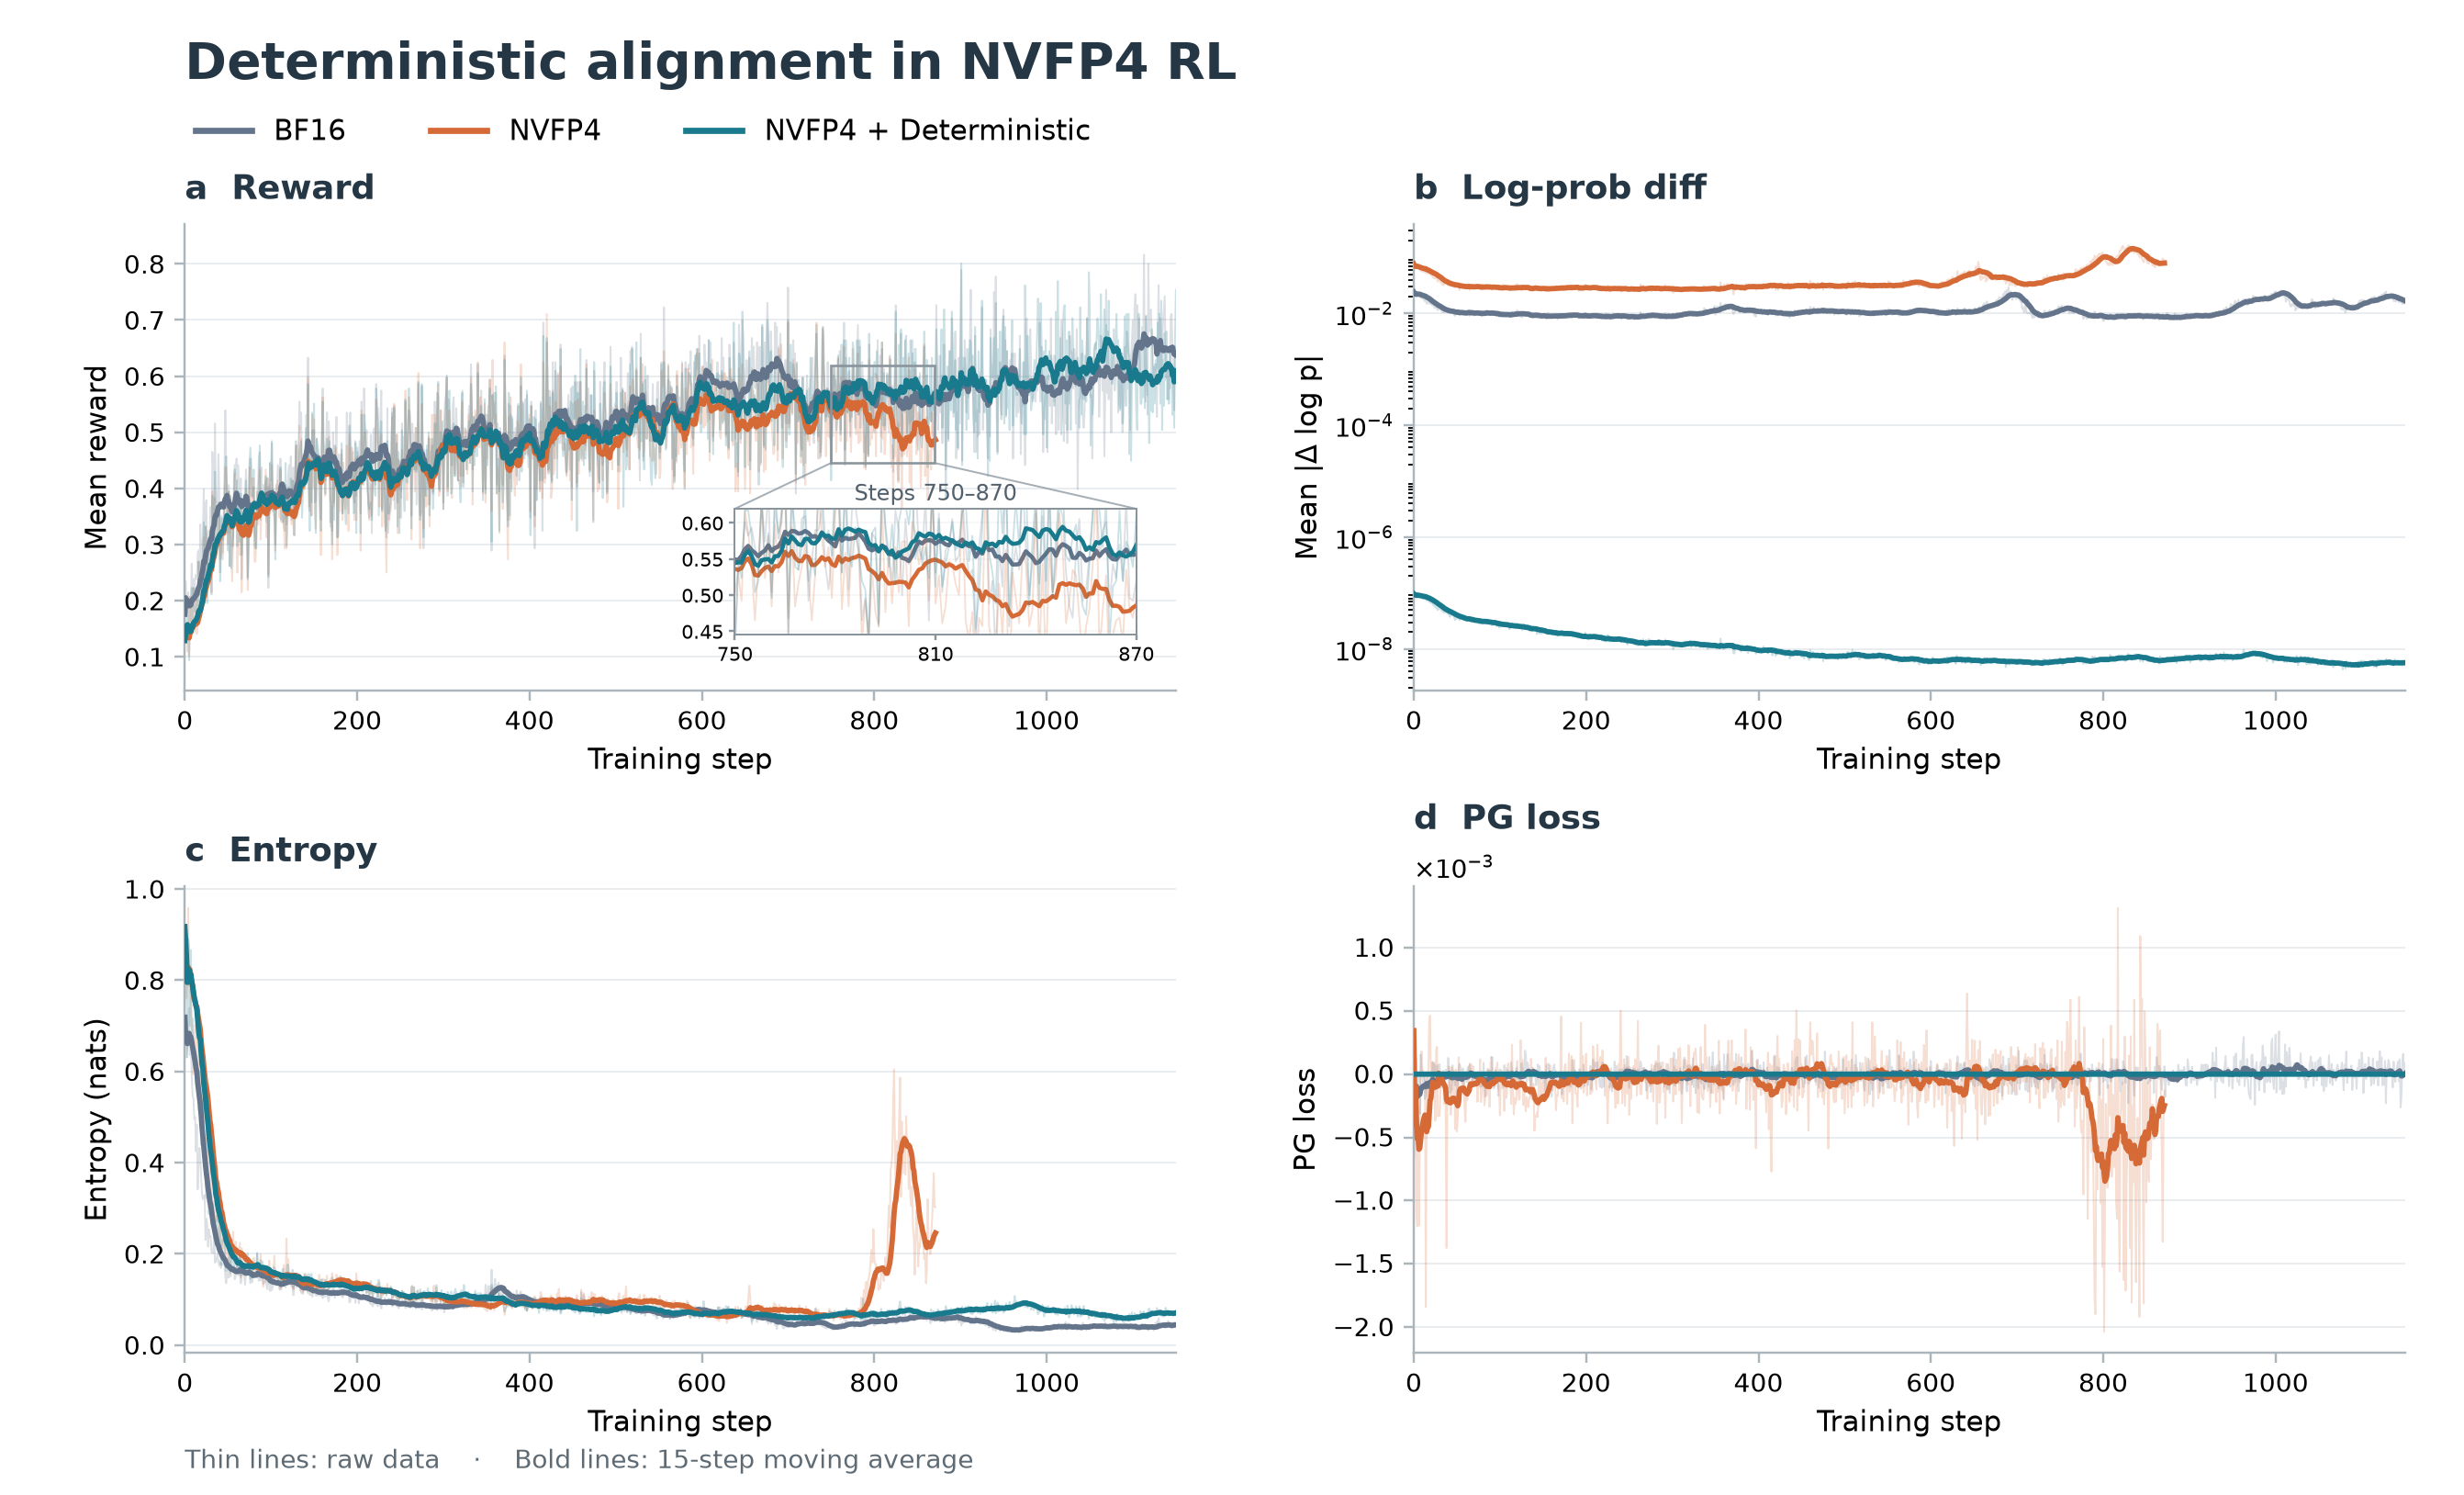
しかし、RLの閉ループは事前学習よりも複雑だ。学習フレームワークと推論フレームワークは、数値実装において十分な一貫性を保たなければならない。チームの初期のNVFP4実行では、rewardは当初正常に上昇したが、その後、異常なentropy、学習側とサンプリング側のlog-probability gapの拡大、rewardの低下といった現象が現れた。単に量子化演算子を1つ置き換えること、あるいは両側がNVFP4を使用していることを確認するだけでは、問題を完全には解決できない。
学習過程で徐々に露呈する失敗モード
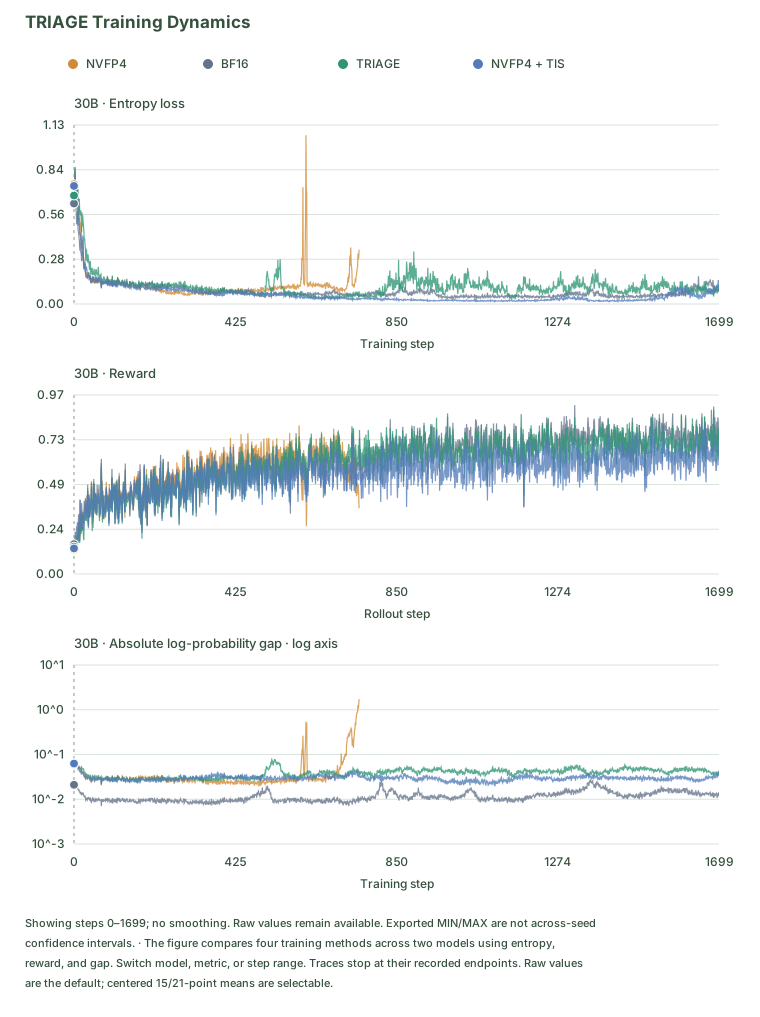
チームはDAPOの数学タスクでQwen3-4BとQwen3-30B-A3Bを用いてGRPO学習を行った。初期のネイティブNVFP4実験では、モデルはまず正常に向上し、その後学習が悪化した。TRIAGEの分析した軌跡では、4Bモデルは約300 steps後に不安定化し始め、30Bモデルのmismatchは約700 steps後に急速に増加した。これは、初期誤差や短期的なloss曲線を見るだけでは、NVFP4 RLが安定しているかどうかを判断するには不十分であることを意味する。
報告では、reward、entropy、学習—サンプリング間のlog-probability gap、および下流タスクのスコアを追跡している。response i内のtoken tについて、δ_i,t = log π_l(y_i,t | x_i, y_i,<t) - log π_s(y_i,t | x_i, y_i,<t)と定義する。ここでπ_lはlearnerが与える条件付き確率、π_sはsamplerが与える条件付き確率である。負のgapはlearnerが与える確率がより低いことを示し、正のgapはlearnerの確率がより高いことを示す。mean absolute gapはtokenレベルの|δ_i,t|の平均値を集計する。
NVFP4形式、2段階スケーリング、変換誤差
報告では、量子化誤差、checkpoint変換誤差、そして学習側とサンプリング側の実行不一致によって生じるmismatchという3つの概念を区別している。量子化誤差は低精度計算が高精度の参照値からどれだけずれるかを表す。一方、training–sampling mismatchはlearnerとsamplerの実際の実行結果を比較するものだ。checkpoint変換とinference backendへの適応も、追加の誤差を引き起こす。
NVFP4はE2M1を用いて量子化値を表現する。EとMはそれぞれexponentとmantissaのbit数を表し、さらに1つのsign bitがある。デコード時には、qはE2M1の数値、s_bは16要素ごとに共有されるE4M3 block scale、s_gはFP32 outer scaleである。outer scaleはper tensor、per expert、またはper rowで計算できる。
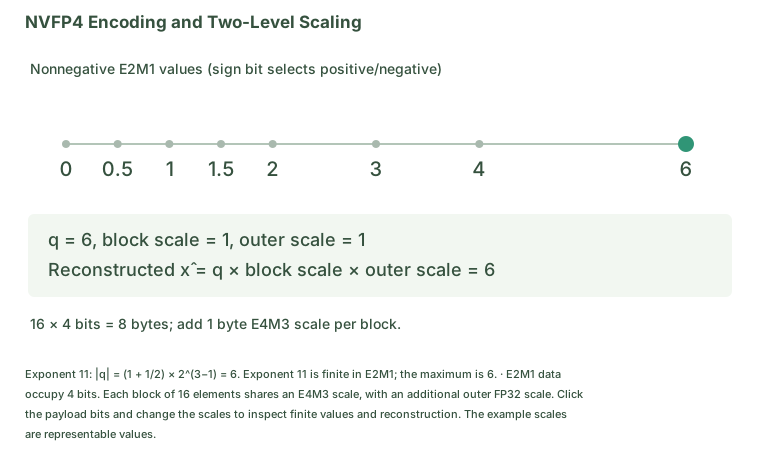
あるQwen3-0.6B NVFP4事前学習checkpointでは、fused QKV構造の処理が正しくなかったため、深刻な性能低下が発生したことがあった。修正後、Lambdaの平均正解率はそれぞれ、BF16が約0.3043、1次元量子化が約0.3056、2次元block-scaled quantizationが約0.3109となった。これは、失敗の原因をFP4形式に帰す前に、モデル構造への適応と変換プロセスをまず確認しなければならないことを示している。
Qwen3-4Bでは、online quantizationはBF16と比べてLambda-baseとMath23Kのスコアをそれぞれ0.0355、0.047低下させた。offline conversionはさらに0.0089、0.019の低下をもたらした。これらの実験は、形式/数値経路による損失と、変換/scale処理による損失を切り分けるのに役立った。
同じNVFP4であっても、両側はなお大きく不一致になり得る
初期設定では、学習側とサンプリング側のmean absolute log-probability gapは以下のとおりだった。
| 学習/サンプリング精度 | Dense | MoE |
|---|---|---|
| BF16 / BF16 | 0.0110 | 0.0172 |
| NVFP4 / NVFP4 | 0.1142 | 0.0668 |
| NVFP4 / BF16 | 0.1376 | 0.0621 |
| BF16 / NVFP4 | 0.1690 | 0.0747 |
ここでdenseモデルはQwen3-4B、MoEモデルはQwen3-30B-A3Bである。注目すべき点として、offline ModelOpt conversionをonline quantizationに置き換えた後も、denseモデルのgapは依然として約0.1142だった。両側が同じquantization/GEMM operatorsを使用していても、なお残存差異が存在する。したがって、問題は重み量子化だけではなく、入力の構成、scale計算、量子化周辺の操作にも関わっている。
活性化精度、スケーリング粒度、KV Cache
NVFP4重みを固定した後、activation precisionを高めることで、活性化値量子化の影響をテストできる。報告では、WとAをそれぞれweightsとactivationsのbit widthとして表しており、例えばW4A16は4-bit weightsと16-bit activationsを意味する。
| 重み/活性化値 | Dense gap | MoE gap |
|---|---|---|
| W4A16 | 0.0139 | 0.0166 |
| W4A8, MXFP8 activations | 0.0363 | 0.0227 |
| W4A4, NVFP4 activations | 0.0903 | 0.0445 |
W4A16はgapをBF16参照水準に近づけた。これは、この設定ではactivation quantizationが重要な要因であることを示している。別の固定設定では、KV cacheをFP8からBF16に変更すると、gapを0.0721から0.0583に下げることができた。これは、sampler state precisionもフレームワーク間の一貫性に影響することを示している。
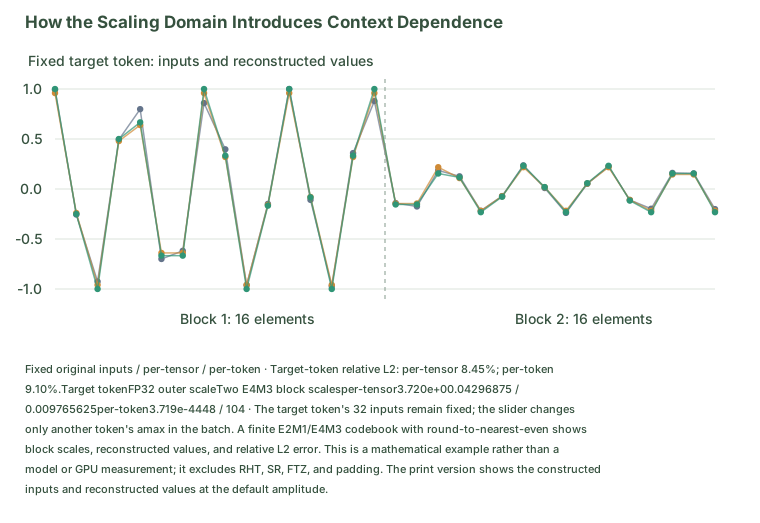
スケーリング領域も文脈依存性をもたらす。sampler decodingは通常、現在のtokenを一度に1つ処理するのに対し、learnerは多くの場合、response全体を一度に処理する。activation outer scaleがtensor-wide amaxを使用する場合、samplerとlearnerが見るtoken集合は異なり、scaleも異なる可能性がある。その結果、同じtokenが2つの実行経路で異なる量子化結果を得ることになる。
TRIAGE:更新方向から残存mismatchリスクを制御する
エンジニアリング上できる限り整合を取っても、低精度学習には避けられないmismatchが残る可能性がある。TRIAGEの考え方は、すべての誤差を消せると仮定するのではなく、mismatchとupdate directionに基づき、高リスク区間で更新方式を調整し、残存誤差が学習過程を損なう影響を低減することにある。
報告は、mismatchが危険かどうかは、それが方策更新方向とどのような関係にあるかに依存すると強調している。場合によっては、数値誤差はわずかなずれをもたらすだけである。しかし、誤差方向と更新方向が重なると、誤った方策確率を増幅し、entropyの異常、rewardの低下、あるいは学習後期の崩壊につながる可能性がある。
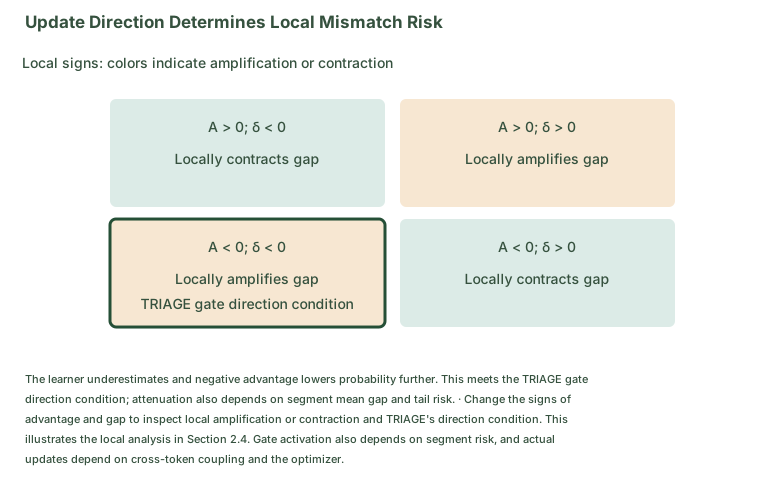
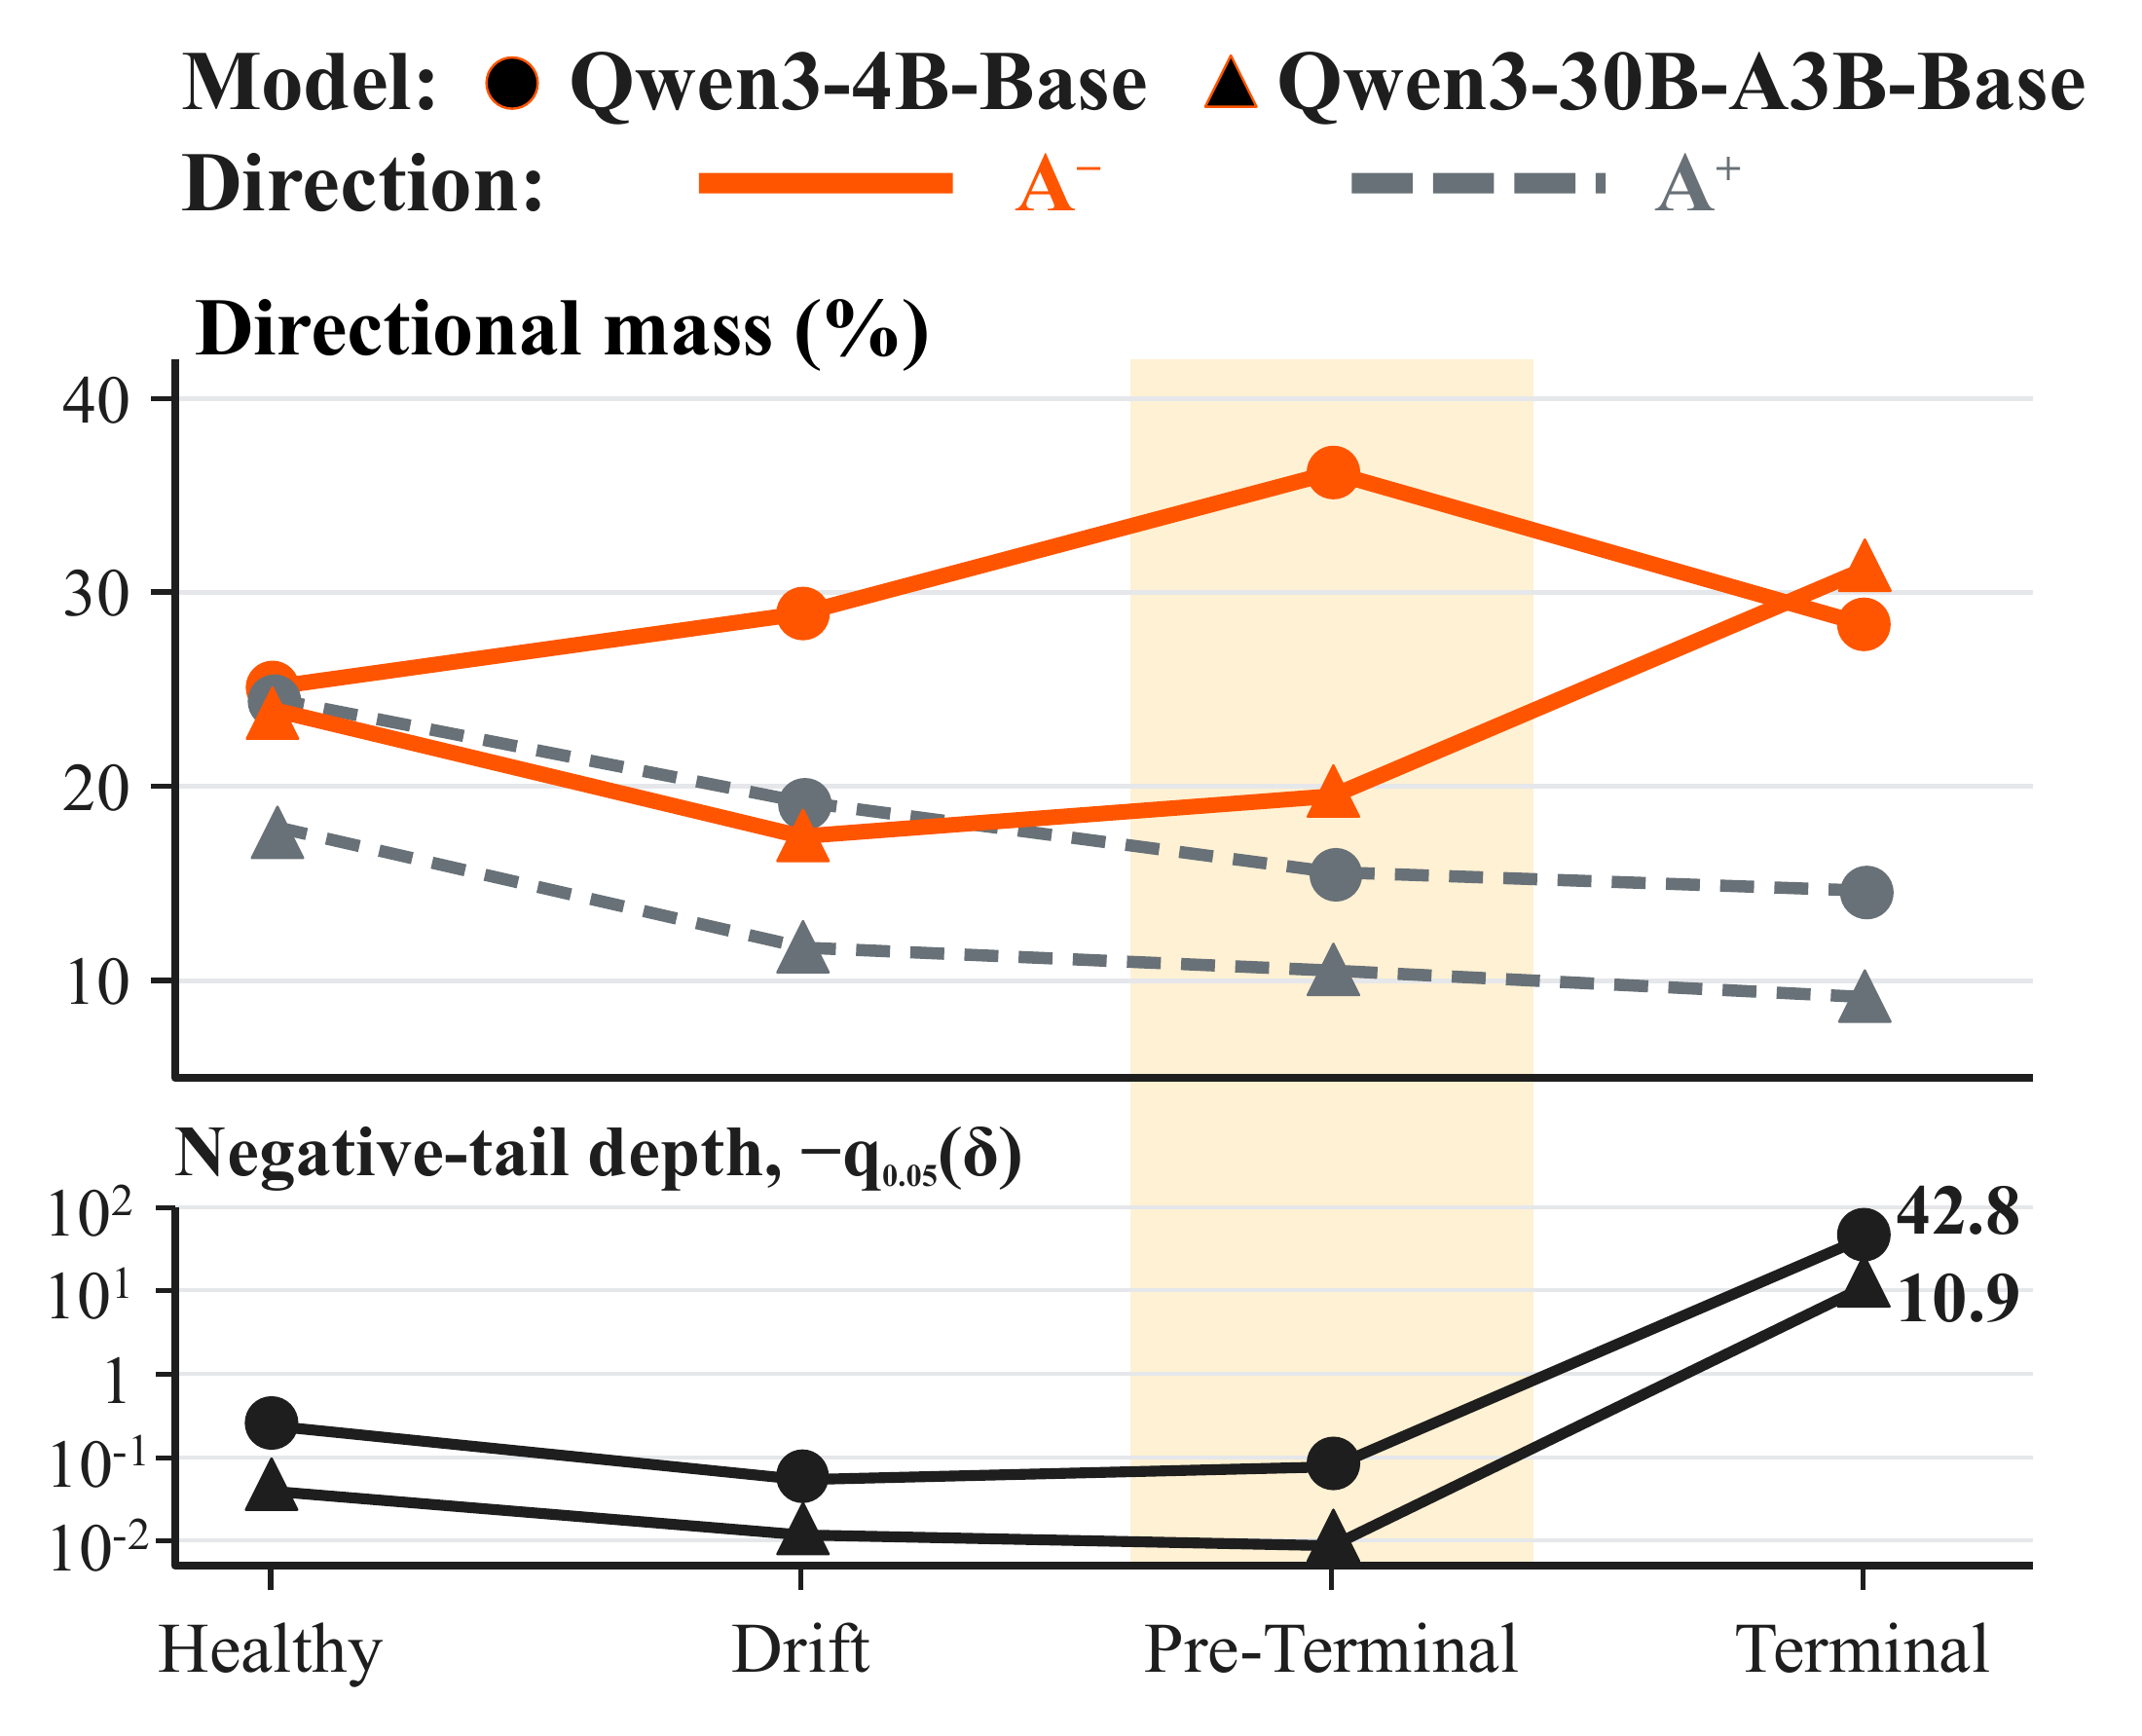
学習ダイナミクスにおいて、TRIAGEは高リスク領域を識別して処理することで、negative tailsと局所的な不安定性の制御を助け、安定性とタスク性能を改善する。報告ではTRIAGEをアルゴリズム側の手法として、miniTEのシステムエンジニアリング最適化とは分けて評価している。
miniTE:量子化戦略、線形層、計算バックエンドを分離する
大規模な学習フレームワークでは、scale granularityやGEMM backendを変更すると、多くの場合、layer wrapper、grouped layout、communication、autogradに影響が及ぶ。miniTEの目的は、quantization policy、linear layers、compute backendsを分離し、開発者が既存の学習フローの中で特定の計算経路を置き換え、数値的正しさ、学習挙動、実行コストをそれぞれ評価できるようにすることだ。
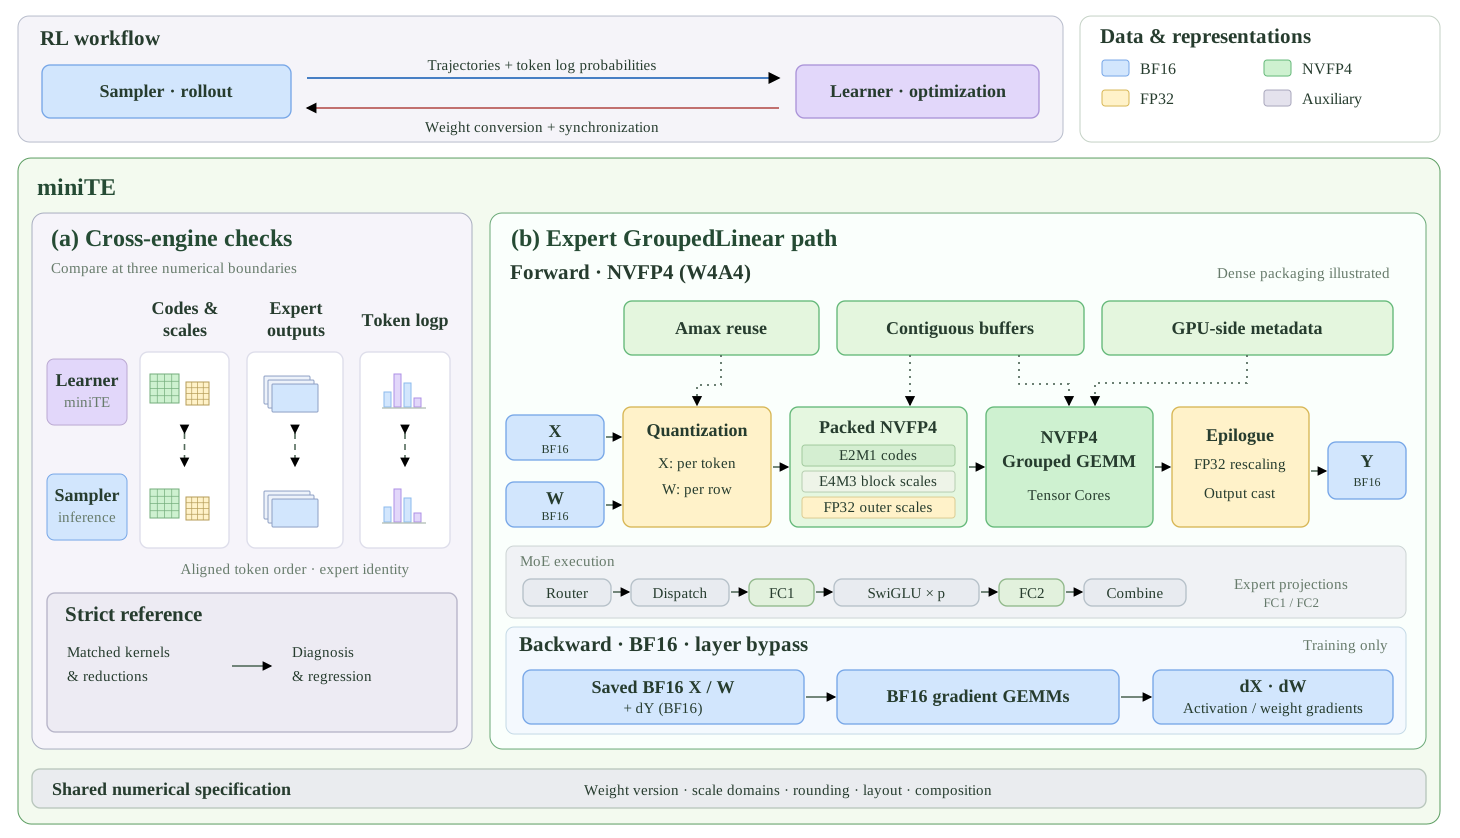
miniTEはprecision configuration、alignment checks、performance analysisを提供し、低精度経路におけるlearnerとsamplerの実行差異を調査するのを支援する。これは単一の演算子置換ではなく、NVFP4の学習経路と推論経路の整合を中心に据えたエンジニアリングフレームワークである。
Transformer Engine経路最適化:準備とスケジューリングのオーバーヘッドを削減する
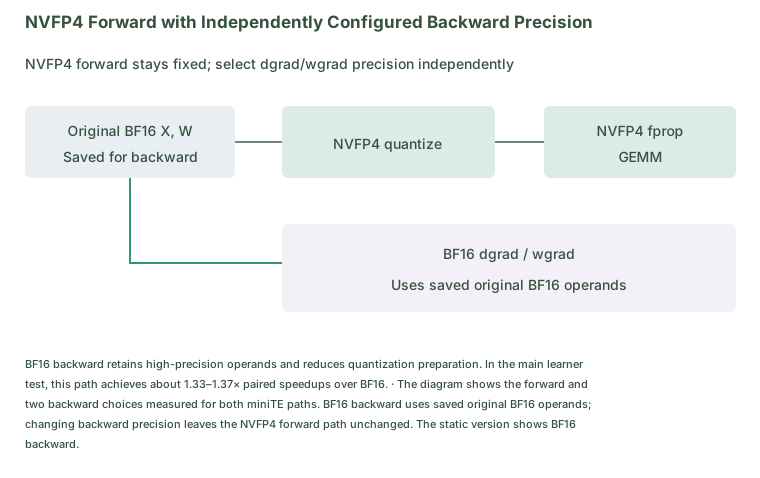
報告では、Transformer Engineのper-token NVFP4 pathに関連する共同作業も紹介している。最適化手法には、contiguous layouts、device-side metadata、amax reuse、grouped GEMM、fusionが含まれ、低精度実行におけるデータ準備とkernel dispatchのオーバーヘッドを削減する。
これらの最適化の重点は、演算子microbenchmarkのピーク値を追求することだけではなく、low-precision computationを完全なlearner updateの中で実際の利得に変換することにある。特にRLでは、サンプリング、学習、重み同期、フレームワーク切り替えのすべてがエンドツーエンドの利得に影響する。
実験結果:速度向上は明確だが、学習品質にはなお差がある
システム性能については、8×B300上で、miniTEの2つの経路はBF16 backward設定において、BF16の完全なlearner updateと比べて約1.33–1.37×のpaired speedupを達成した。別の固定出力servingテストでは、スループットがBF16の約1.64×に達した。
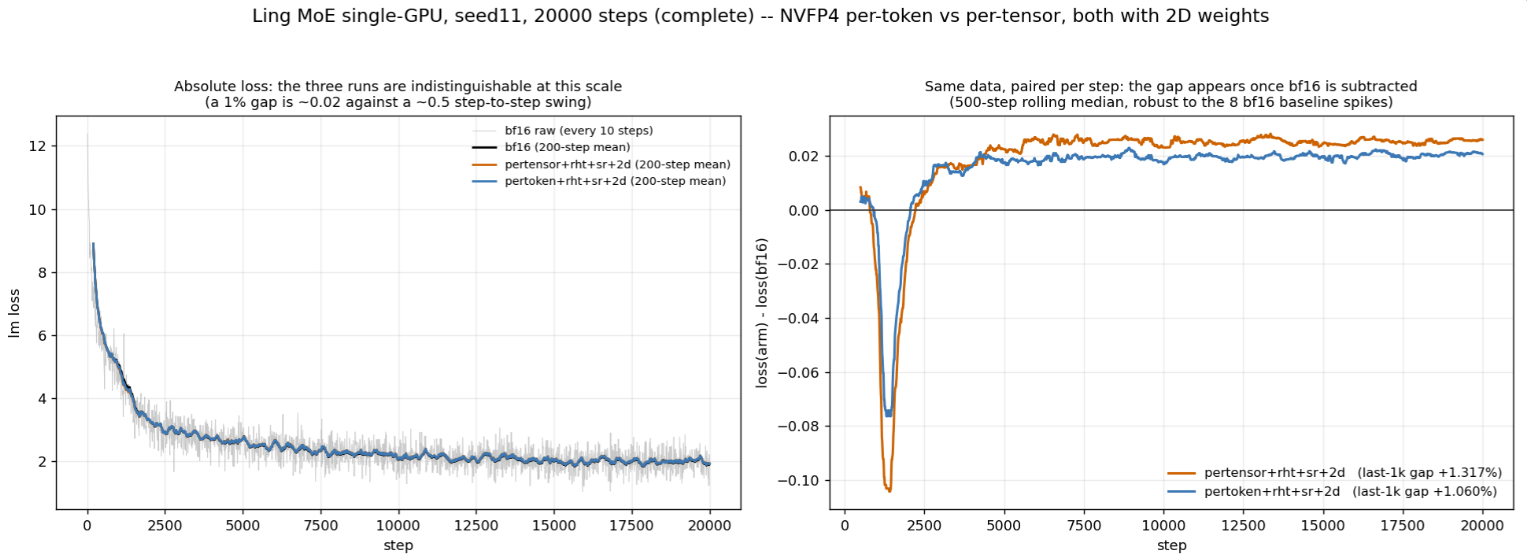
ただし報告は、これらのlearning resultsとsystem resultsが異なる設定に由来することも明確に注意喚起している。より低いmismatchとより高速な局所計算は、BF16レベルの学習に達したことを直接証明するものではなく、エンドツーエンドのRLが必ず高速化することを証明するものでもない。報告のonline RL runでは、weight conversionとsynchronizationのオーバーヘッドがsampling gainsを相殺した。実際のminiTE checkpointは、5タスク平均では依然としてBF16を下回っている。
結論:NVFP4 RLの難点は低ビット演算子だけではない
この報告の価値は、ネイティブNVFP4 RLの問題を「低精度行列乗算を実行できるか」から「低精度実行が方策学習にどのように影響するか」へと進めた点にある。RL学習では、learnerとsamplerの確率的一貫性、activation scaling domain、KV cache precision、checkpoint conversion、inference adaptation、update ruleのいずれもが不安定性の要因になり得る。
TRIAGEはアルゴリズム層から残存mismatchリスクに対処し、miniTEはエンジニアリング層から回避可能な数値差異を減らし、低精度実行効率を高める。両者は共に、NVFP4をRLで本当に使えるものにするには、数値整合、誤差許容、更新規則、最終的なタスク性能を同時に重視する必要があることを示している。現在の結果は大きな性能ポテンシャルを示しているが、BF16レベルの学習効果を安定して再現するには、なお多くの未解決課題について研究を続ける必要がある。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接