
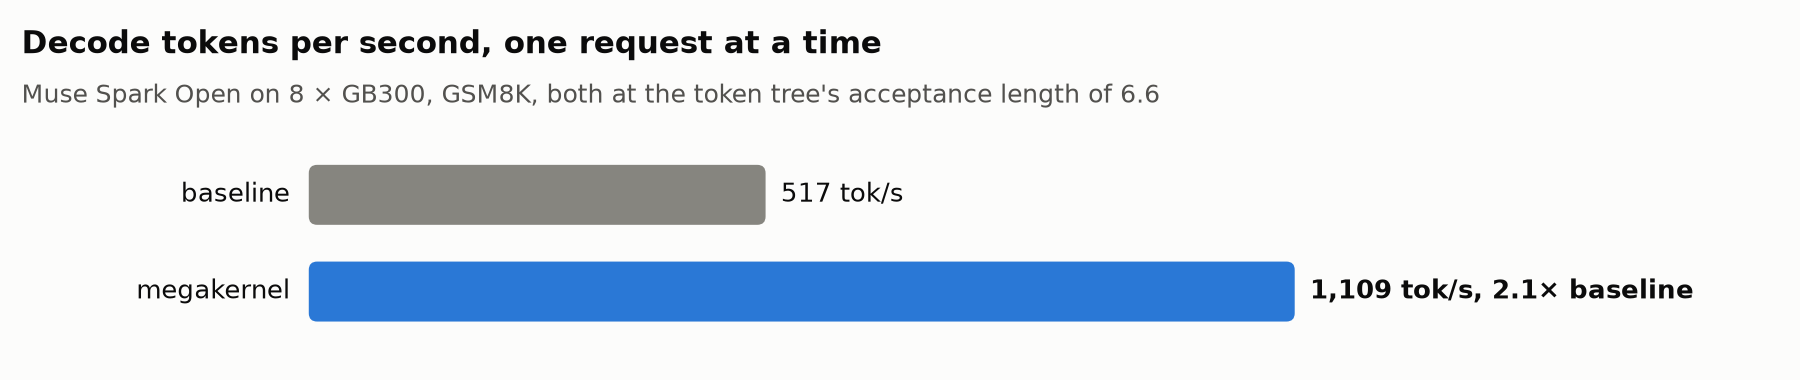
SGLangとMLインフラは、より大規模なGPUカーネルであるメガカーネルへの移行を進めている。本稿では、CUDA C++とPTXをゼロから用いてMuse Spark Open向けにメガカーネルを構築し、Blackwell GPUにおけるシングルリクエストのデコード速度を517 tok/sから1109 tok/sへと向上させた取り組みを紹介する。
Muse Spark Openは従来型のMoE構造を採用しており、各トークンは256個のエキスパートのうち8個にルーティングされる。エキスパートの重みは4ビットNVFP4形式で保存され、62個のデコード層を持つ。
メガカーネルとは何か?
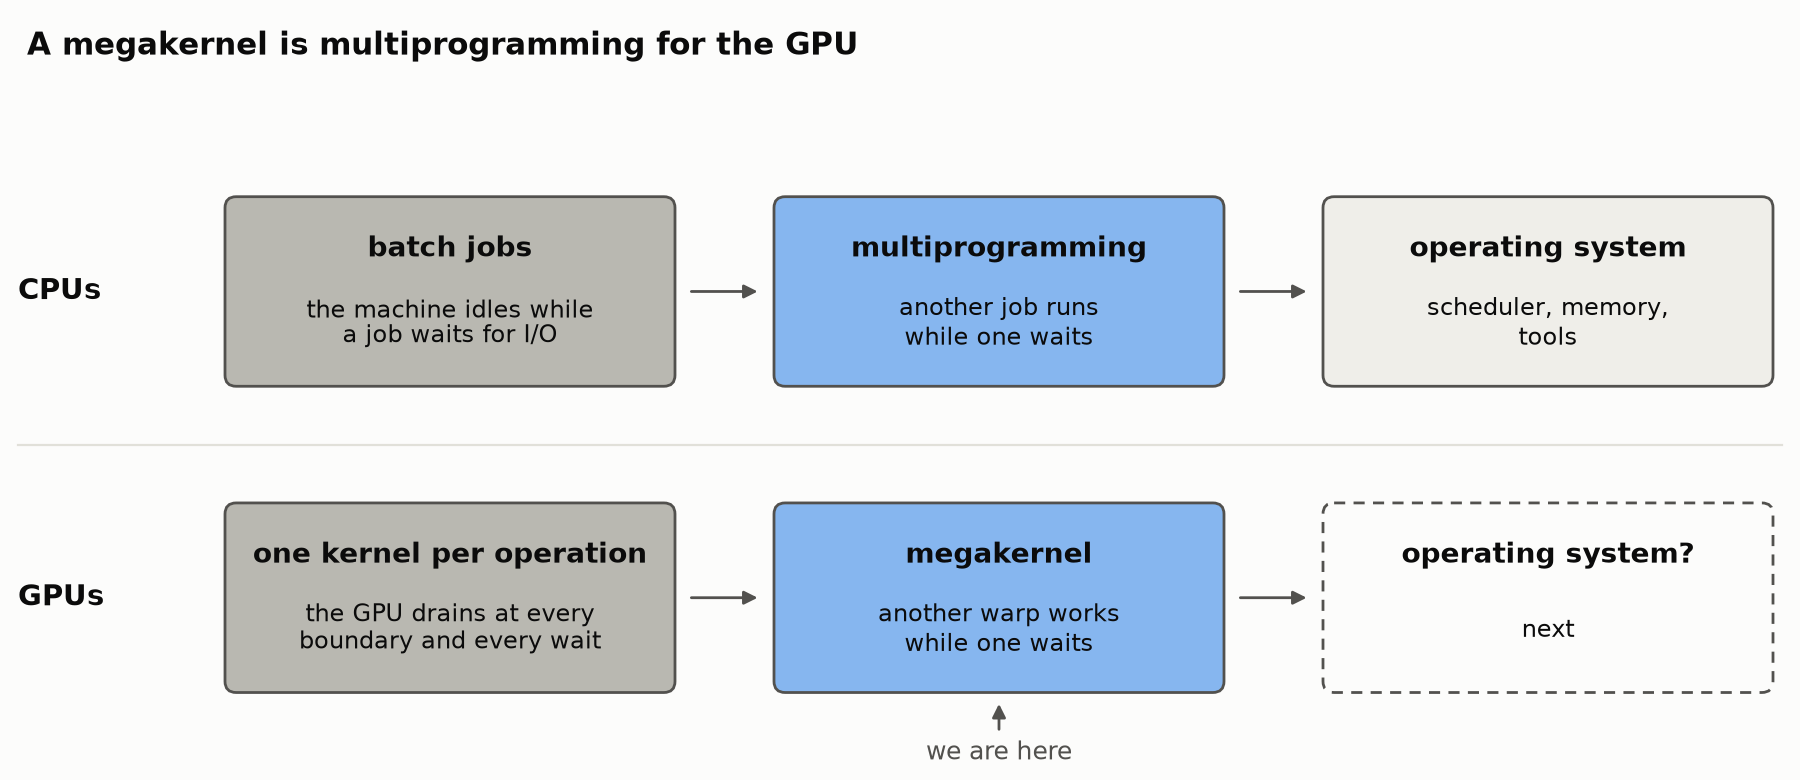
通常のGPUカーネルは単一の演算のみを実行するため、サービスエンジンは1回のデコードステップを完了するために約1450個のカーネルを発行する必要がある。十分に最適化されていない場合、カーネル間でGPUがアイドル状態になる。メガカーネルでは、単一のカーネルがすべてのSM(ストリーミングマルチプロセッサ)に常駐し、複数の処理を同時に実行することで、テンソルコア・TMA・NVLinkなどのエンジンを全速で稼働させ続ける。
モデルと新たなテンソル並列処理
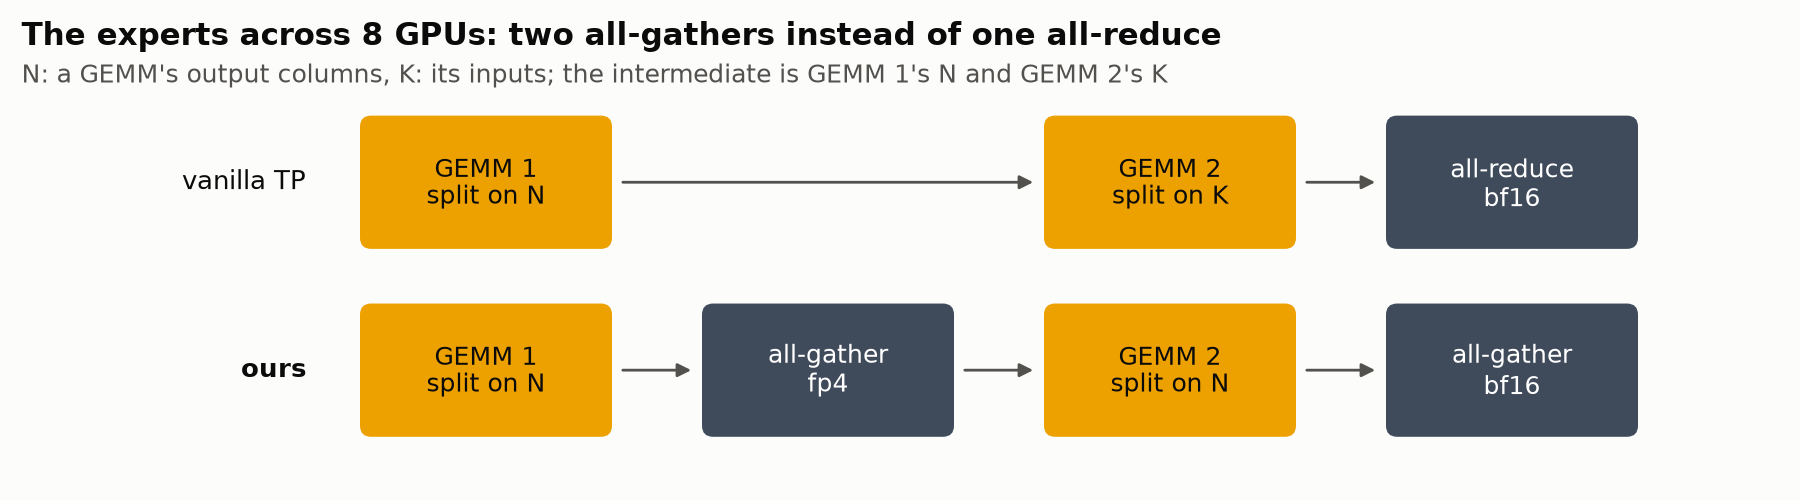
モデルは8枚のGPU上でTP8として分割される。従来のTPでは2つのMoE GEMM間でall-reduceを1回のみ行うが、新方式ではN次元で2つのGEMMを分割し、fp4 all-gatherとbf16 all-gatherを導入する。通信ステップは1つ増えるものの、全体的な通信量は低減され、スケーラビリティが向上する。
メガカーネルの実装
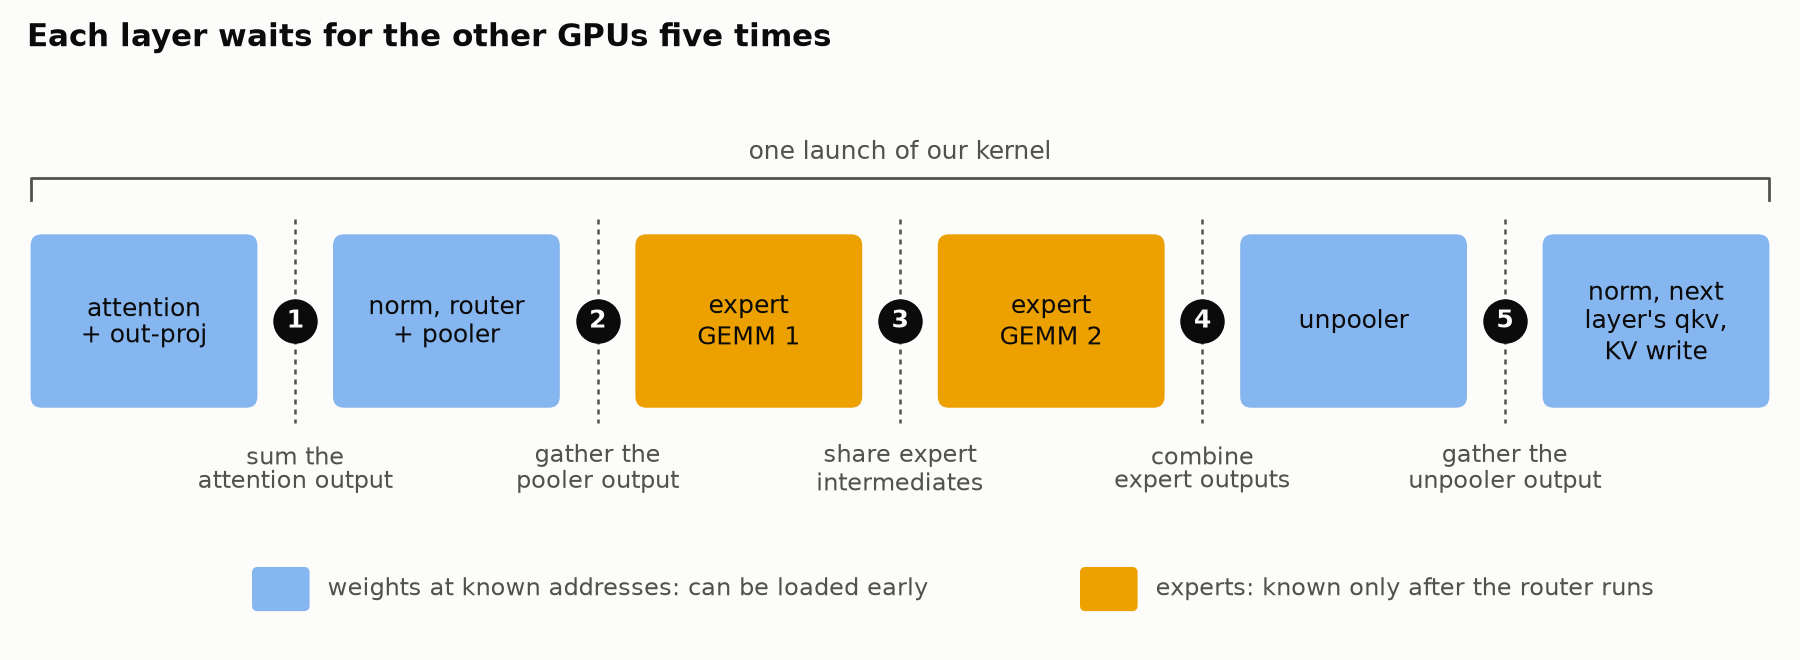
各層に対してカーネルを1回だけ発行し、現在の層のアテンションから次の層のQKV投影とKV書き込みまでをカバーする。各カーネルは144個のSMに12個のワープを配置し、異なるワープがKVロード・重みプリフェッチ・テンソルコア計算・SwiGLU・all-gather/reduceをそれぞれ担当する。
パフォーマンスと投機的デコード
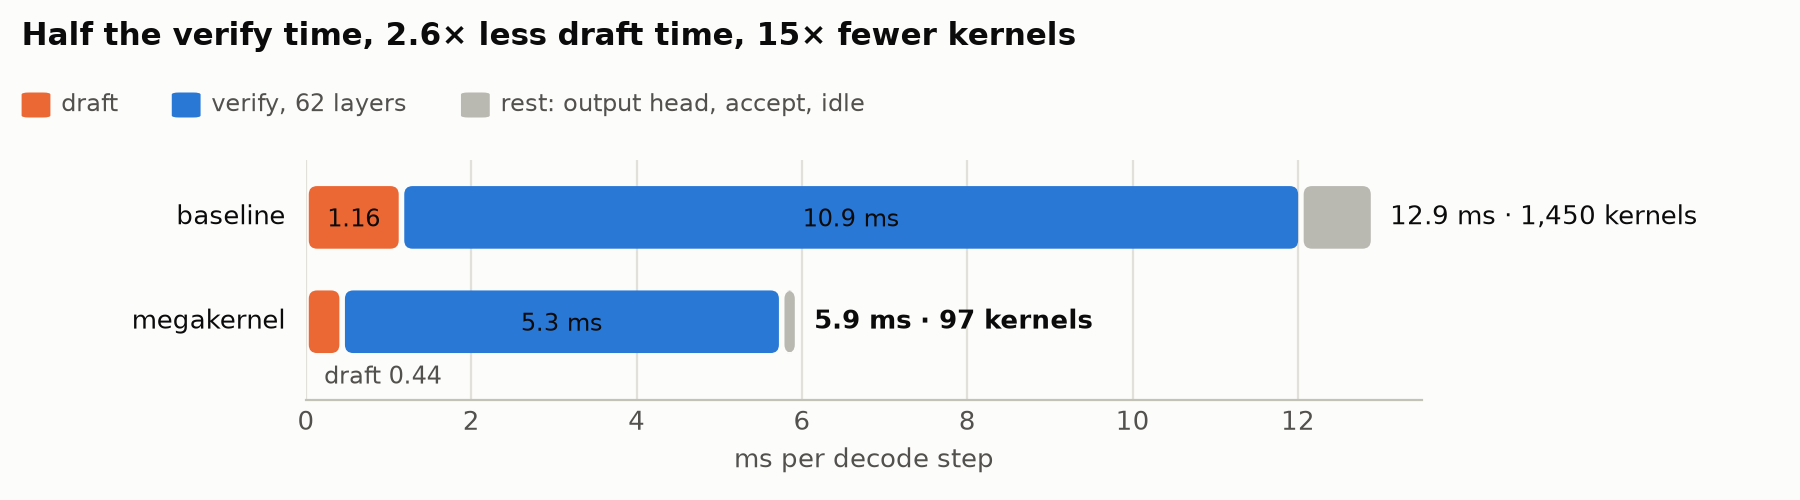
1ステップのデコード時間は12.9ミリ秒から5.9ミリ秒へと短縮され、カーネル数は1450個から97個へと削減された。DFlash V2ドラフトモデルと組み合わせることで、1ステップあたり16トークンを検証し、平均6.6トークンが受理され、1109 tok/sを達成した。
メガカーネル内部の最適化
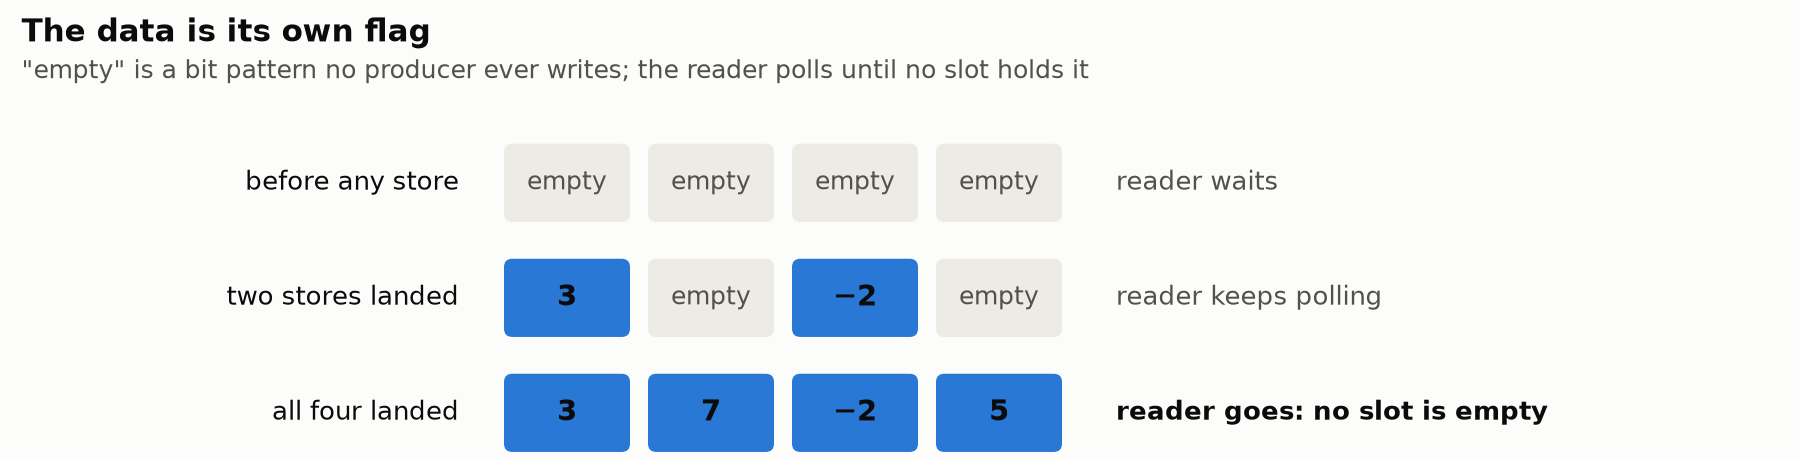
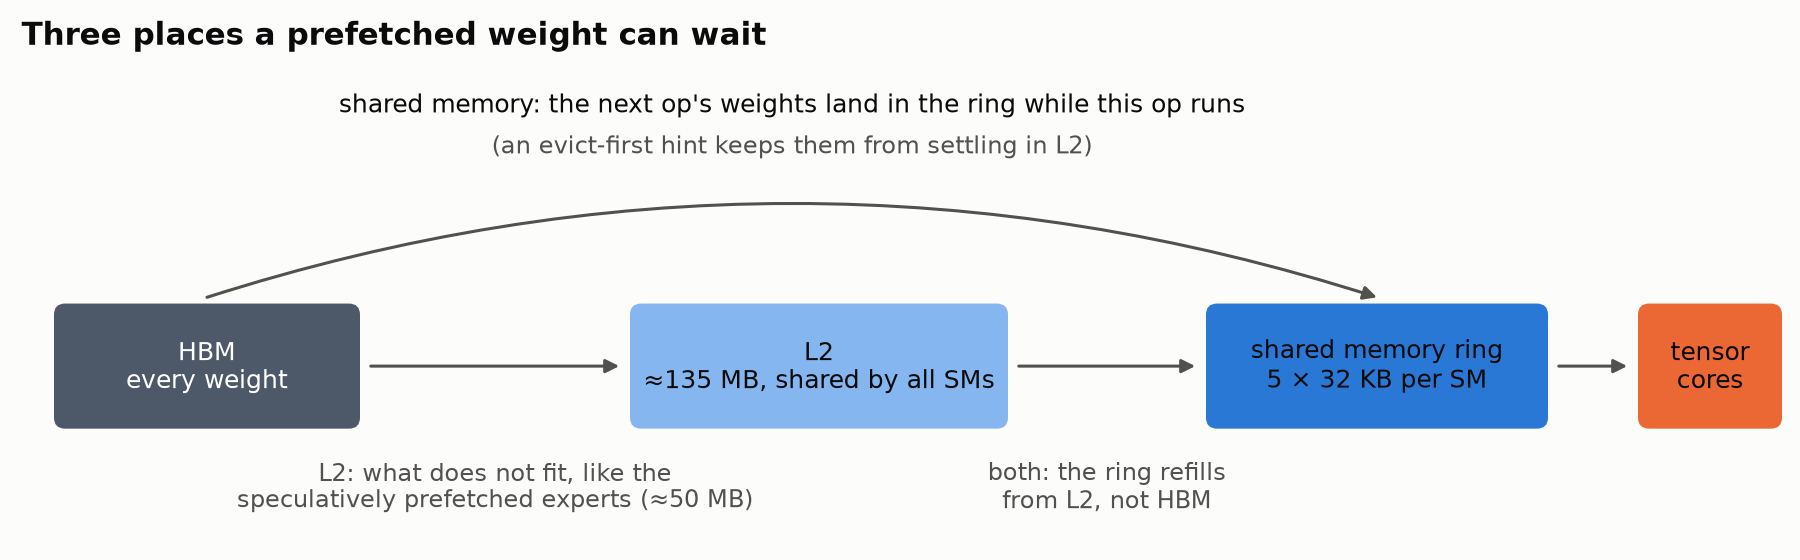
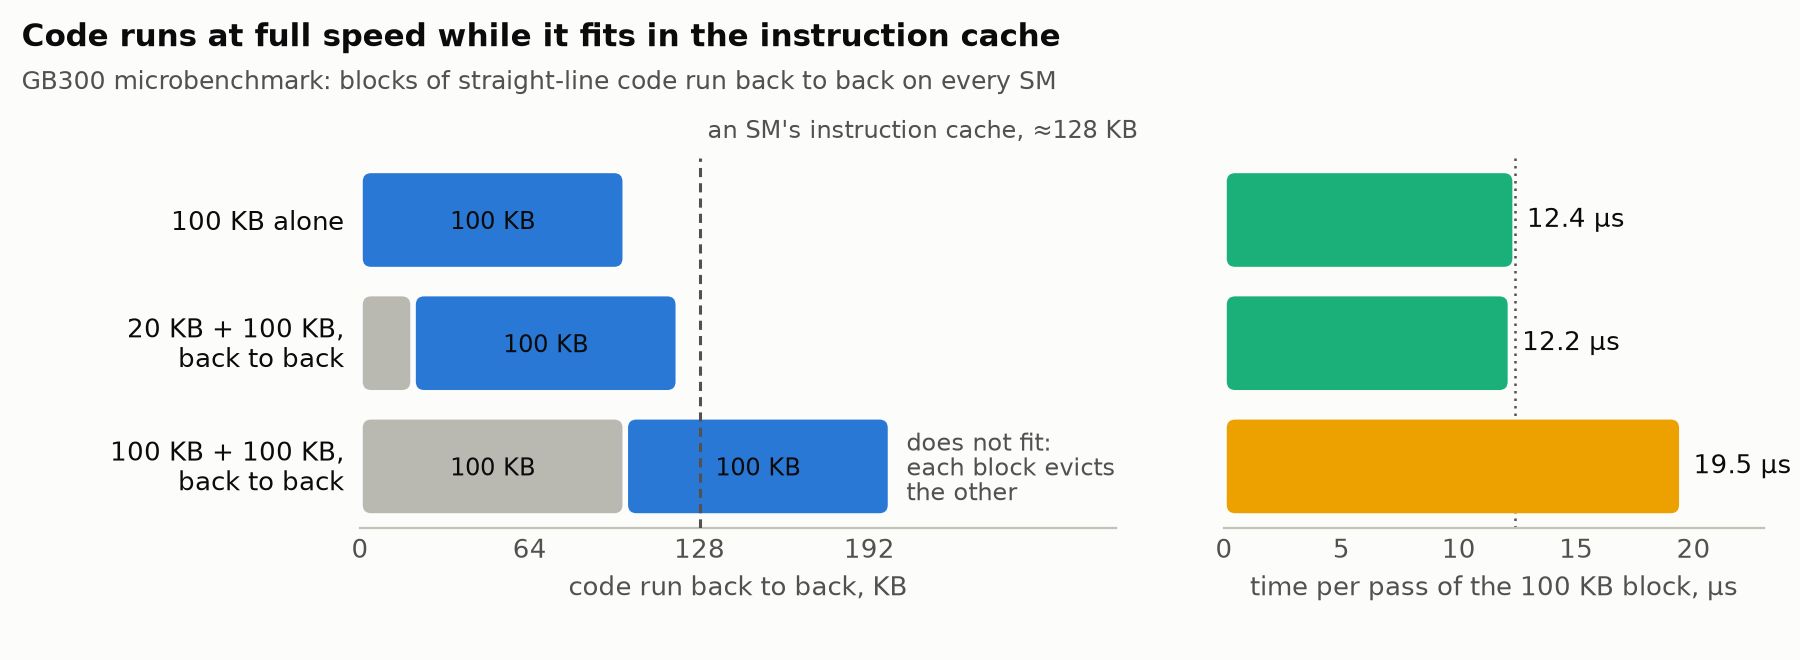
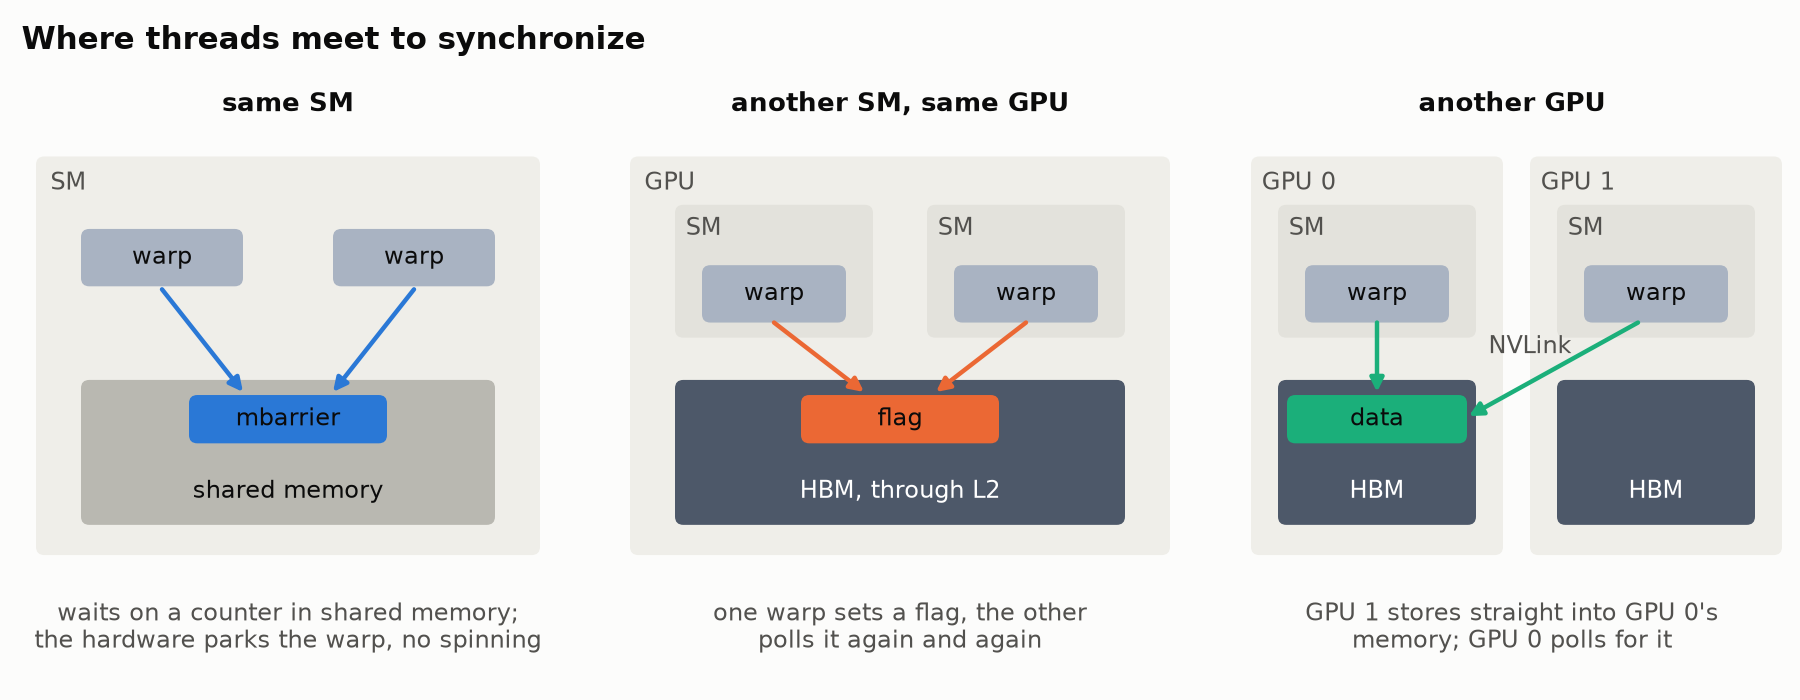
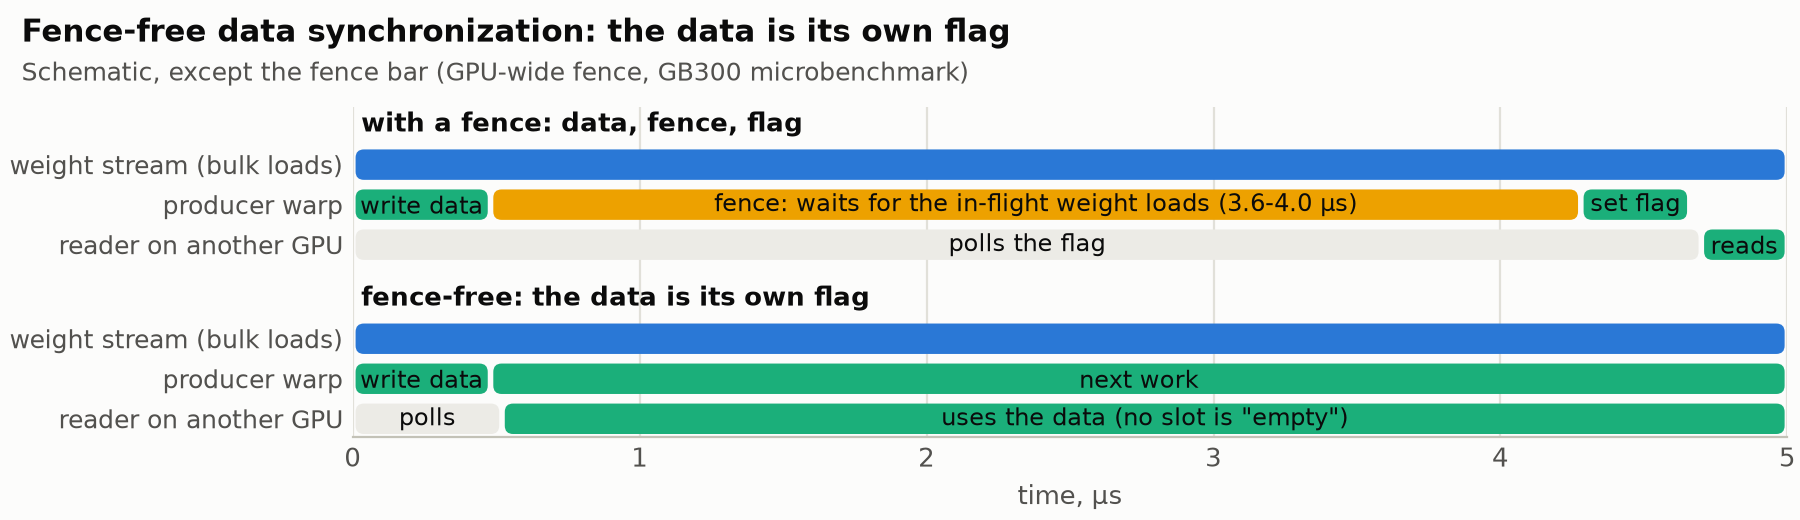
重みの完全キャッシュプリフェッチ、命令キャッシュ管理、多段階同期(共有メモリのmbarrier、HBMフラグ、NVLinkによるダイレクトストア)、フェンスレスデータ同期を組み合わせることで、ほぼ完全な処理のオーバーラップを実現している。
今後の展望
今後はより大きなバッチサイズへの対応を進めるとともに、GPUオペレーティングシステムの方向へと発展させていく予定である。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接