
はじめに
私たちはNVIDIA Vera Rubinノード2台(GPU合計8枚)への早期アクセスを取得し、SGLangとMilesフレームワークを同プラットフォームへの移行に成功した。SGLangは推論を、Milesは強化学習訓練を担当する。Kimi K3 NVFP4モデルに向けて、アテンション、MoE通信、KDAカーネルに対する専門的最適化を実施した。
推論最適化:Kimi K3 NVFP4のサービング
Kimi K3は2.8Tパラメータのハイブリッドモデルであり、93層アテンション(69層KDA線形アテンション+24層MLA)と896エキスパートのLatentMoE構造を採用している。RadixArkのDSparkブロック投機的デコードを用いてサービングを行っている。
アテンション最適化
Vera RubinのCTAあたり327 KiBの共有メモリを活用し、MLAパイプラインを3K+2Vステージから4K+4Vステージへ拡張することで、バッチサイズ16・コンテキスト長128kの条件下で16%の高速化を実現した。
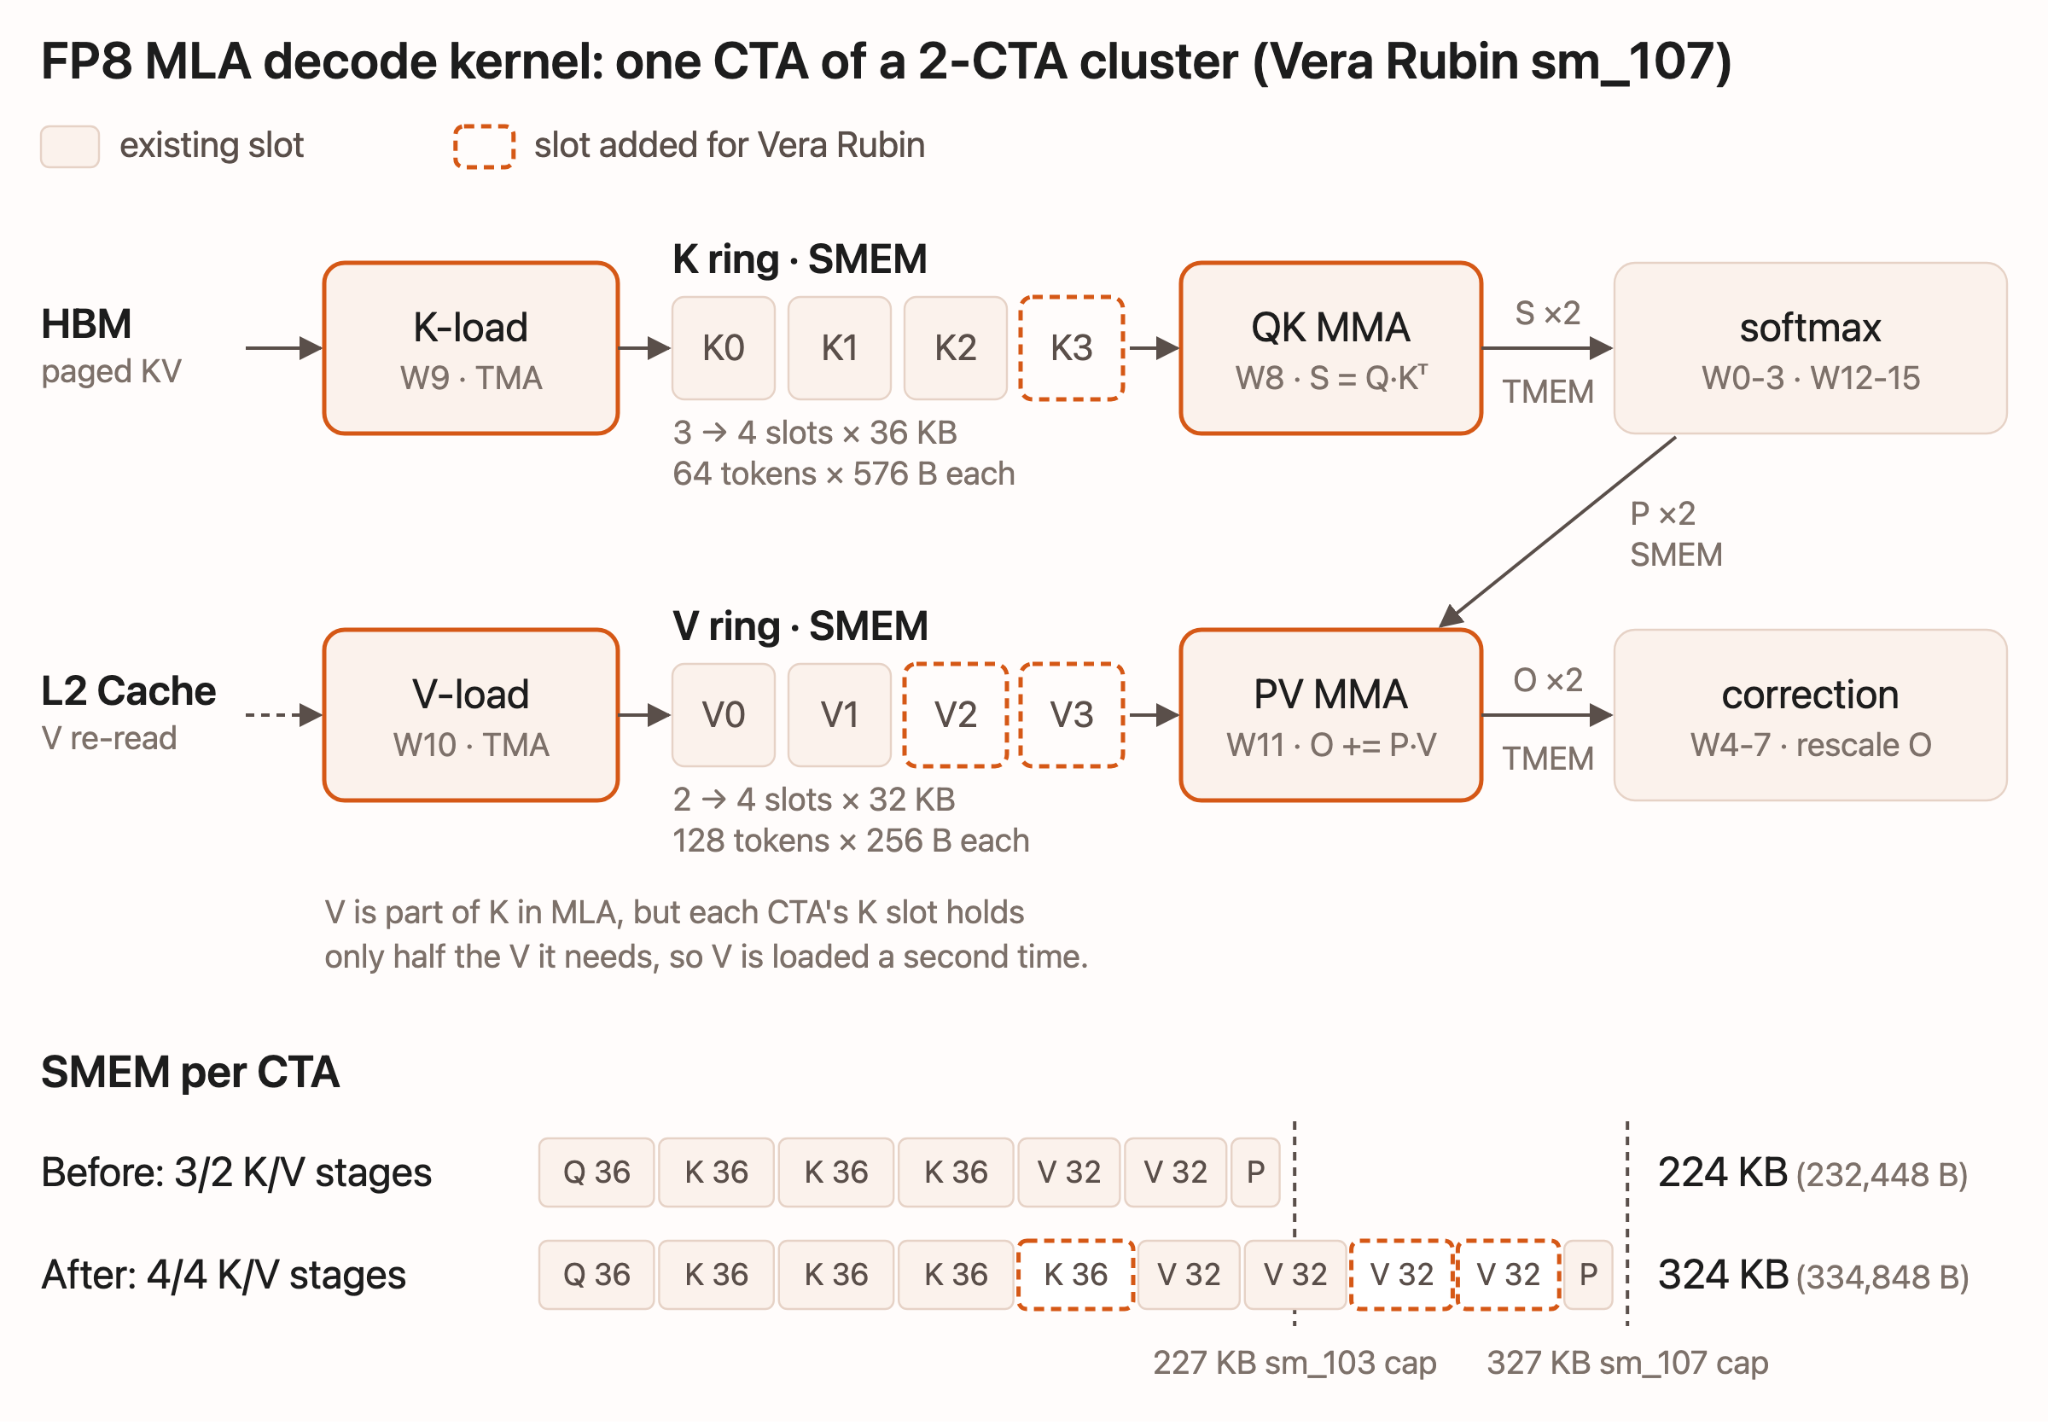
さらに、split-KV集約、64方向分割、およびネイティブFP8変換を最適化し、低並行シナリオにおけるFP8 MLAの性能を20%向上させた。
MoEと通信カーネル
MoEの末尾操作を融合し、finalize・all-reduce・RMSNormを単一のコレクティブカーネルに統合することで、276回の起動オーバーヘッドを排除し、エンドツーエンドで5.9%の性能向上を達成した。また、push all-reduceの閾値を256行に調整し、潜在的なall-gather GEMMをTensor Coreへ移行した。
KDA最適化
KDA verifyカーネルを再構成し、conv重みをレジスタに保持してCTAバリアを排除することで、本番カーネルの実行速度を20%向上させた。
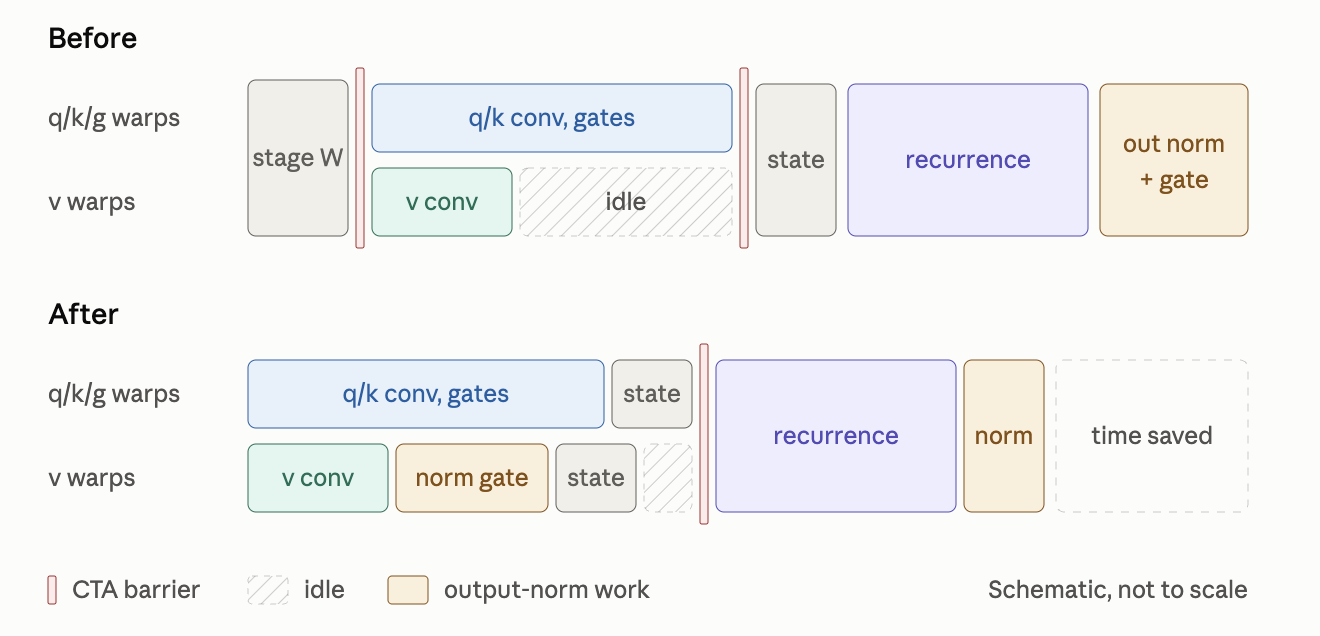
ストライドゲート読み取りのサポートにより、PyTorchの暗黙的コピーを回避し、単一ステップのデコード時間をさらに1.8%短縮した。
強化学習訓練:Miles on Vera Rubin
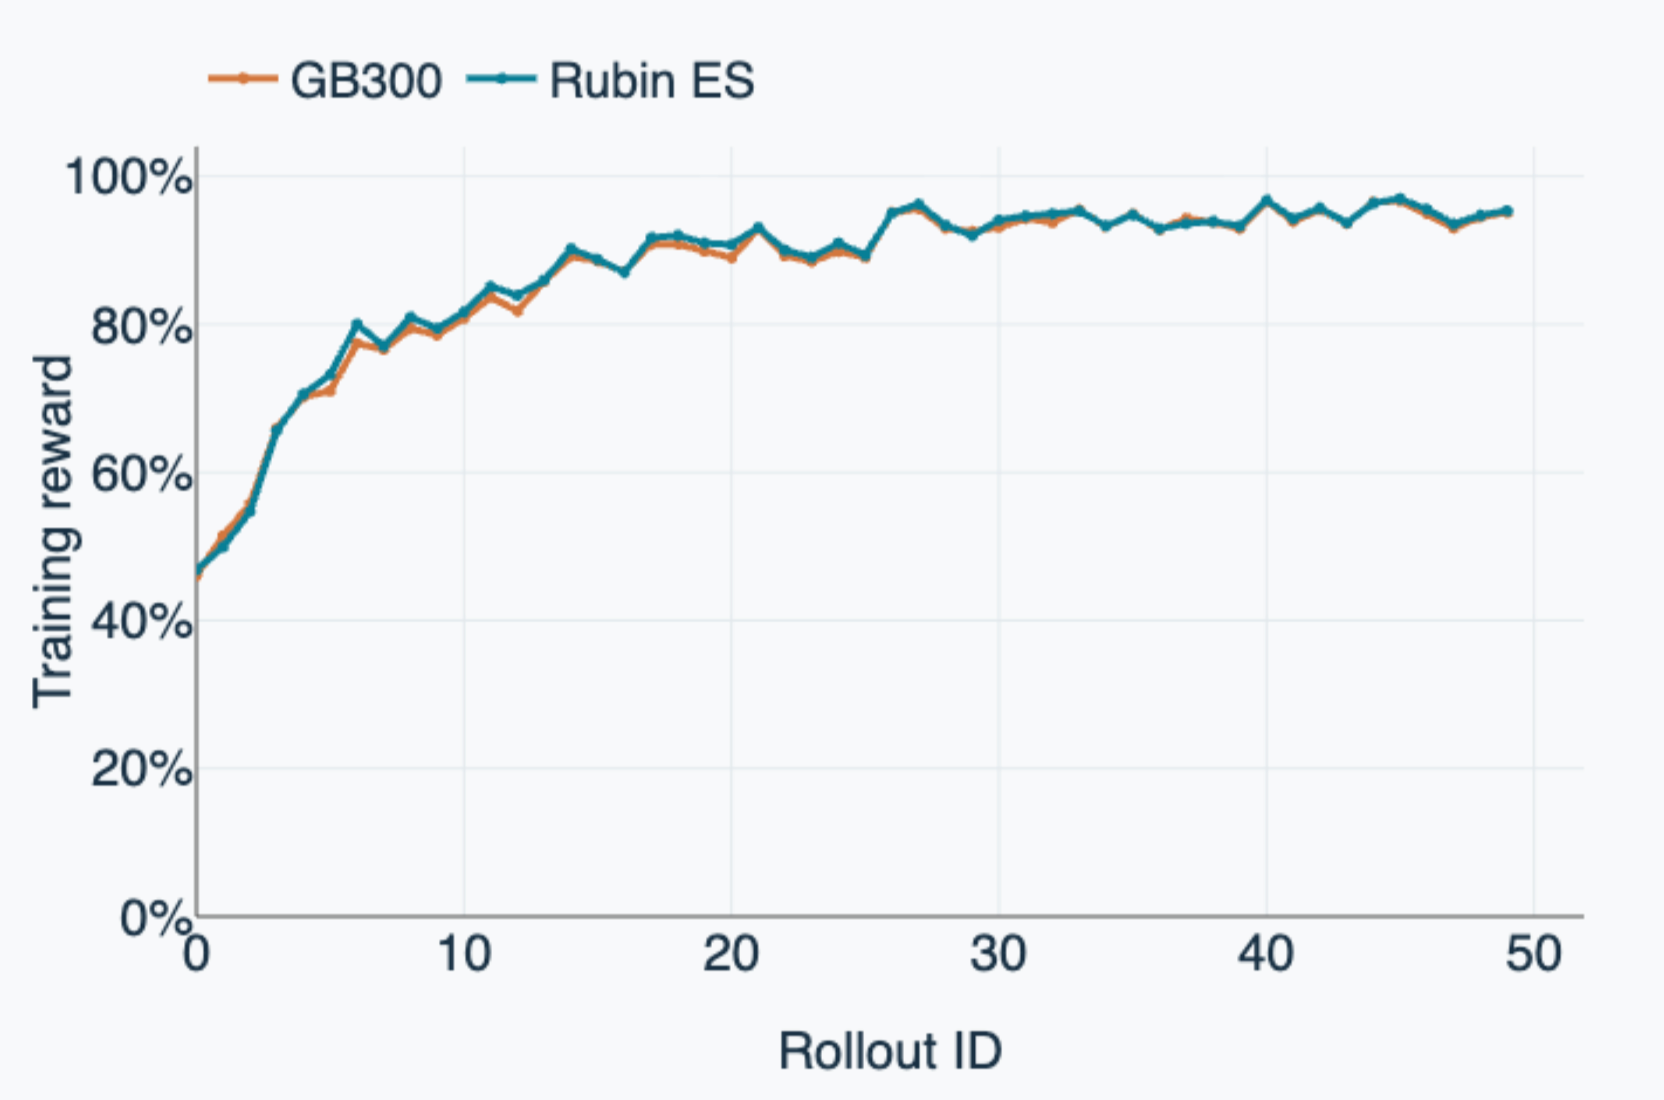
Milesフレームワークは、ロールアウトにSGLang、訓練にMegatronを使用し、単一コンテナイメージでVera Rubin上のRLタスクをエンドツーエンドで実行できる。Qwen3-30B-A3BのGSM8Kにおける報酬スコアは45%から95%へ向上し、GB300の学習曲線と完全に一致した。
DeepSeek-V4-Flash FP8パスの動作確認も完了した。
Vera CPUを活用したAgentic RL
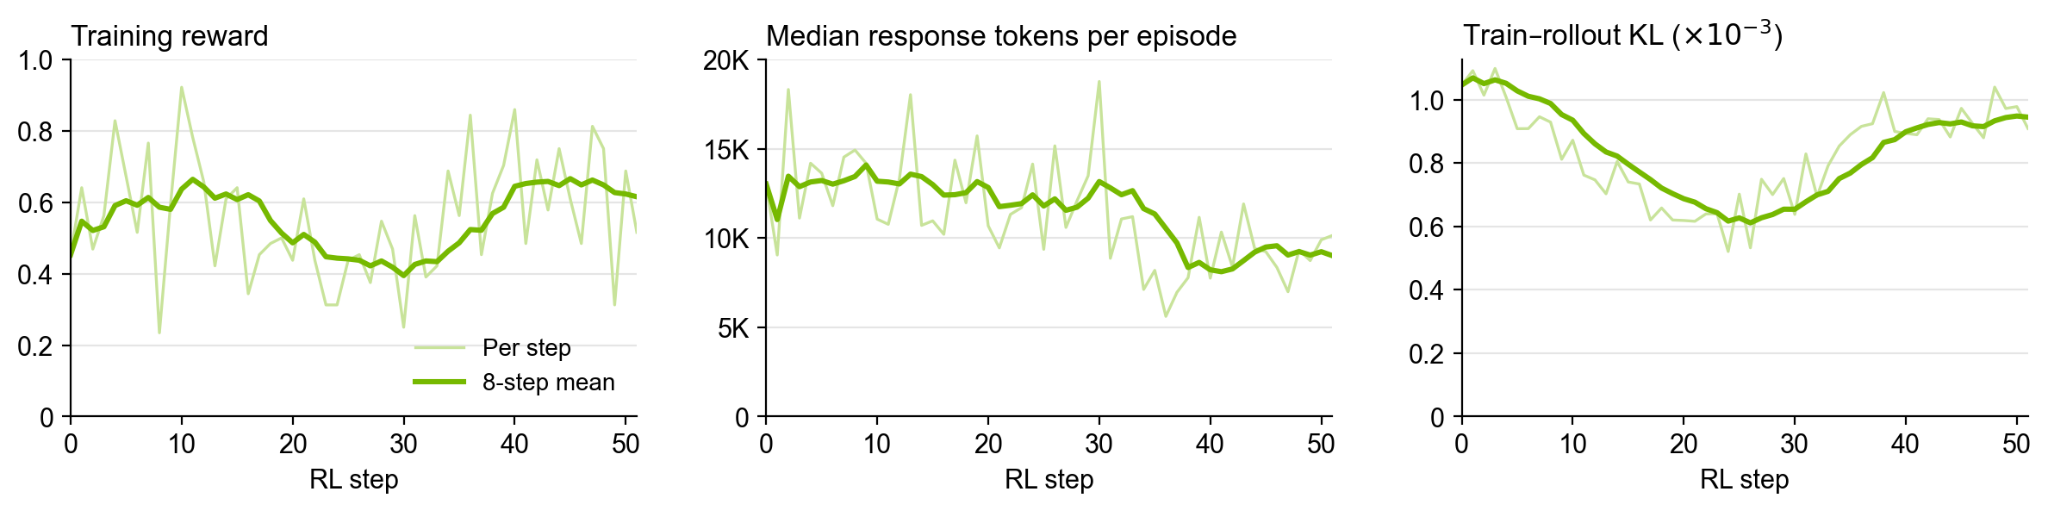
NeMo GymをVera CPU上で実行し、mini-SWE-agent环境を64サンドボックス並行で動作させた。SWE-bench Verifiedタスクの報酬は0.6前後で安定し、応答長は30%短縮した。
今後の展望
チームは引き続き推論最適化の拡充と、大規模Agentic RLにおける並行環境サポートの強化に取り組む予定である。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接