
概要
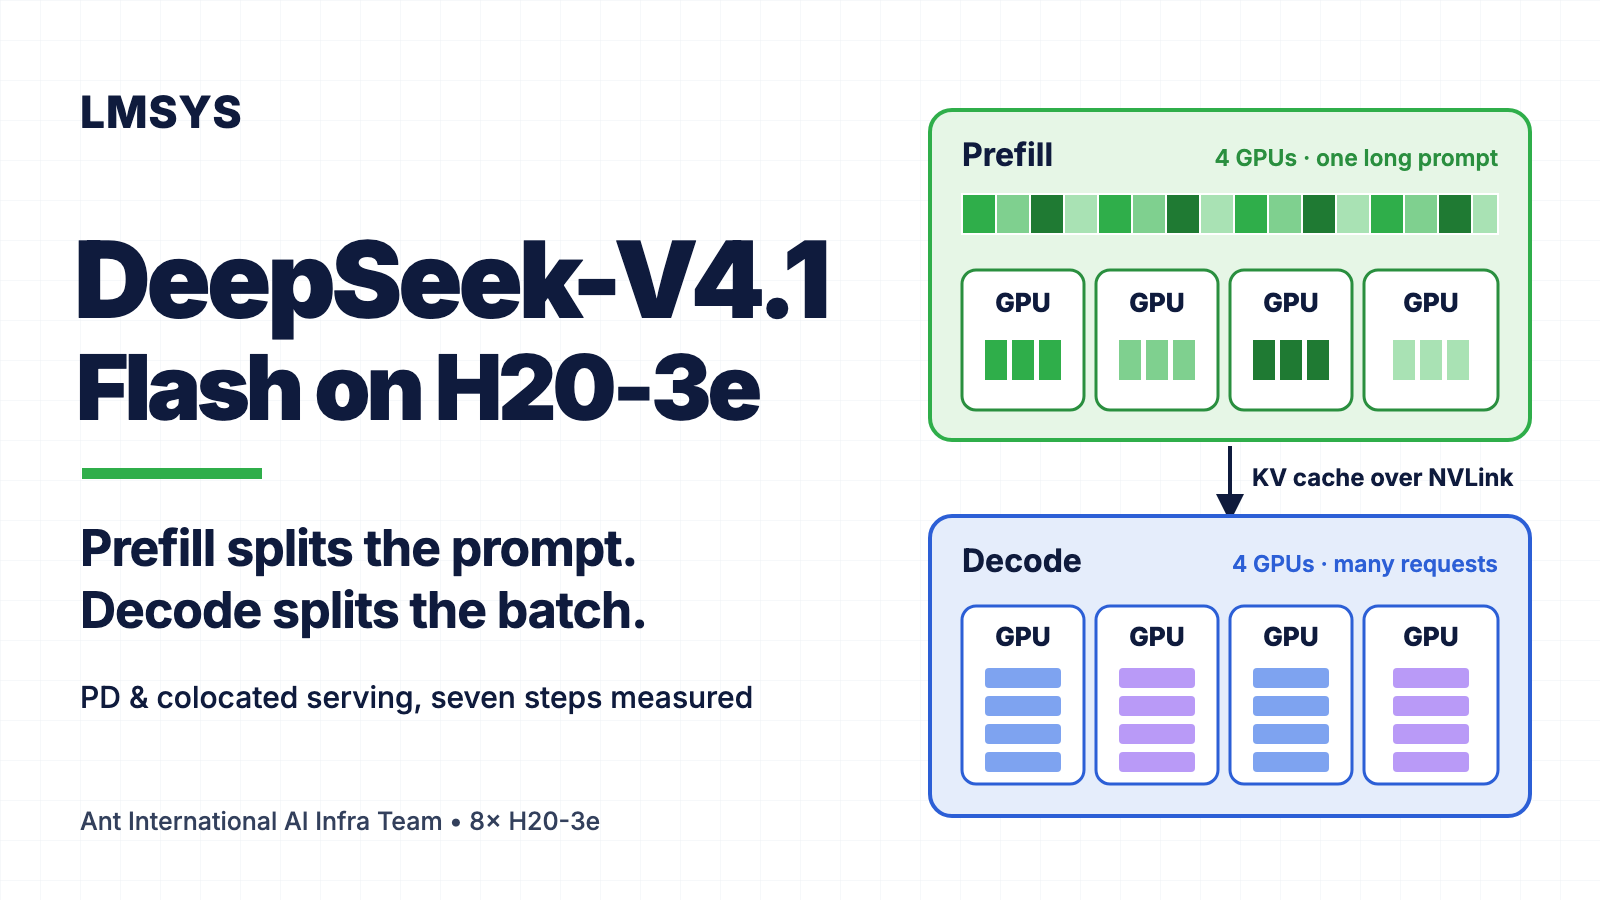
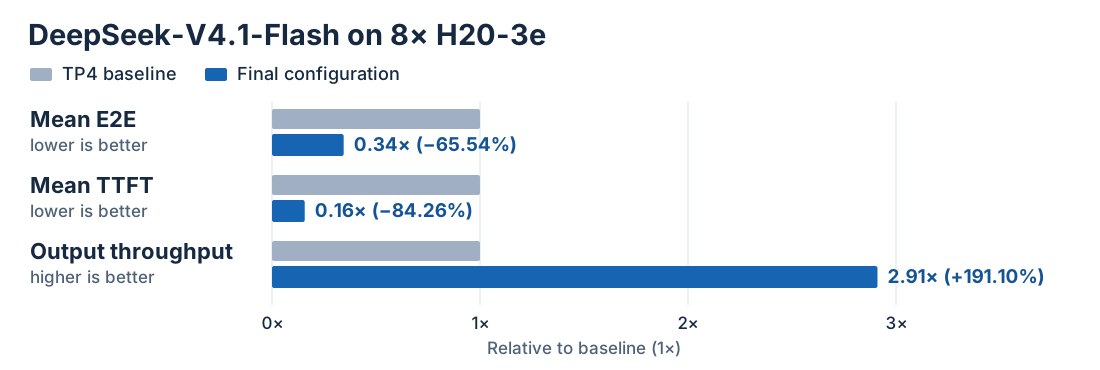
Ant International AI Infra チームは H20-3e 上で DeepSeek-V4.1-Flash の分離式サービスを最適化した。prefill と decode の並列度の調整、BCG と prefill CP および有界 SWA リプレイのサポート、Indexer カーネルの高速化を通じて、最終的な構成は TP4 比で平均エンドツーエンドレイテンシを 65.5% 削減し、出力スループットを 2.91 倍に向上させた。
ノード内 PD デプロイでは、prefill と decode がそれぞれ 4 枚の GPU を使用し、NVLink を介して KV キャッシュを転送する。平均エンドツーエンドレイテンシは 13.63 秒から 4.70 秒へ、出力スループットは 847 tokens/s から 2,465 tokens/s へと向上した。
測定設定
ルーターはリクエストをそれぞれ prefill フェーズと decode フェーズに振り分け、ワーカーは Mooncake NVLink を通じて KV 状態を直接転送する。ベースラインは両ワーカーで TP4 アテンションと EP4 MoE を実行し、prefill スコアリングには eager BF16 Torch を使用する。
1. Prefill CP と Decode DP
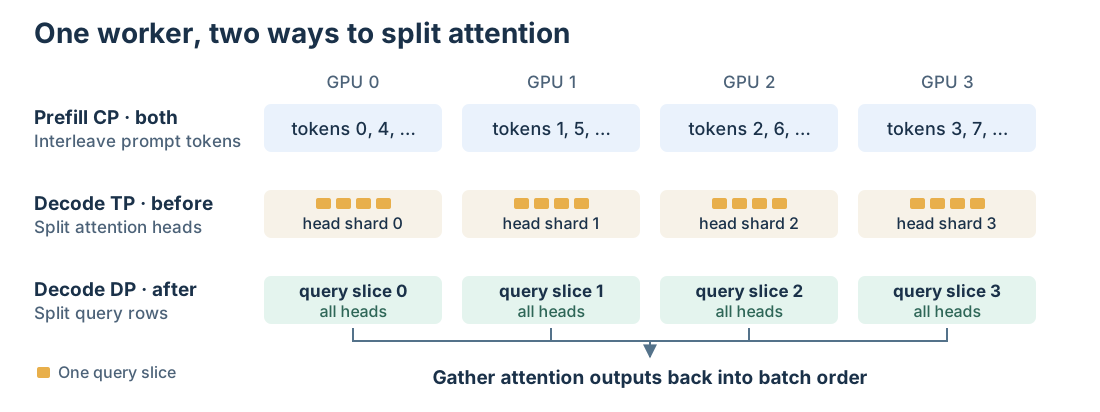
Prefill にはインターリーブドコンテキスト並列(Interleaved CP4)を、decode にはデータ並列(DP4)アテンションおよび LM ヘッドを採用する。このステップにより、平均 TTFT は 12.04 秒から 5.16 秒に短縮された。
2. Prefill Indexer への FP8 DeepGEMM 適用
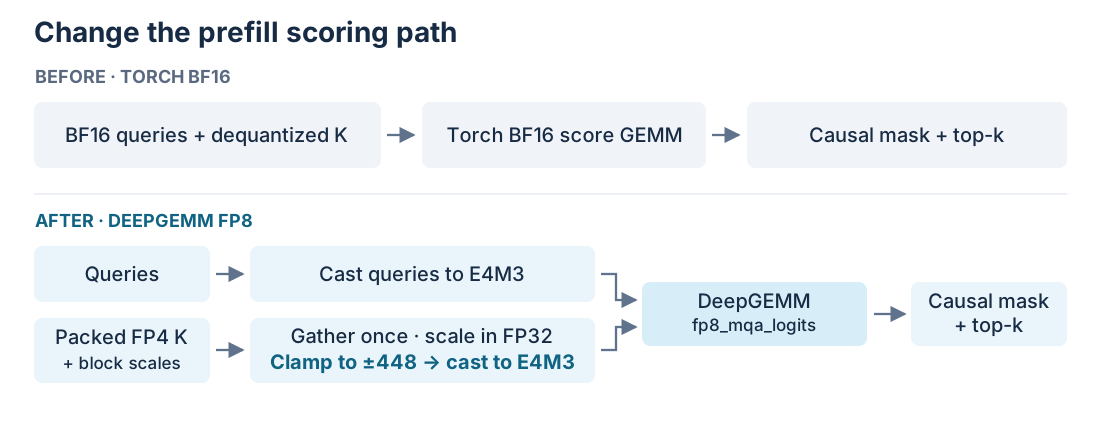
Indexer はプリフィルフェーズにおいて DeepGEMM の fp8_mqa_logits を使用してスコアリングを行い、キーと値は FP4 スケーリングおよびクランピングを経て E4M3 に変換される。
3. Prefill への Breakable CUDA Graphs 適用
Breakable CUDA Graphs によってグラフの安全なセグメントをキャプチャしてリプレイし、有界 SWA リプレイと組み合わせることで、小カーネル起動のオーバーヘッドを削減する。
4. Tensor-Parallel MoE
TP MoE を採用してエキスパートを全ランクにシャーディングし、EP 下でのエキスパート負荷不均衡を回避する。
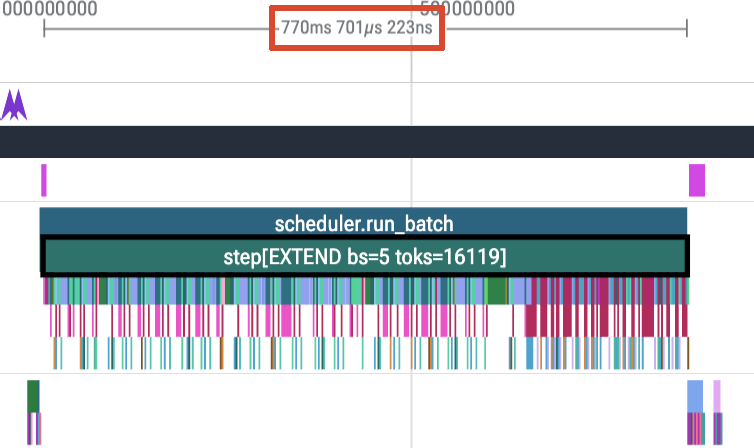
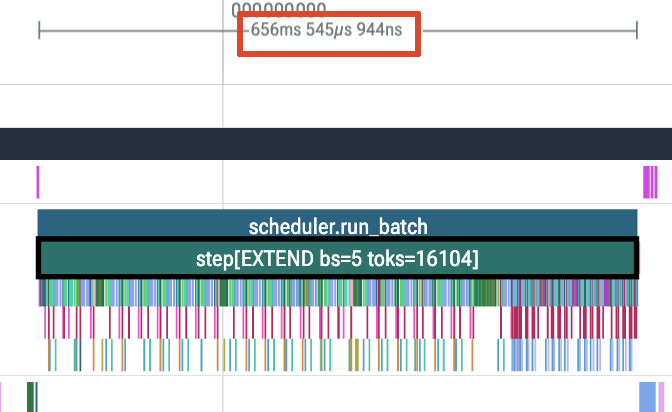
Prefill タイムラインの比較では TP モードがより高速であることが示された。
5〜7. その他の最適化
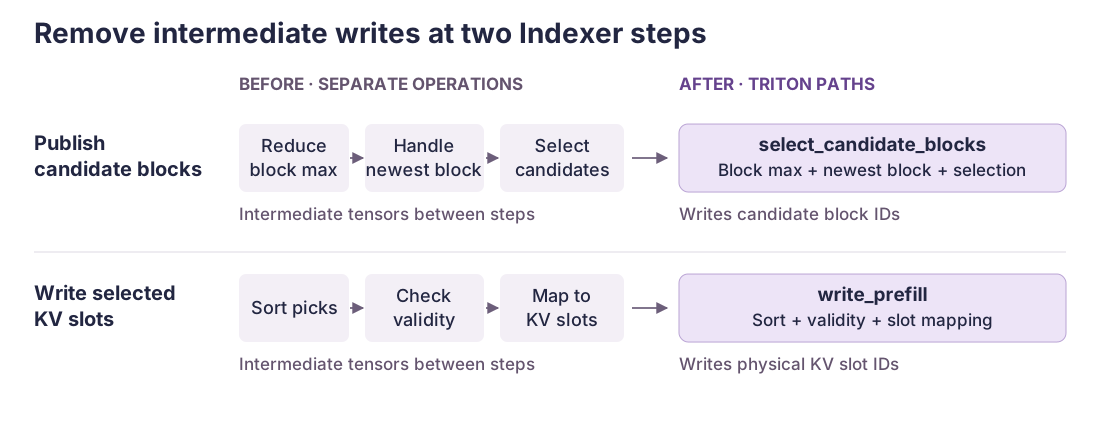
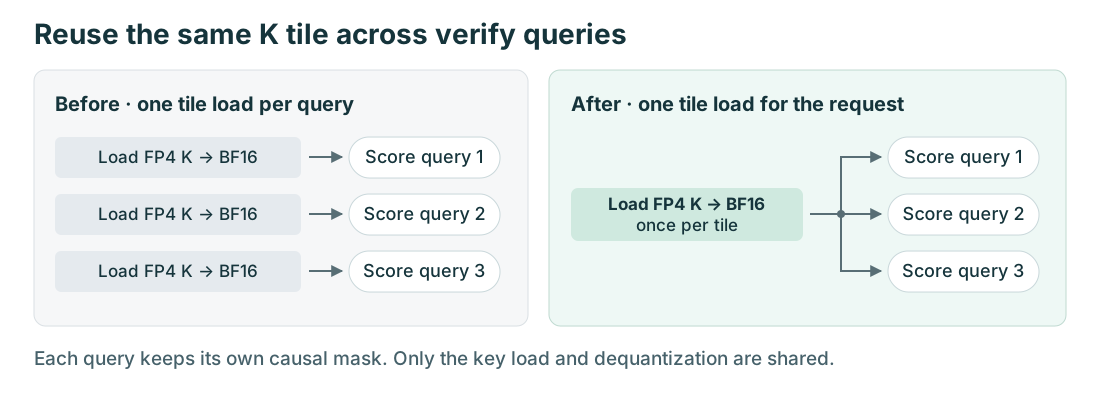
Indexer スコアタイルの拡大、prefill セレクションとライトバックの融合、ページ化 K タイルの再利用を含むさらなる微調整により、性能を追加改善した。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接