
AIインフラに馴染みの薄い方はご存じないかもしれないが、MLCommonsはオープンソースエンジニアリングコンソーシアムであり、グローバルなAI性能測定における権威ある標準策定機関だ。従来のMLPerf ベンチマークは主に単体チップの性能を測定するものだったが、今回新たに公開されたMLPerf Endpoints v1.0はより大きなシステムに焦点を当て、本番環境に近い負荷下でリアルタイムAPIエンドポイントの性能を測定する。
このベンチマークが評価するのは、真空状態でチューニングされたアクセラレータではなく、ハードウェア、モデル、サービングソフトウェア、バッチ処理動作、ネットワークを含むAI技術スタック全体の総合的な性能であり、購入者やシステム構築者にとってリアルワールドの能力を直感的に把握できる洞察を提供する。
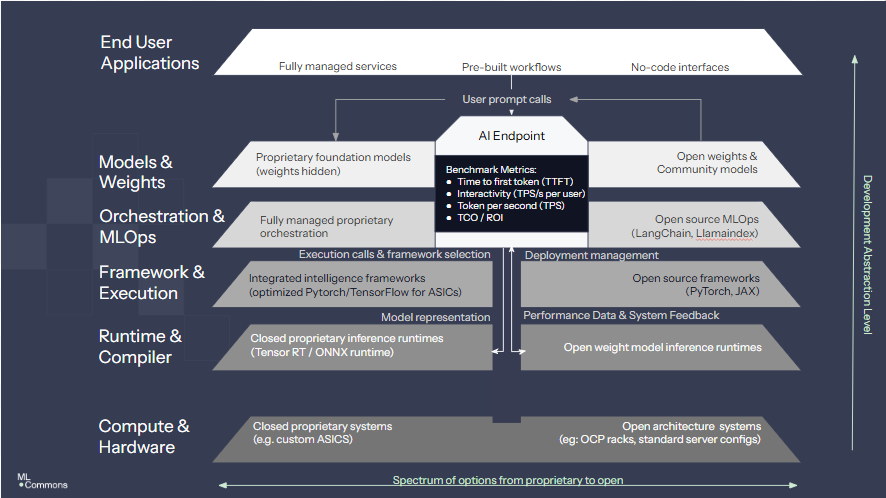
なぜMLPerf Endpoints v1.0がプロバイダーおよびシステム構築者にとって重要なのか
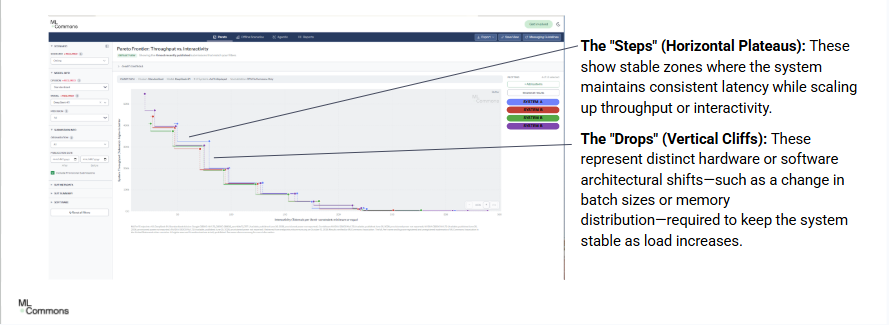
クラウドプロバイダー、ハードウェアOEM、マネージドサービス事業者、「ニュークラウド」企業にとって、既存のAIベンチマークはチューニング競争に陥りがちで、実際のビジネス価値を反映しない場合が多い。MLPerf Endpoints v1.0は完全なパレートフロンティアを生成することで、単一のピークスコアではなく、さまざまなワークロード下でのシステムの実際の挙動を示す。推定や補間は一切行わず、実測データのみを使用することで、顧客が遭遇しうる性能の崖を明確に浮き彫りにする。
業界における信頼性の確立とフルスタックイノベーションの可視化
提出されたシステムは業界の競合他社および第三者監査による厳格なピアレビューを受けることができ、エンジニアリング、セールス、マーケティングの各チームに対して異論の余地のない権威性を付与する。カスタムスケジューラーの革新やネットワーク構造の最適化を行った場合、従来のベンチマークではこれらのイノベーションが見過ごされる可能性があるが、Endpointsはフロンティアデータセット全体を完全に測定するため、ソフトウェアおよびインテグレーションエンジニアリングの成果を正当に評価できる。
実際のワークロードプロファイル
v1.0スイートは人工的・合成的なテストを使用せず、顧客が今日実際に使用しているワークロードを採用しており、単純な単発タスクから複雑なマルチターンAIエージェントまで対応する。タスクファミリーには、Summarization(Llama 3.1 8B Instructなど)、Reasoning(DeepSeek-R1)、Agentic Coding(Qwen 3.6など複数モデルによるマルチターントラジェクトリ)が含まれる。
MLPerf Endpoints v1.0への提出プロセス
このベンチマークはエンジニアリングのオーバーヘッドを大幅に削減し、数週間ごとにリリースキューを形成するローリング提出方式をサポートする。具体的な手順は次のとおりだ:CLAに署名してPRISM APIキーを取得し、リファレンスクライアントをインストール、パレートフロンティアを計画(Agenticは7測定点、非Agenticは8〜32測定点が必要)、inference-endpointツールを実行してスループットおよびTTFT P90などの指標を収集、system_desc.jsonとsystem_power.jsonの開示ファイルを作成、ローカルでコンプライアンスを検証し、最終的に提出してピアレビュー用のPRを生成する。
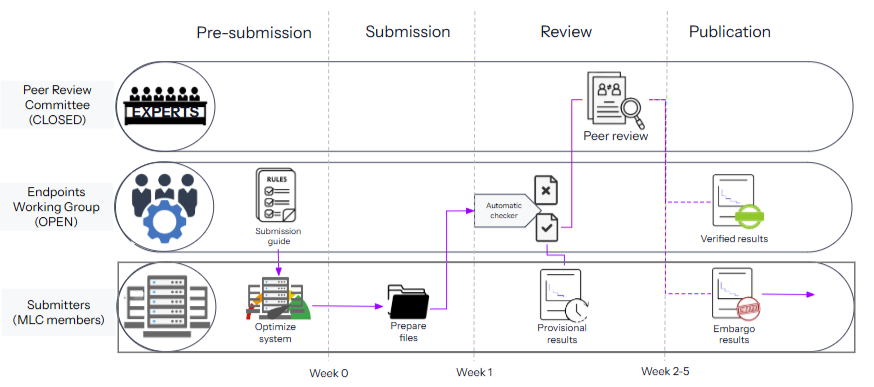
提出後、結果は継続的なピアレビュープロセスに入り、最終的に直感的なMLPerf LoadStair可視化グラフが生成される。MLCommonsは自動チェック完了後に暫定結果を共有することも認めており、最終的な検証結果は必要に応じてエンバーゴを設定して公開することができる。詳細については公式の初回提出者ガイドを参照されたい。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接