
DeepSeekは自社推論エンジンDeepInferと関連カーネルをオープンソース化し、DeepSeek-V4.1-Flashの推論速度における新たな基準を打ち立てた。SGLangチームはその後、同一ハードウェア上でDeepInfer自身のベンチマークを用いてSGLangとの比較テストを実施した。結論は明快だ:SGLangはDeepInferの重要な最適化を統合するだけでなく、複数の指標で同等以上の性能を達成し、さらにDeepInferのリリース版には含まれていない完全なサービングシステム機能も提供している。
主要な結論
- DeepInfer自身のベンチマークで同等以上の性能を達成。 4x GB300および4x B300上において、SGLangのprefillスループットはDeepInferの最大1.04倍を記録。64x GB300上ではdecodeステップが最大7.4%短縮され、その他のテスト点での差は1%以内に収まった。
- DeepInferの最適化がSGLangに統合済み。 SGLangのmainブランチはDeepSeekカーネルをサポートしており、Megaシリーズ、DSpark speculative decoding、SWA bounded replay、および2種類のEngram placementが含まれる。
- SGLangは完全な推論サービングシステム。 DeepInferのREADMEに記載されているKV cacheシステム、prefill/decode disaggregation、レプリカ間のロードバランシングなど、DeepInferのリリース版で提供されていない機能は、SGLangにすべて内蔵されている。
SGLangが統合した機能
SGLangはV4.1のサポート初日から、SWA bounded replayとホストメモリ上のEngram tablesをすでに稼働させていた。その後、SGLangはDeepSeekのMegaカーネル、GPU間でEngram tablesを分割してdirect peer readsを行う機能、およびさらなる実行レイヤーの最適化を追加した。
DeepSeekカーネル
SGLangはFlashMLA、DeepGEMM、DeepEP、DeepSelect、TileLangカーネル、およびMegaシリーズ:MegaAttention、MegaMoE、MegaGate、Mega-mHCを統合している。MegaMoEはtoken dispatch、expert GEMM、combineを1つのカーネルに融合させており、MegaAttentionはB300およびGB300上でのデフォルトのattentionパスとして、単一ノード・prefillサーバー・decodeサーバーすべてに対応する。
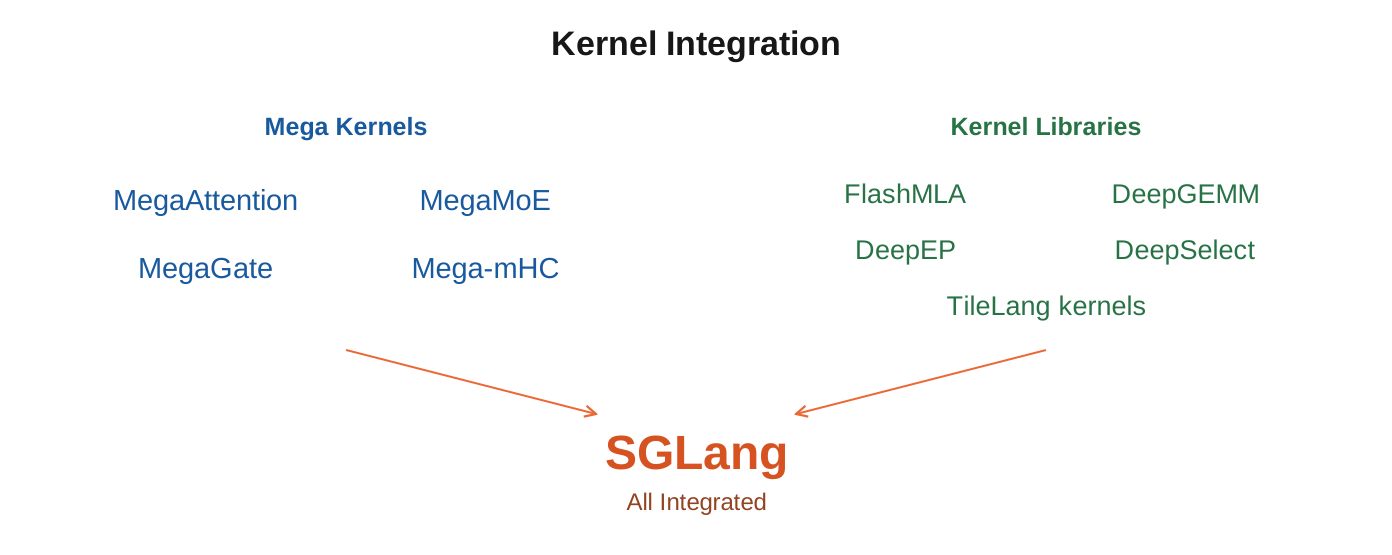
図1:SGLangに統合されたカーネル。
並列処理(Parallelism)
SGLangはprefillとdecodeの両フェーズでDP attentionとexpert parallelism(DEP)を採用している。今回のベンチマークでは、prefillにDEP4、decodeには64枚のGB300 GPU上でDEP64を使用した。また、SGLangはwide-EP展開においてexpert loadを均衡化するためのEPLBもサポートしている。
DSpark speculative decoding
SGLangはチェックポイント内のDSparkドラフトモデルを実行し、候補となるトークン群を先に提案してからターゲットモデルが一括検証する。これにより、応答生成に必要なターゲットモデルのフォワードパス回数を削減できる。
SWA bounded replay
decoder replayにおいて、後段のデコーダーレイヤーはプロンプトの末尾128トークンのみを処理し、前段のソースレイヤーは引き続きプロンプト全体を処理する。prefix cacheがヒットした場合、encoder replayは最後にキャッシュされた128トークンを利用して、欠損しているsliding-window KVを再構築する。
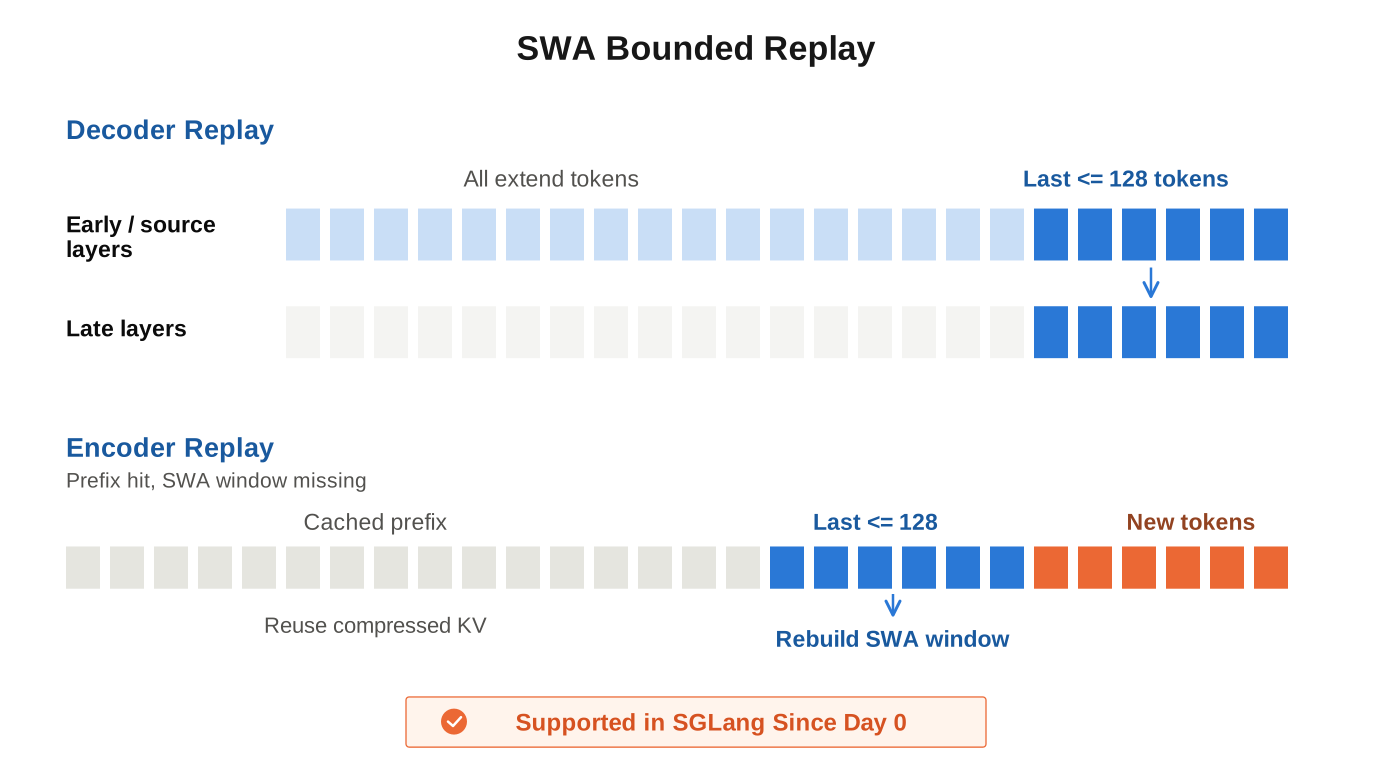
図2:SWA bounded replay(decoder replayとencoder replayを含む)。
Engram placement
DeepInferはEngram tablesをホストメモリまたはデバイスメモリに配置することをサポートしており、SGLangも同様の2つのモードをサポートしている。SGLANG_ENABLE_DSV41_ENGRAM_HOST_TABLE=1を設定すると、各ノードはホストメモリにテーブルのコピーを1つ保持し、KV cache用のHBMをより多く確保できる。SGLANG_OPT_DSV41_ENGRAM_PEER_SHARDS=1を設定すると、テーブルは複数のGPUに分割され、各GPUはNVLink経由でピアGPUから必要な行を直接読み取る。ルックアップの前後でall-gatherやreduce-scatterは不要となる。
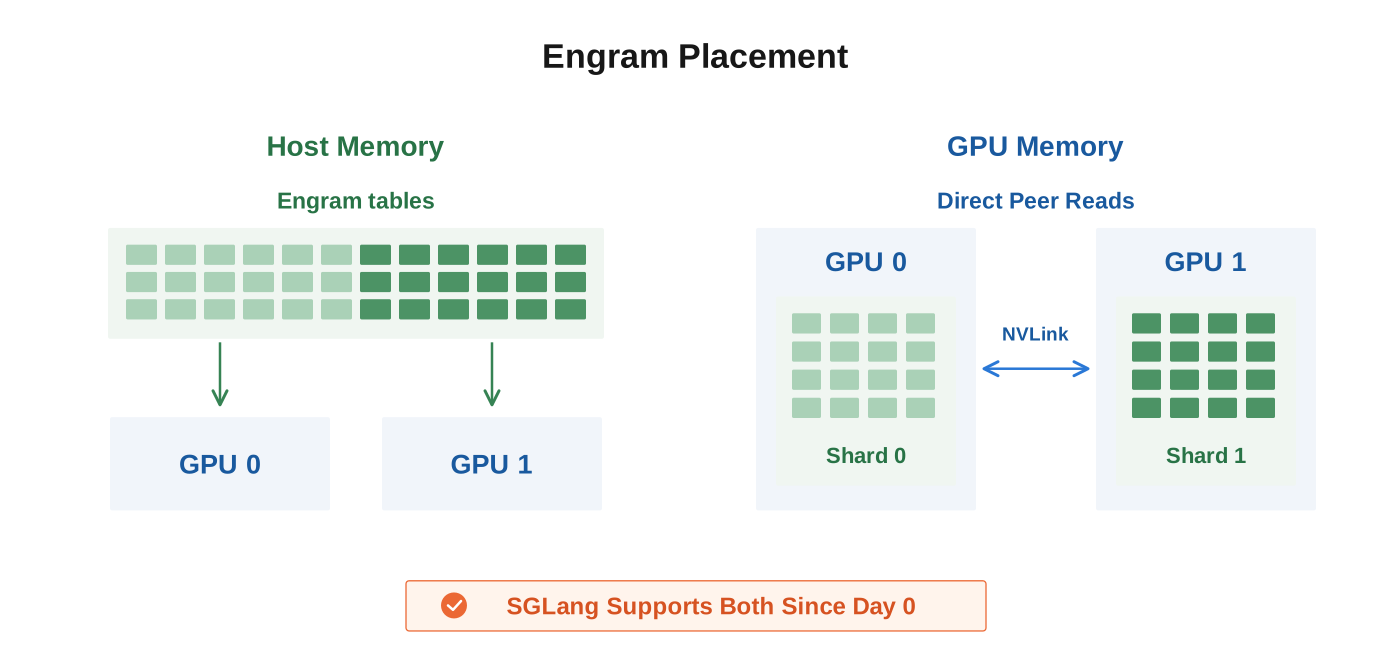
図3:Engram tablesはホストメモリに配置することも、複数のGPUに分割してdirect peer readsでアクセスすることもできる。
ゼロオーバーヘッドスケジューリング(Zero-overhead scheduling)
2024年12月リリースのv0.4以降、SGLangのスケジューラーはGPUがステップNを実行している間に、CPUが同期的にステップN+1の準備を行う。これによりスケジューリングのオーバーヘッドをGPU実行と重ね合わせる。DeepInferのドキュメントもこの設計はSGLangに由来するとしている。
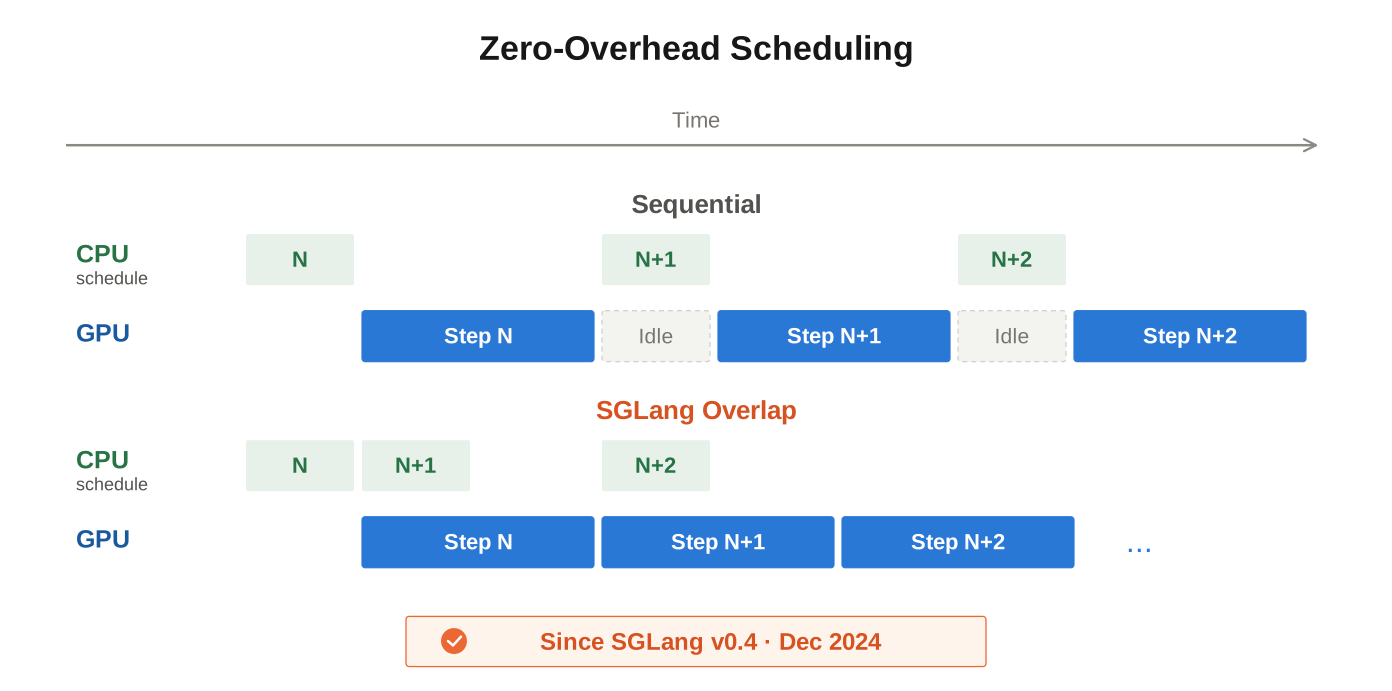
図4:Zero-overhead scheduling。GPUが現在のステップを実行しながら、CPUが次のステップを準備する。
DeepSeekチャットフォーマット
SGLangはDeepSeek自社のdeepseek-recipeパッケージを使用してプロンプトのレンダリングと出力の解析を行うため、SGLang APIではreasoningとtool callsがDeepSeekのフォーマットに従う。Grammar-constrained decodingはJSONスキーマ、regex、EBNFにも対応している。
ベンチマーク結果
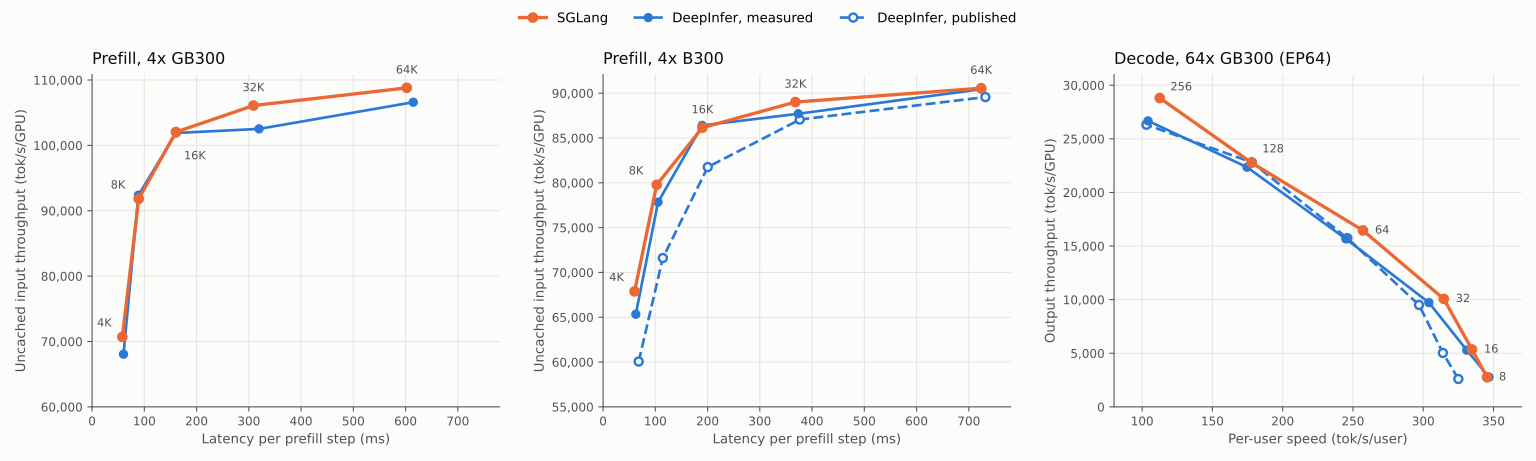
図5:4x GB300および4x B300上のprefill、ならびに64x GB300(EP64)上のdecode。
図中の実線はSGLangとDeepInferの実測結果を表し、破線はDeepInferが当初公開したprefillとdecodeの結果(公開グラフからの読み取り値)を表す。本文中のprefill比較には実測したDeepInferの曲線を使用し、各テスト点でDeepInferの最速構成を採用している。
- Prefill、4x GB300:SGLangのprefillスループットはDeepInferの最大1.04倍を達成。GPU1枚あたりステップごとの新規トークン数が4K、32K、64Kの各点でリードし、8Kと16Kではほぼ同等。
- Prefill、4x B300:SGLangは同様に最大1.04倍のprefillスループットを達成。4K、8K、32Kでリードし、16Kと64Kでは同等。
- Decode、64x GB300(EP64):GPU1枚あたりのリクエスト数が16から256の範囲において、SGLangのステップ時間は1.1%〜7.4%短縮。8 requests/GPUではDeepInferと同等。
速度の源泉
SGLangの性能向上は複数の実行パス最適化に由来する:Mega-mHCがMegaMoEに直接フィードでき、attentionがoutput projectionのためにMXFP8出力を生成し、prefill compressorとrequest-window KV copiesがfused kernelを使用する。これらの変更により、中間メモリトラフィックとカーネル起動回数が削減された。
また、breakable CUDAグラフは、長いコンテキストとdata-parallel attentionを含むGPU1枚あたり最大8Kトークンのprefillステップをカバーする。decoder replayはbounded suffixのサイズに応じた独立したグラフを使用するため、大きなprefillステップの他の部分がeagerモードで実行される場合でも、これらのレイヤーはCUDAグラフでreplayできる。
SGLangが追加で補完する機能
DeepInferのREADMEでは、完全な推論サービスには3種類のコンポーネントが必要と述べられているが、リリース版には含まれていない。SGLangはこれらすべてをすでに提供している。
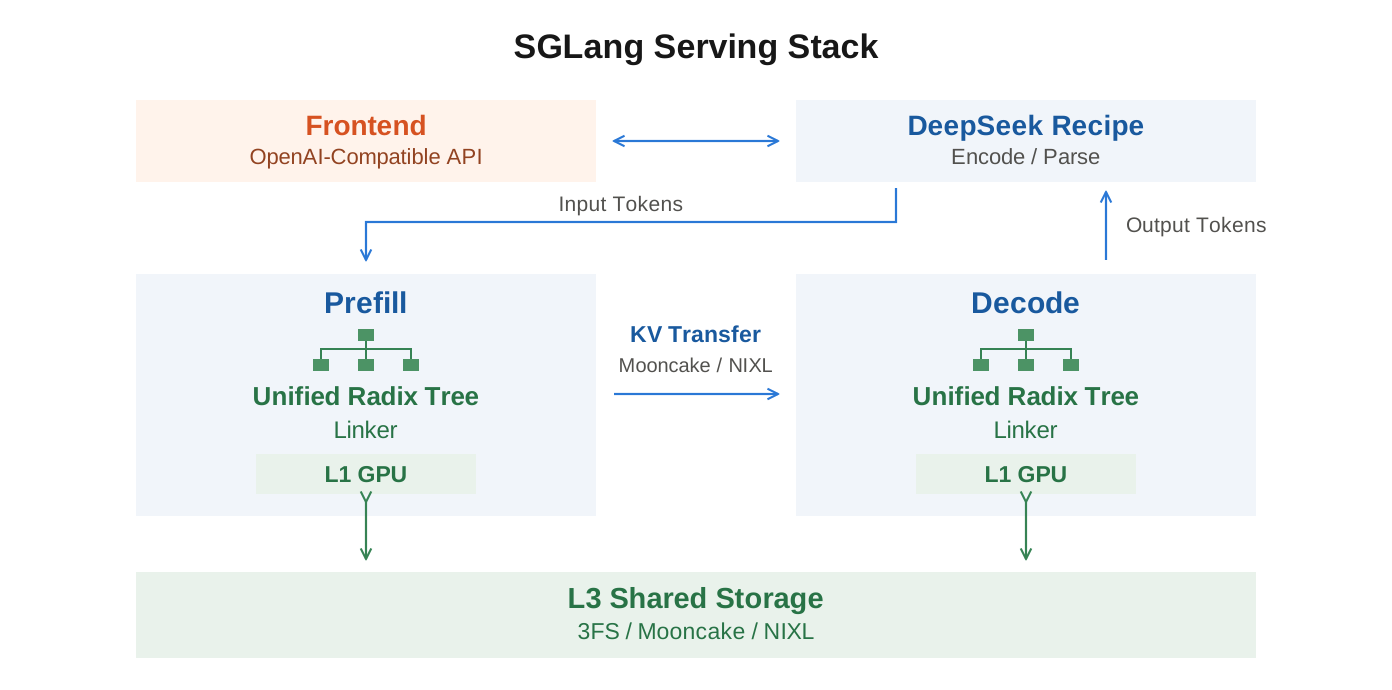
図6:SGLang serving stack。LinkerはローカルのL1 GPU cachesを共有L3 storageに直接接続する。
KV cacheシステム
SGLangのunified radix cacheはリクエスト間・会話ターン間でKVを再利用でき、このようなハイブリッドモデルにも対応する。上図の構成ではLinkerを使用してL1 GPU cachesを共有L3 storage(例:3FSやMooncake)に直接接続する。ホストメモリのL2ティアが必要な展開にはHiCacheも対応している。
Prefill/decode disaggregation
SGLangはprefillとdecodeを異なるサーバーで実行でき、KV転送バックエンドとしてMooncake、NIXL、MORIからユーザーが選択できる。
レプリカ間のロードバランシング
SGLangのモデルゲートウェイは複数のレプリカ間でリクエストを分散でき、キャッシュ済みプレフィックスに基づくルーティングもサポートすることで、キャッシュヒット率と全体的なサービング効率を向上させる。
これらの機能に加え、SGLang自体がAPIサーバーとして機能し、reasoningとtool-call parsingをサポートし、NVIDIA GB300、B300、B200、H200およびAMD MI355Xなどのハードウェアプラットフォームに対応している。
ベンチマーク設定
両エンジンとも同一ハードウェア上でDeepInfer付属のベンチマークを実行した。SGLangはprefillテストにcommit 7d996300b9、decodeテストにcommit 3b95120f00を使用し、DeepInferはcommit 774ce24を使用した。両者の起動コマンドとベンチマーククライアントはgistで公開されている。実際のモデルサービングに使用する場合、SGLangチームはDeepSeek-V4.1 cookbookを参照することを推奨する。本文中の一部の設定(balanced expert routingなど)は主に公平な比較のために存在する。
Prefillワークロード
prefillにはDeepInferのprefillベンチマークを使用:各リクエストは128Kトークンのコンテキストと4Kの新規トークンで構成され、GPU1枚あたりステップごとにB個の新規トークンをプリフィルし、Bの範囲は4Kから64K。両エンジンとも同一の4-GPUノードで実行し、同一の重み、DP4/EP4、balanced expert routing、EPLBオフ、32個のredundant expertを使用した。DeepInferについては、各点でEngram placementの2種類のうち最速の結果を選んで比較した。
謝辞
SGLangチームはDeepSeekがDeepInfer、FlashMLA、DeepGEMM、DeepEPをオープンソース化し、推論システムの設計を詳細に公開したことに感謝する。これらの取り組みはコミュニティに明確なパフォーマンス基準を提供し、オープンソース推論スタックの継続的な最適化を推進するものである。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接