
KVキャッシュは現代のLLM推論システムの中核コンポーネントである。マルチターンAgentセッションのコンテキストはキーバリューペアの形式でGPUメモリにキャッシュされ、後続のデコードステップで再利用される。コンテキストウィンドウの拡大に伴い、KVキャッシュがVRAM容量と帯域幅に与える負荷はますます大きくなっている。
NVFP4フォーマットと二段階スケーリング
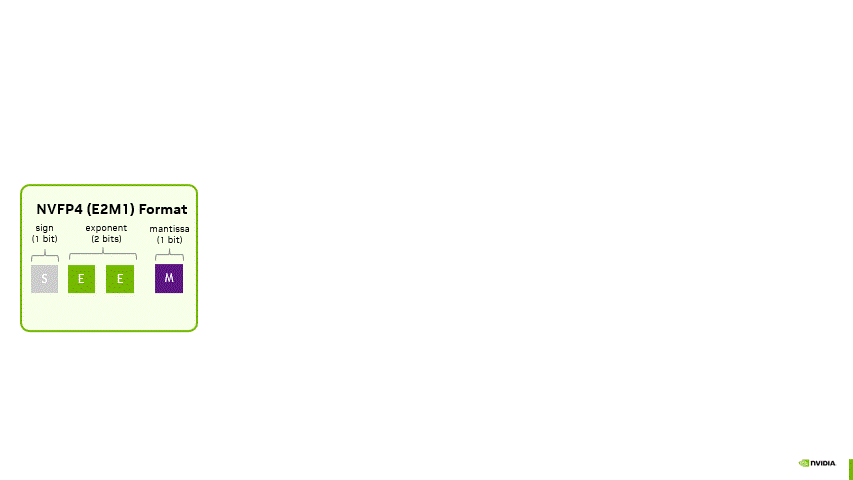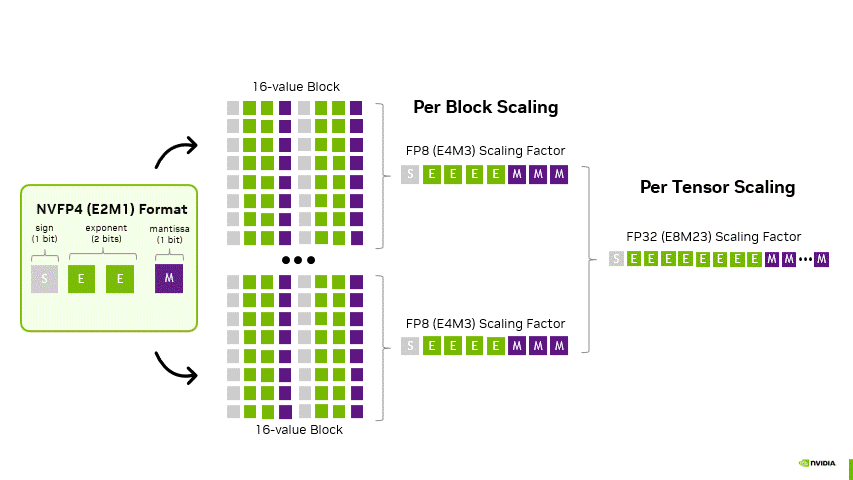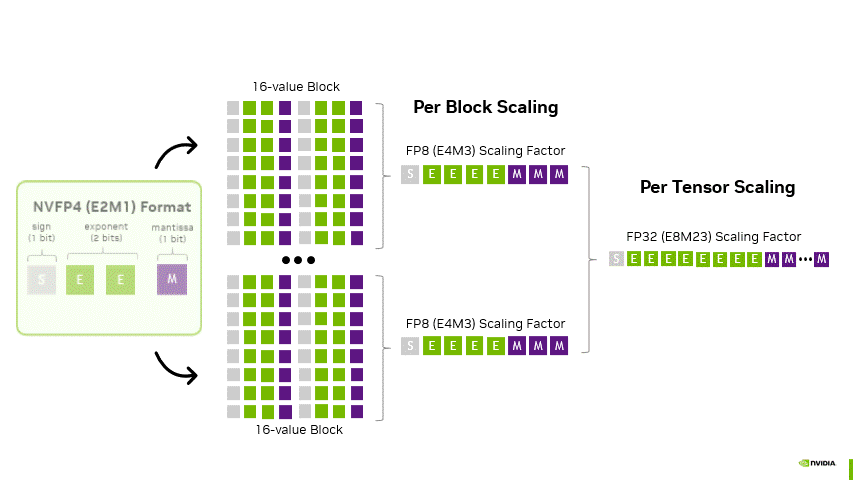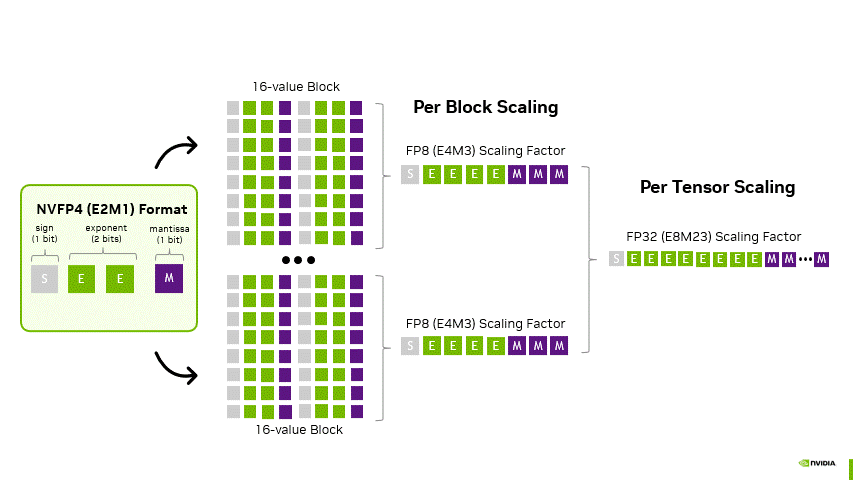
NVIDIAはBlackwellアーキテクチャにおいてNVFP4フォーマットを導入した。E2M1の4ビット値に加え、16値ブロック単位のFP8ブロックレベルスケーリングとFP32テンソルレベルスケーリングを組み合わせることで、量子化誤差を効果的に抑制する。
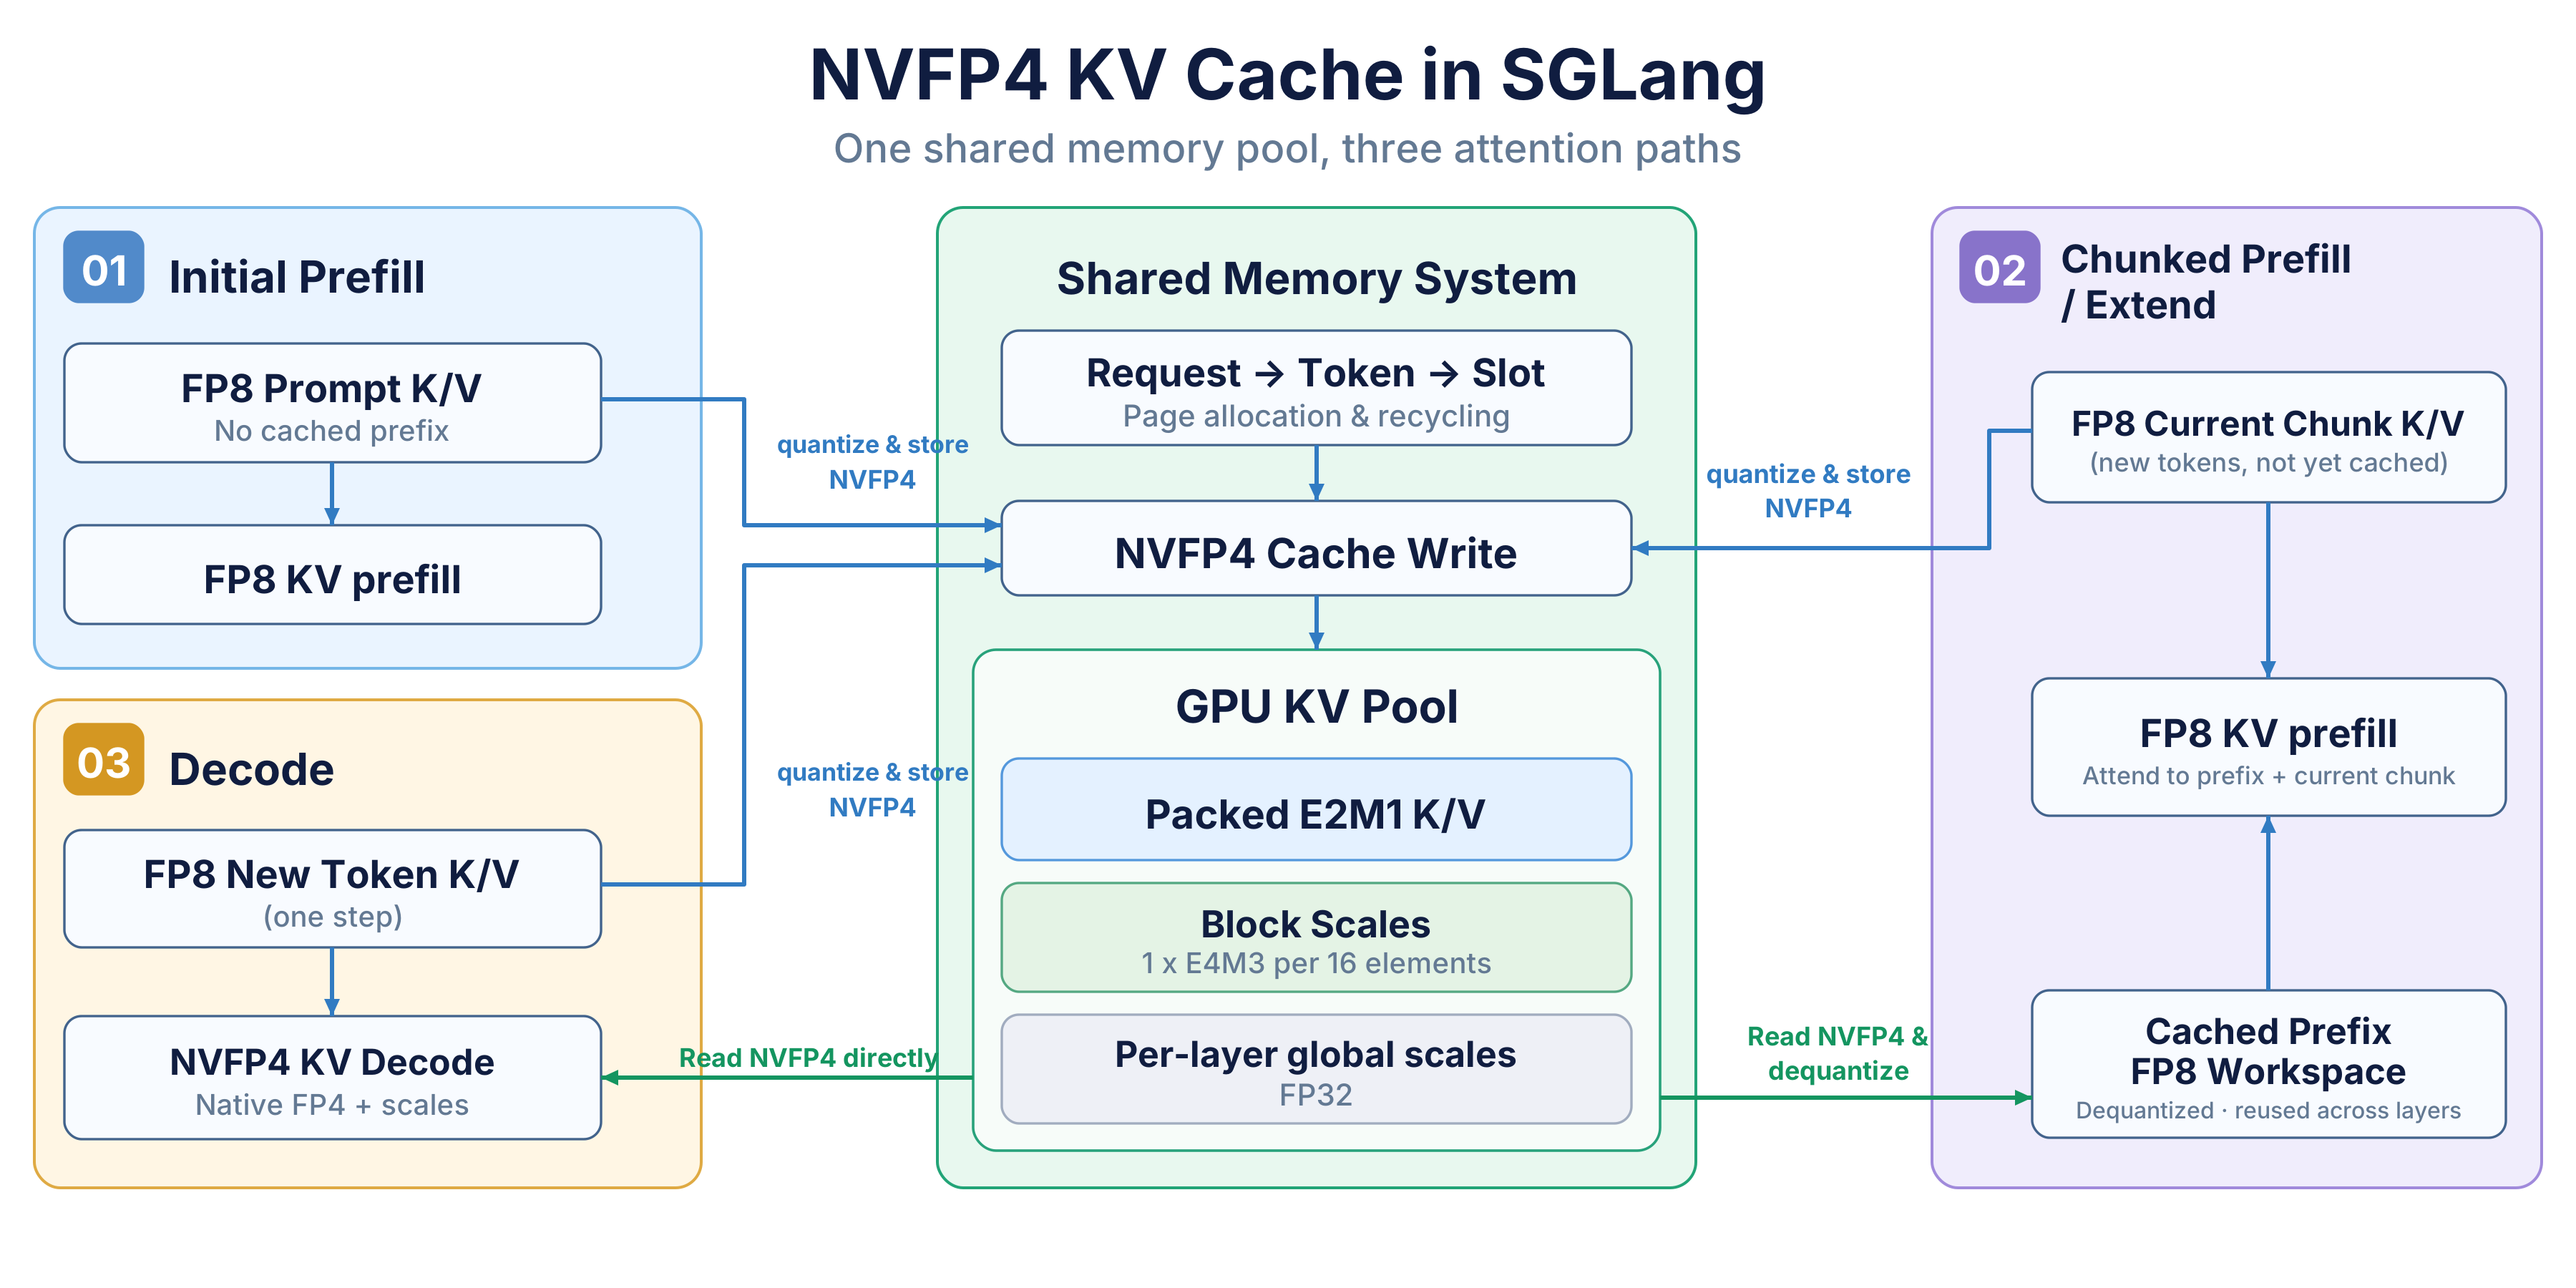
SGLangにおけるNVFP4 KVの実装
実装はSGLangのページングKVキャッシュと、初期プリフィル・ブロック単位プリフィル/拡張・デコードの3種類のアテンションパスを接続する。
デコードアテンションカーネルの設計
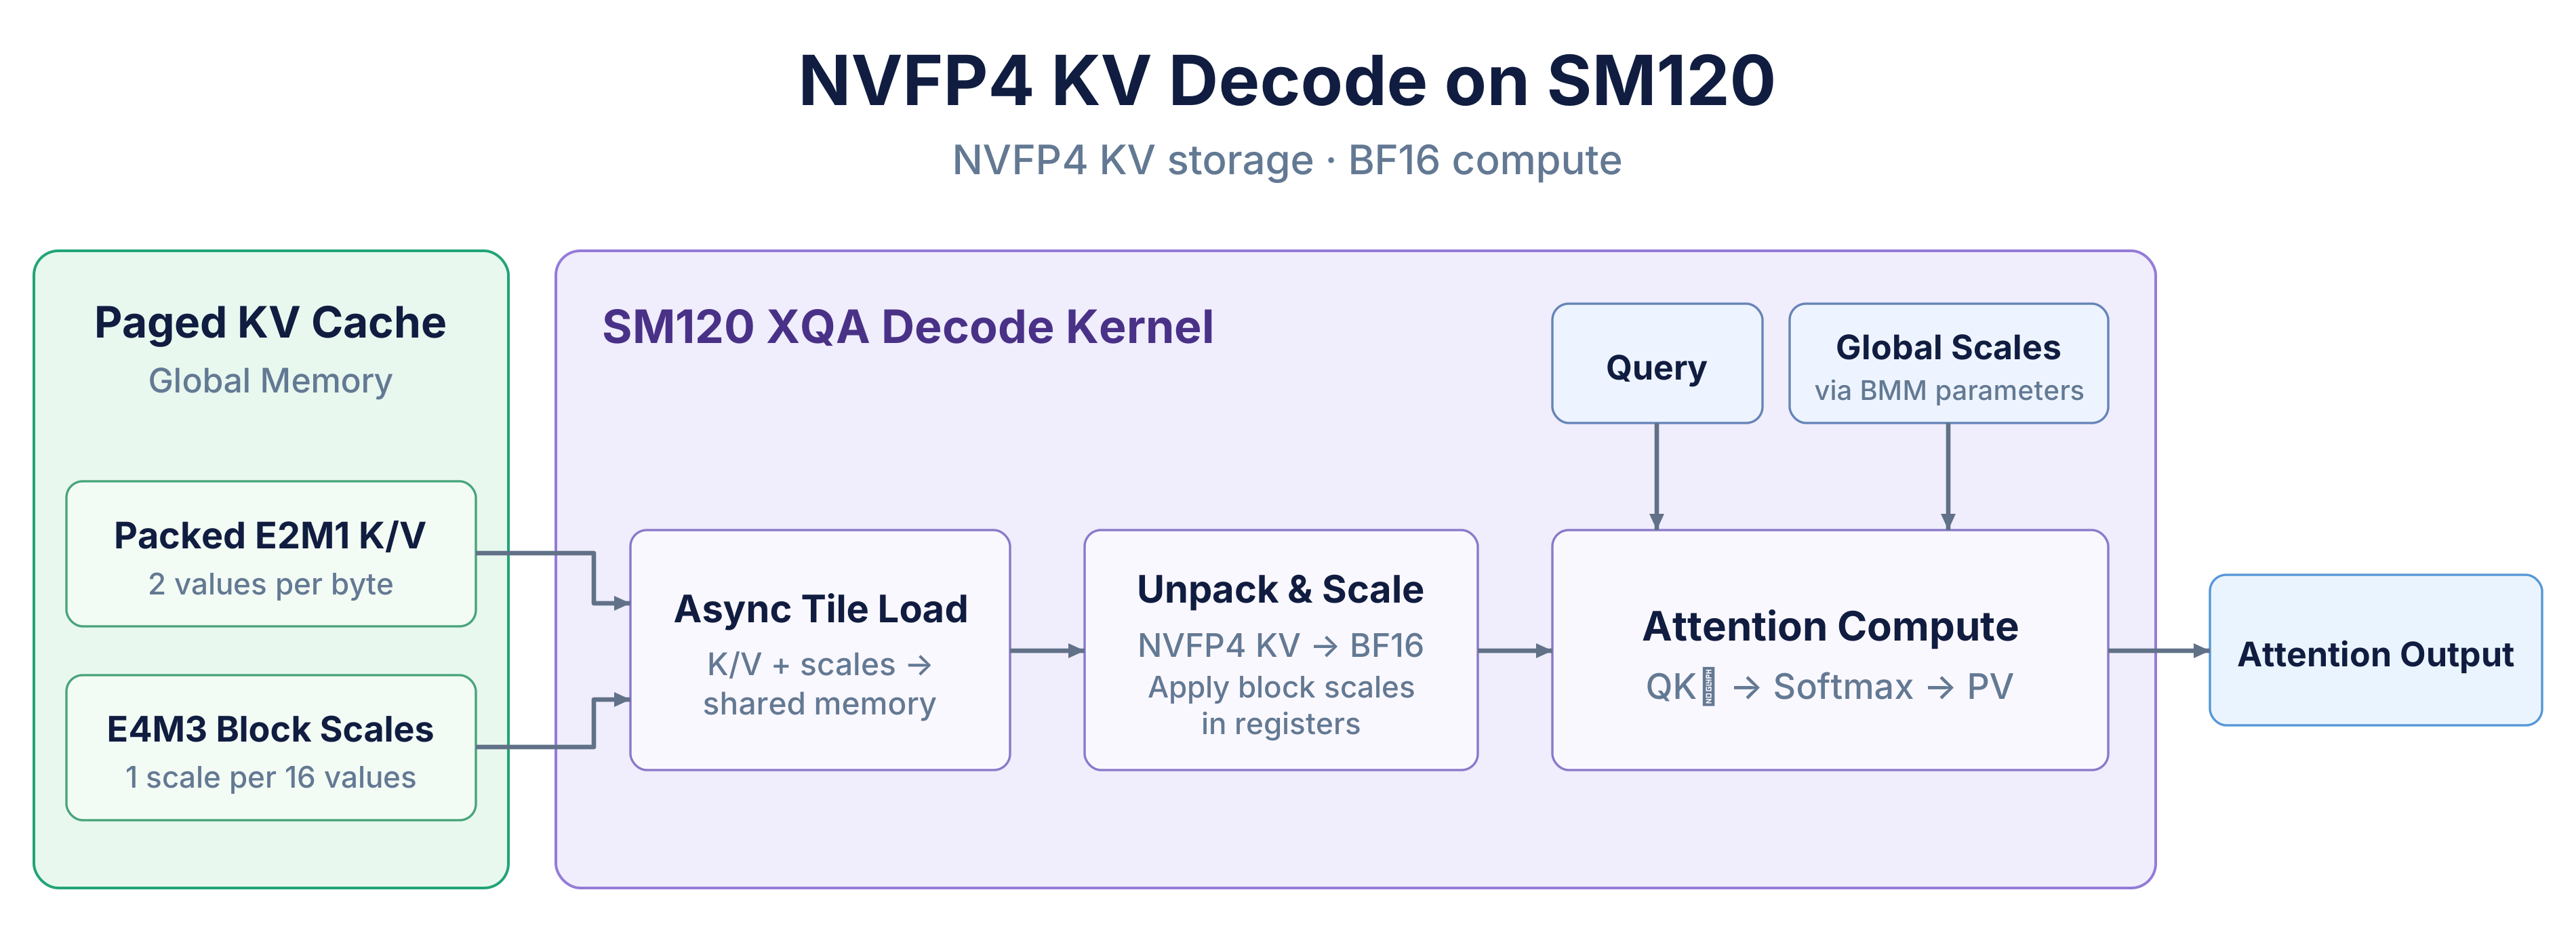
デコードフェーズのカーネルはNVFP4 KVキャッシュから直接データを読み出し、カーネル内でFP8へのリアルタイム逆量子化を完結させることで、余分なメモリラウンドトリップを回避する。
精度評価
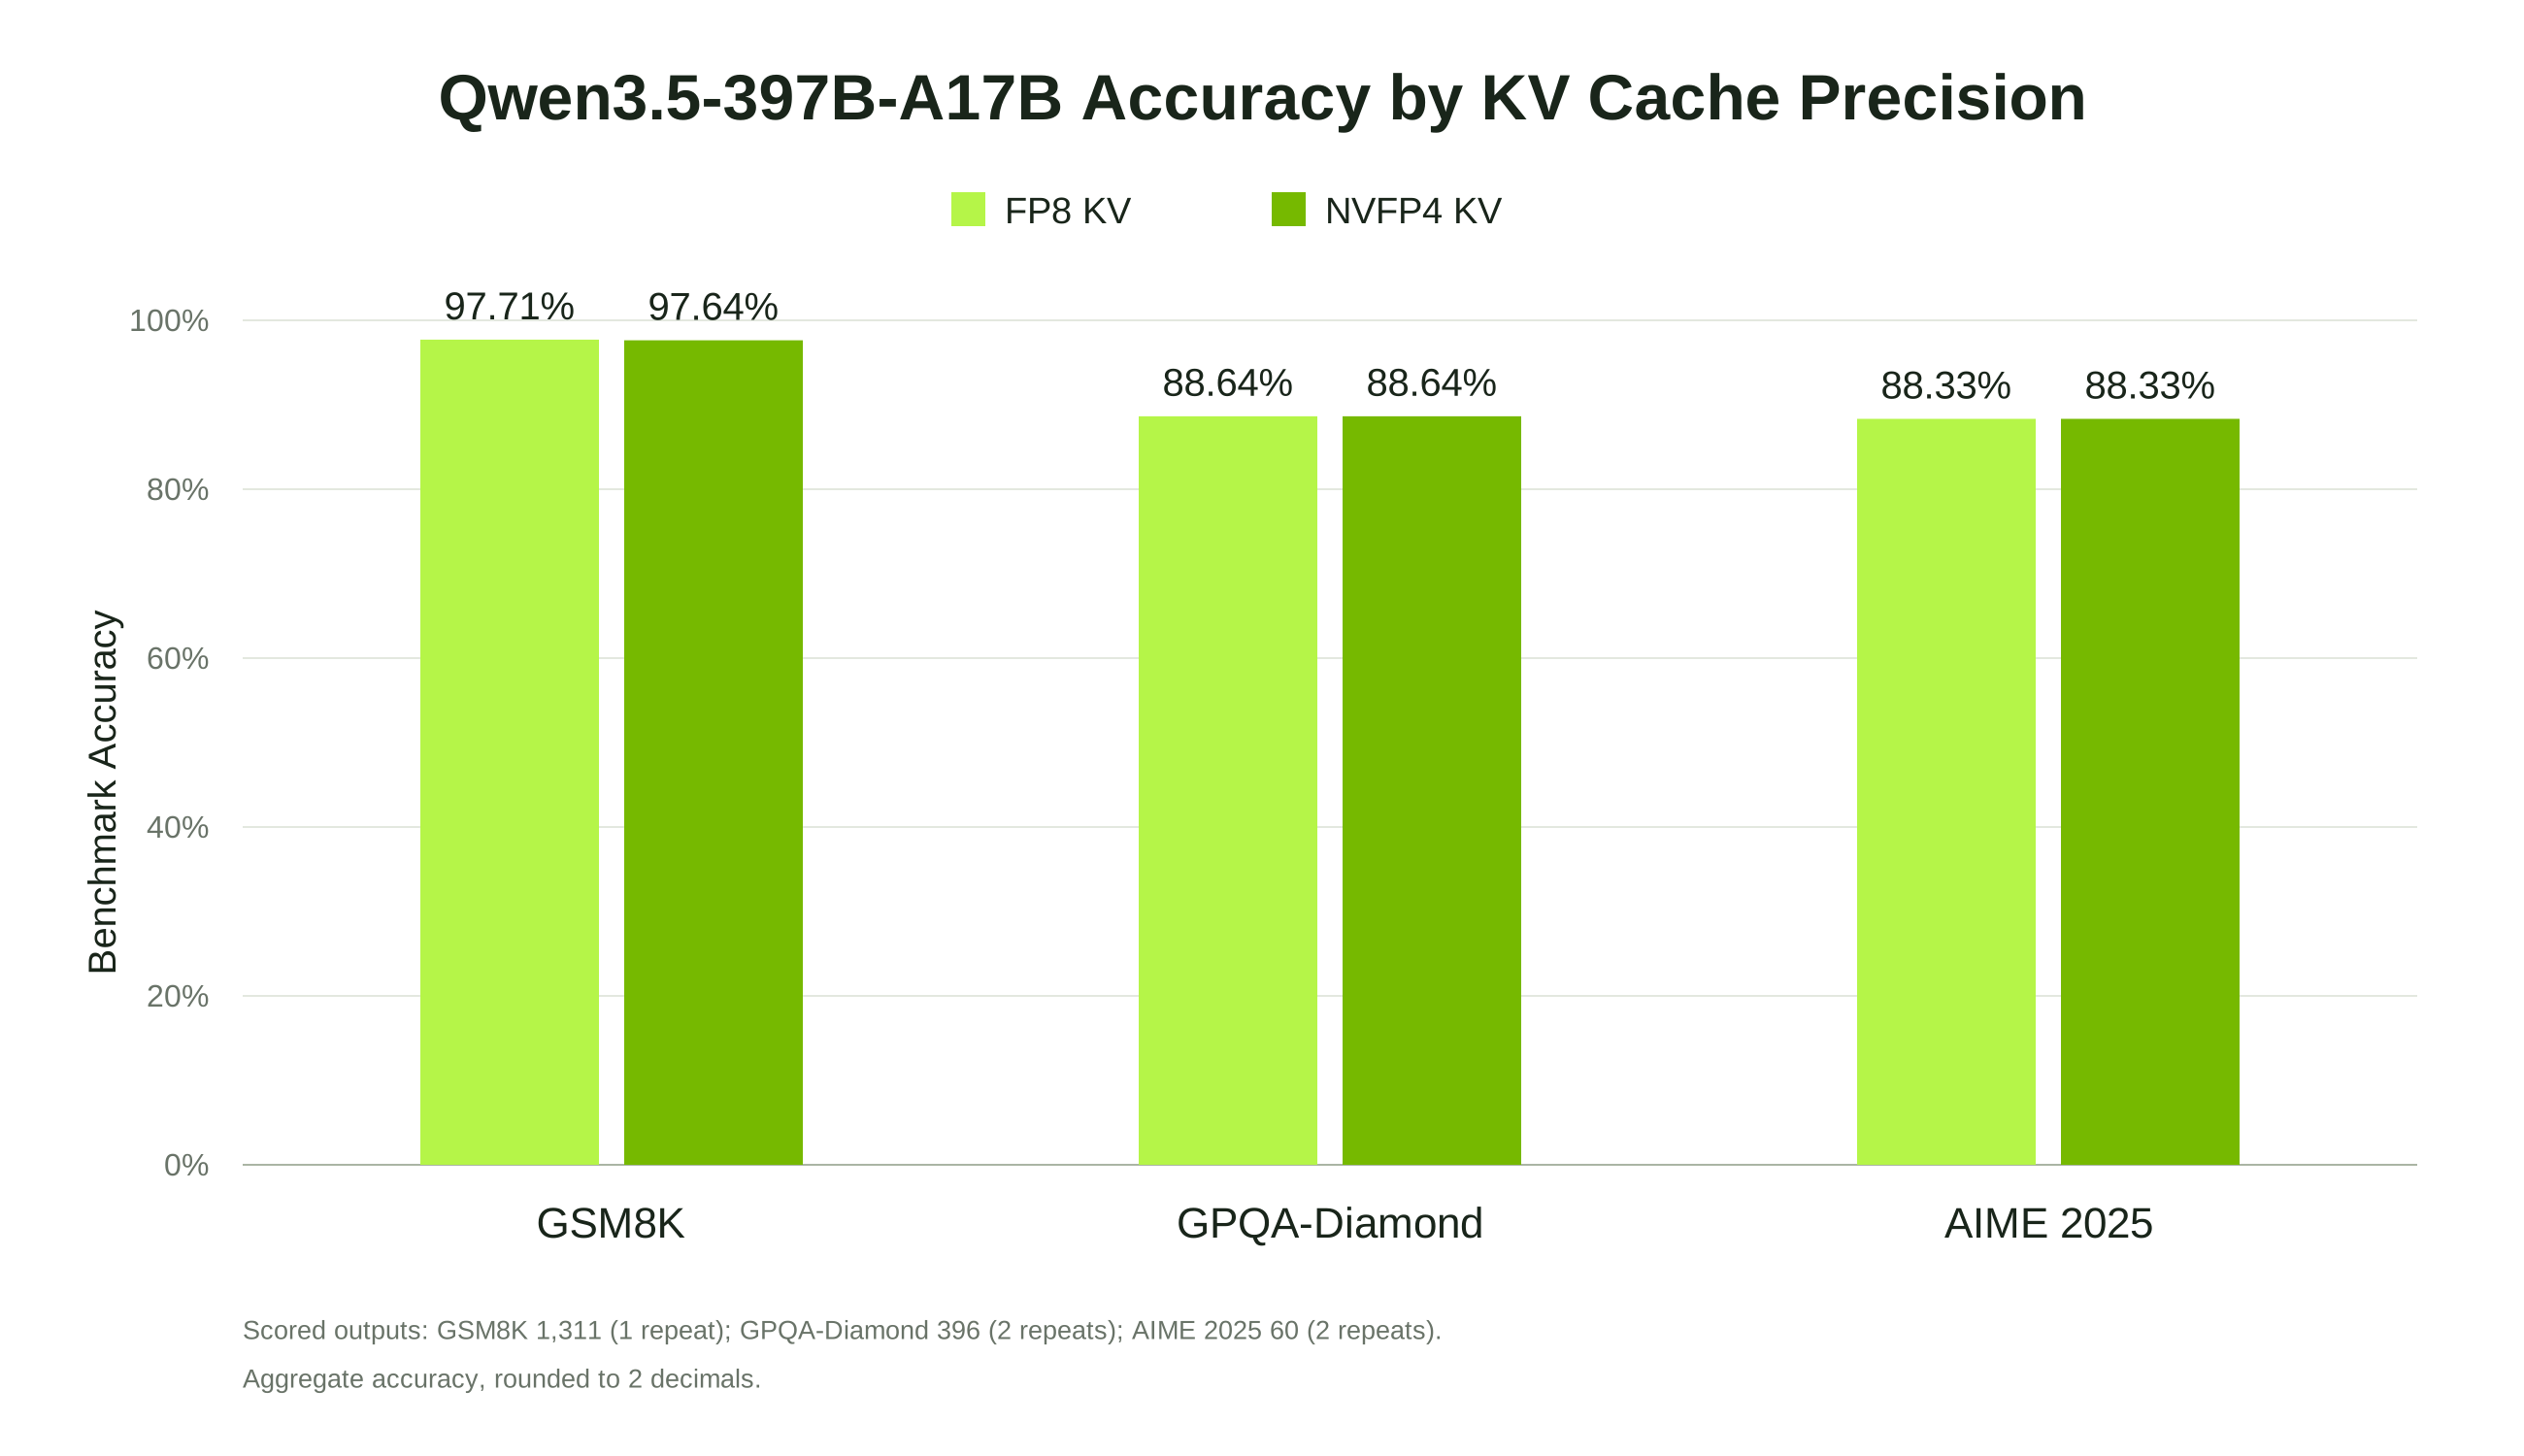
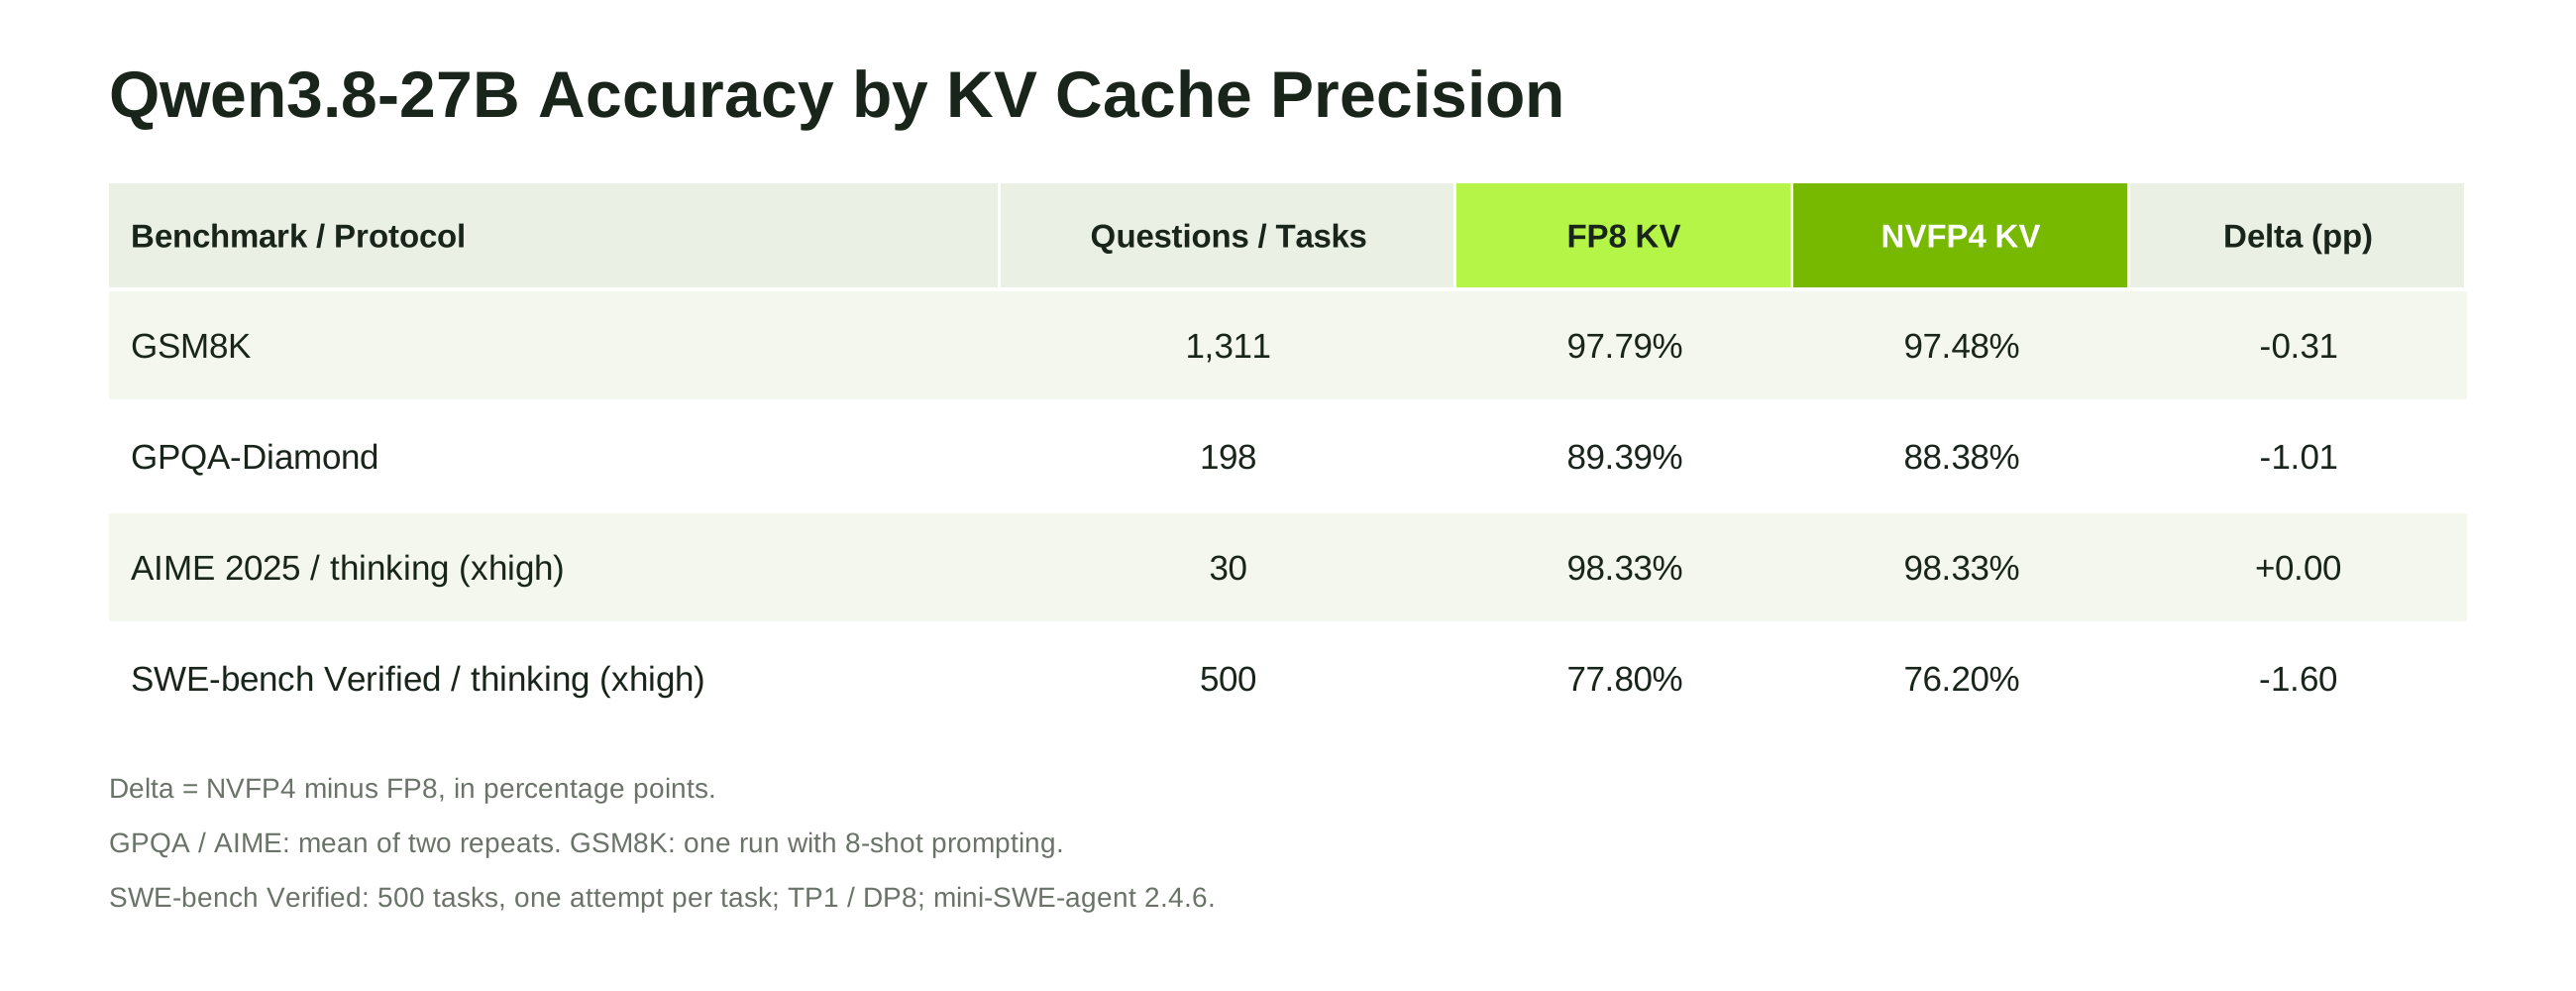
Qwen3.5-397B-A17Bにおいて、NVFP4とFP8の精度差は極めて小さく(0.1%未満)。Qwen3.8-27Bでは一部タスクで0.3〜1.6ポイントの精度低下が見られる。
パフォーマンス
単一のRTX PRO 6000 Blackwell GPUでのテストでは、NVFP4 KVによりデコードスループットが26〜30%向上し、より高い同時実行数をサポートすることが確認された。
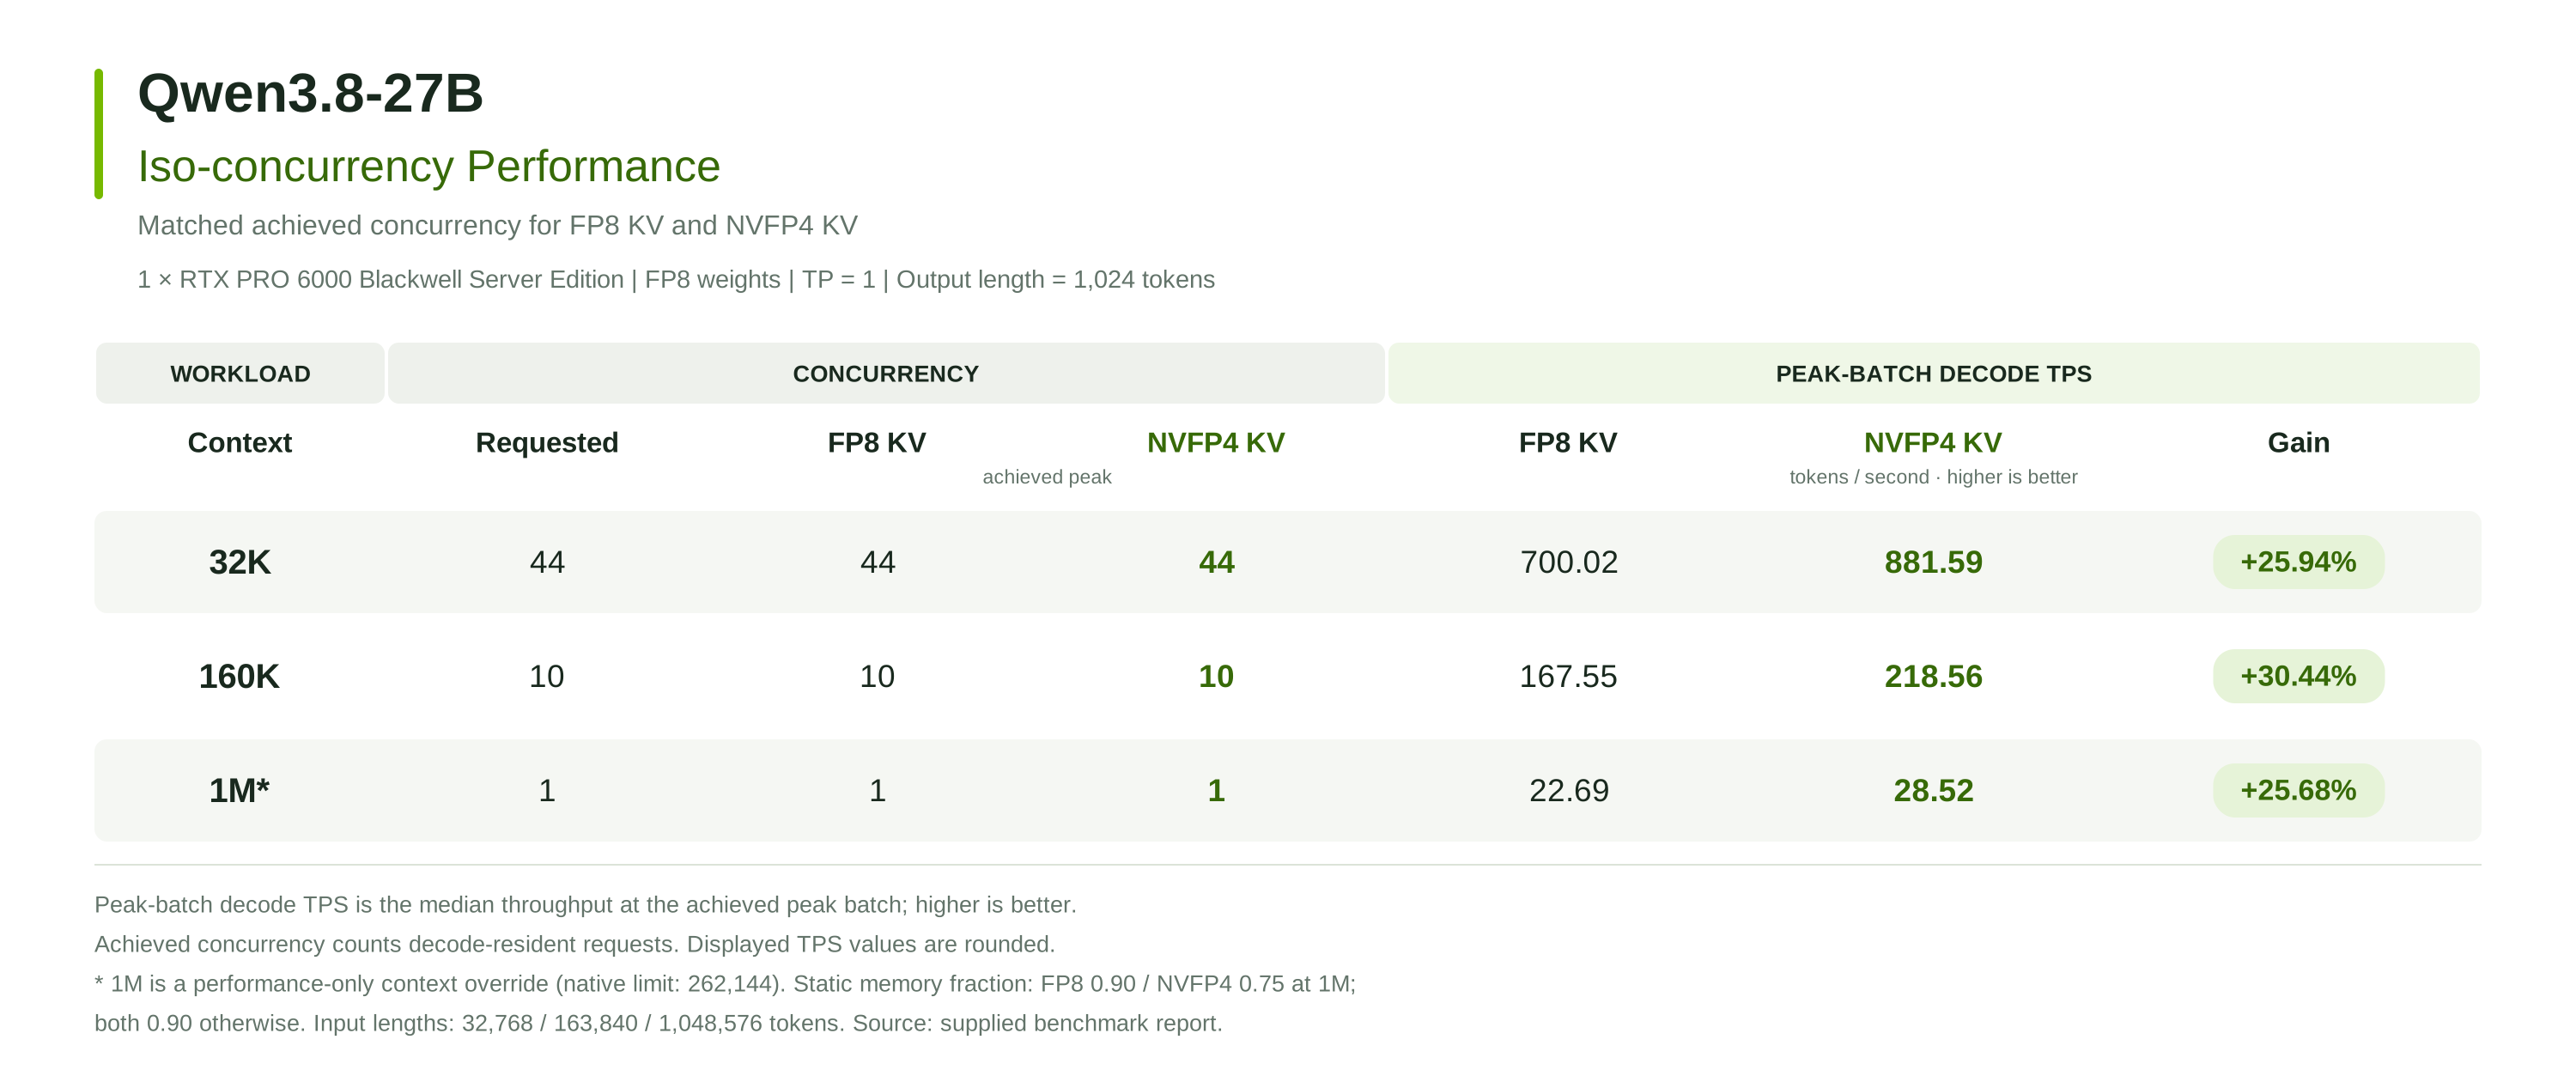
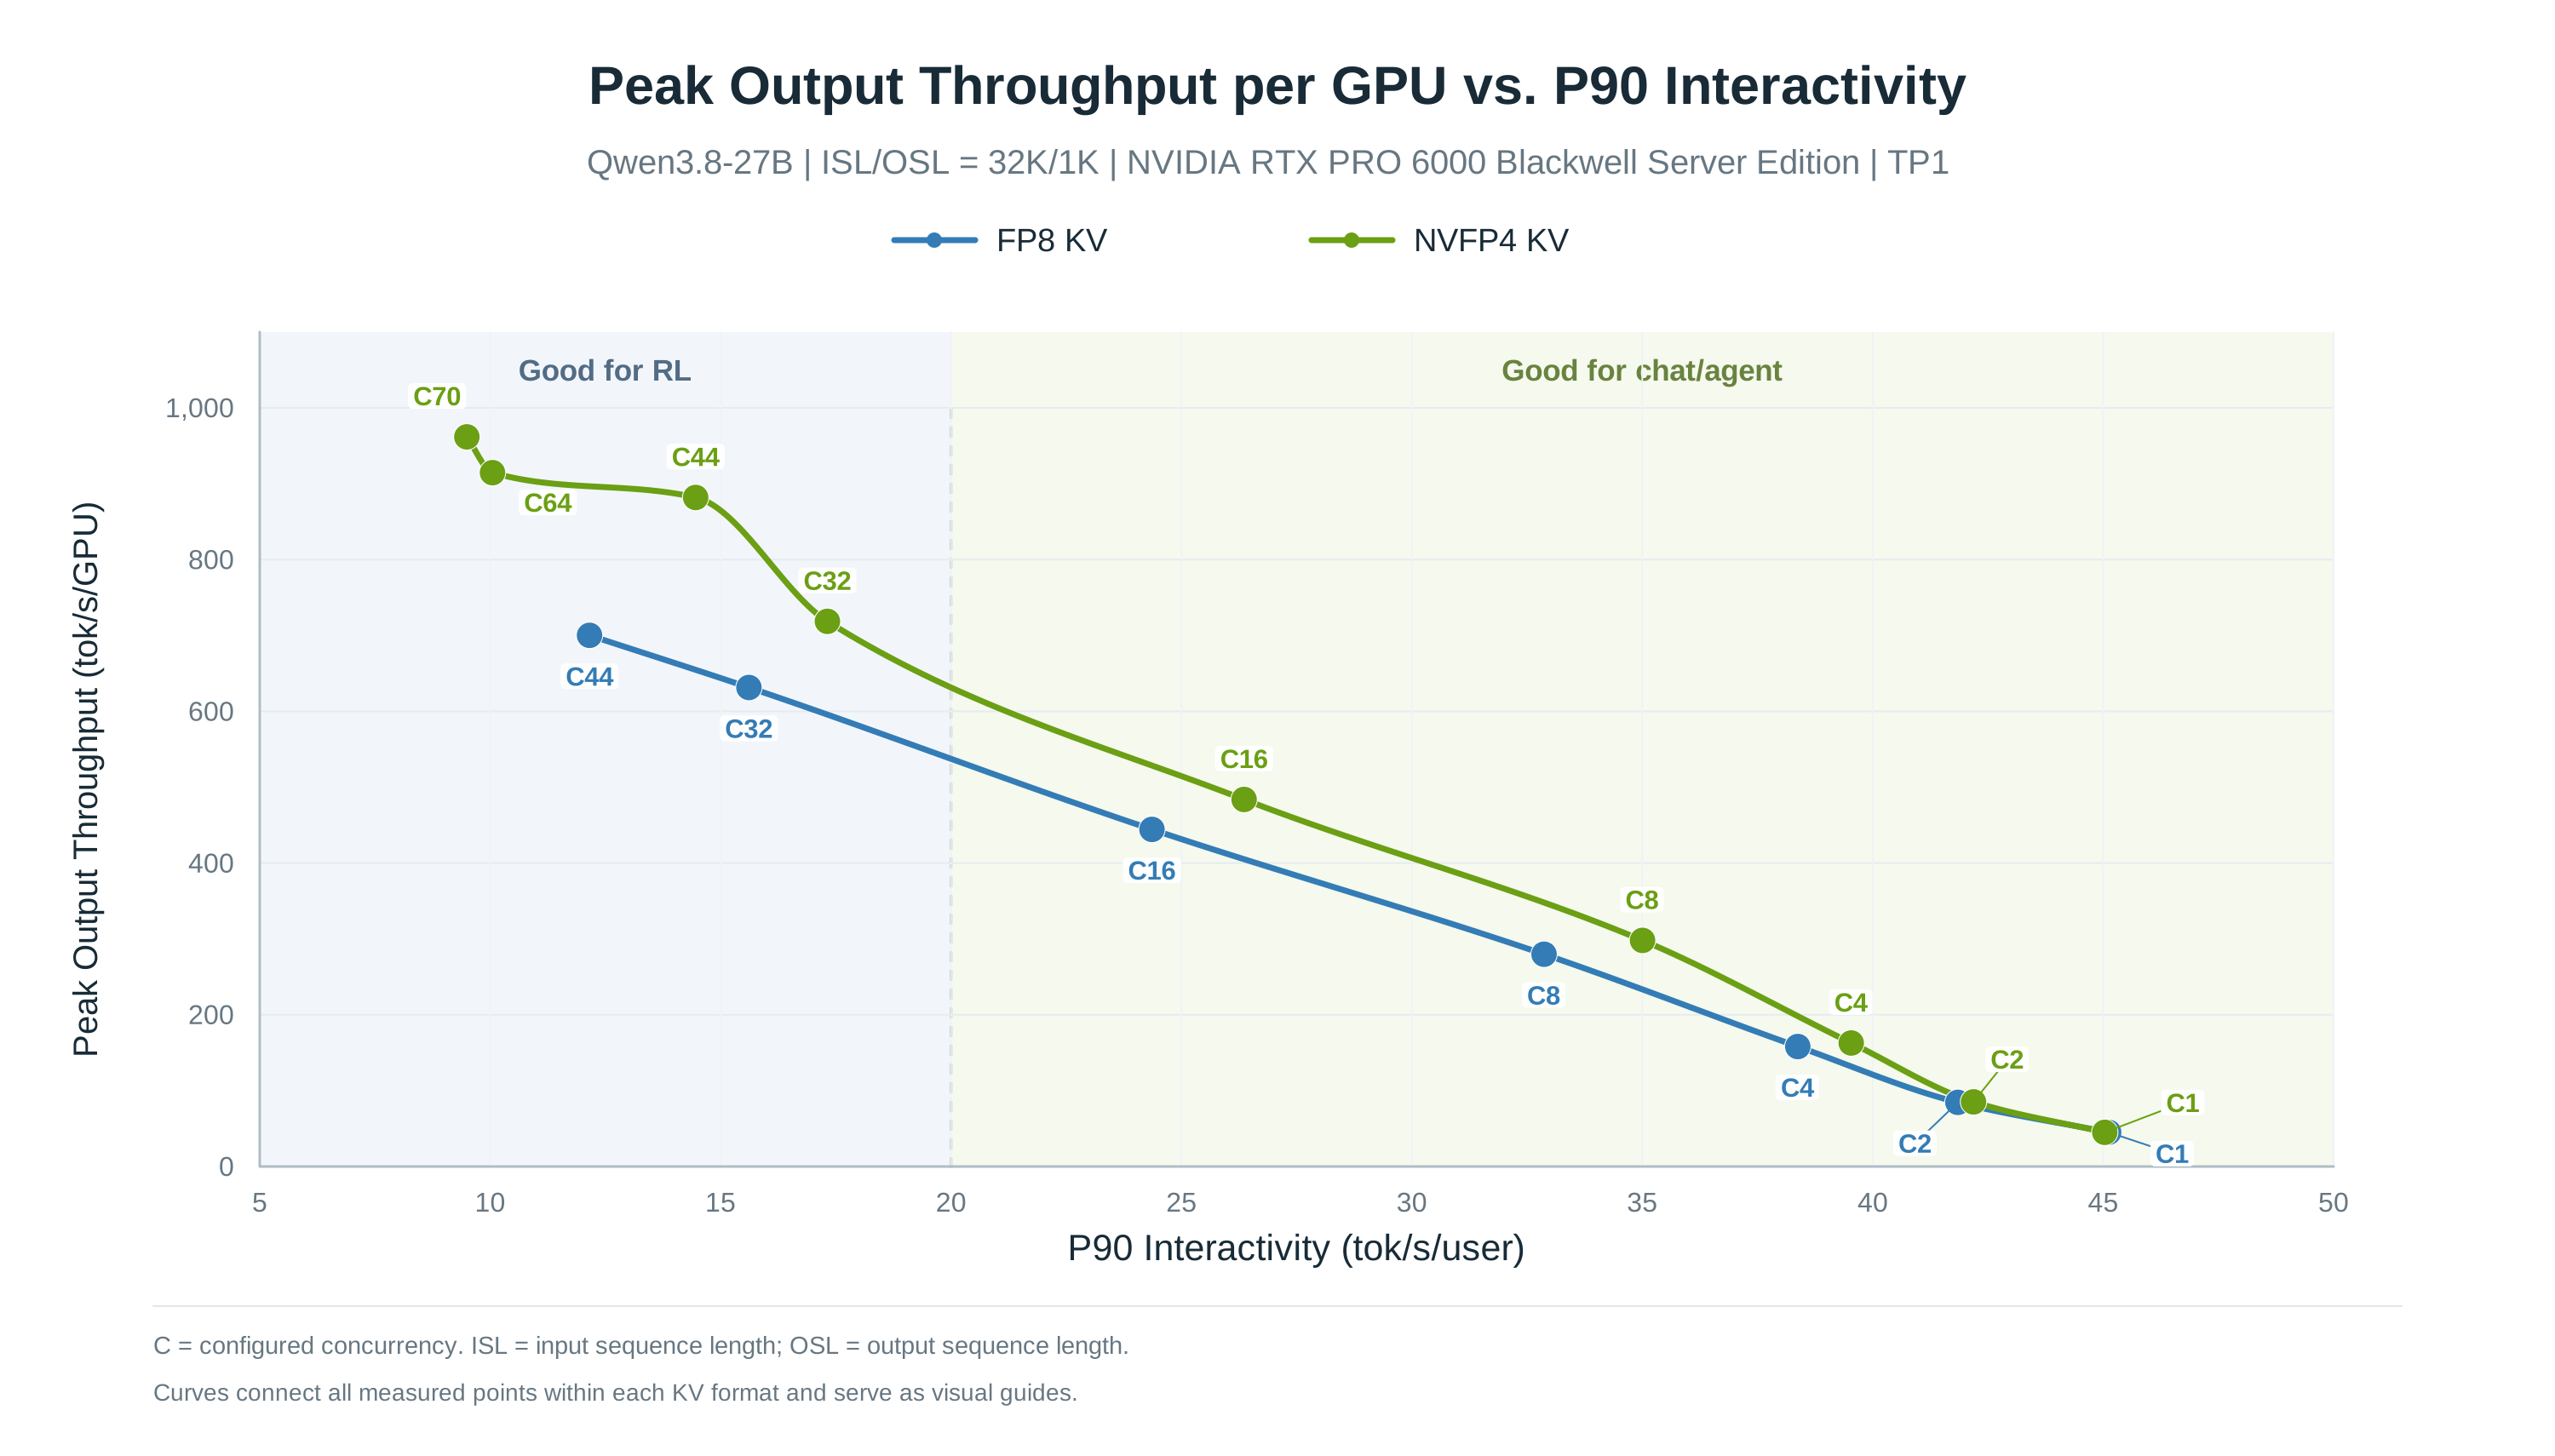
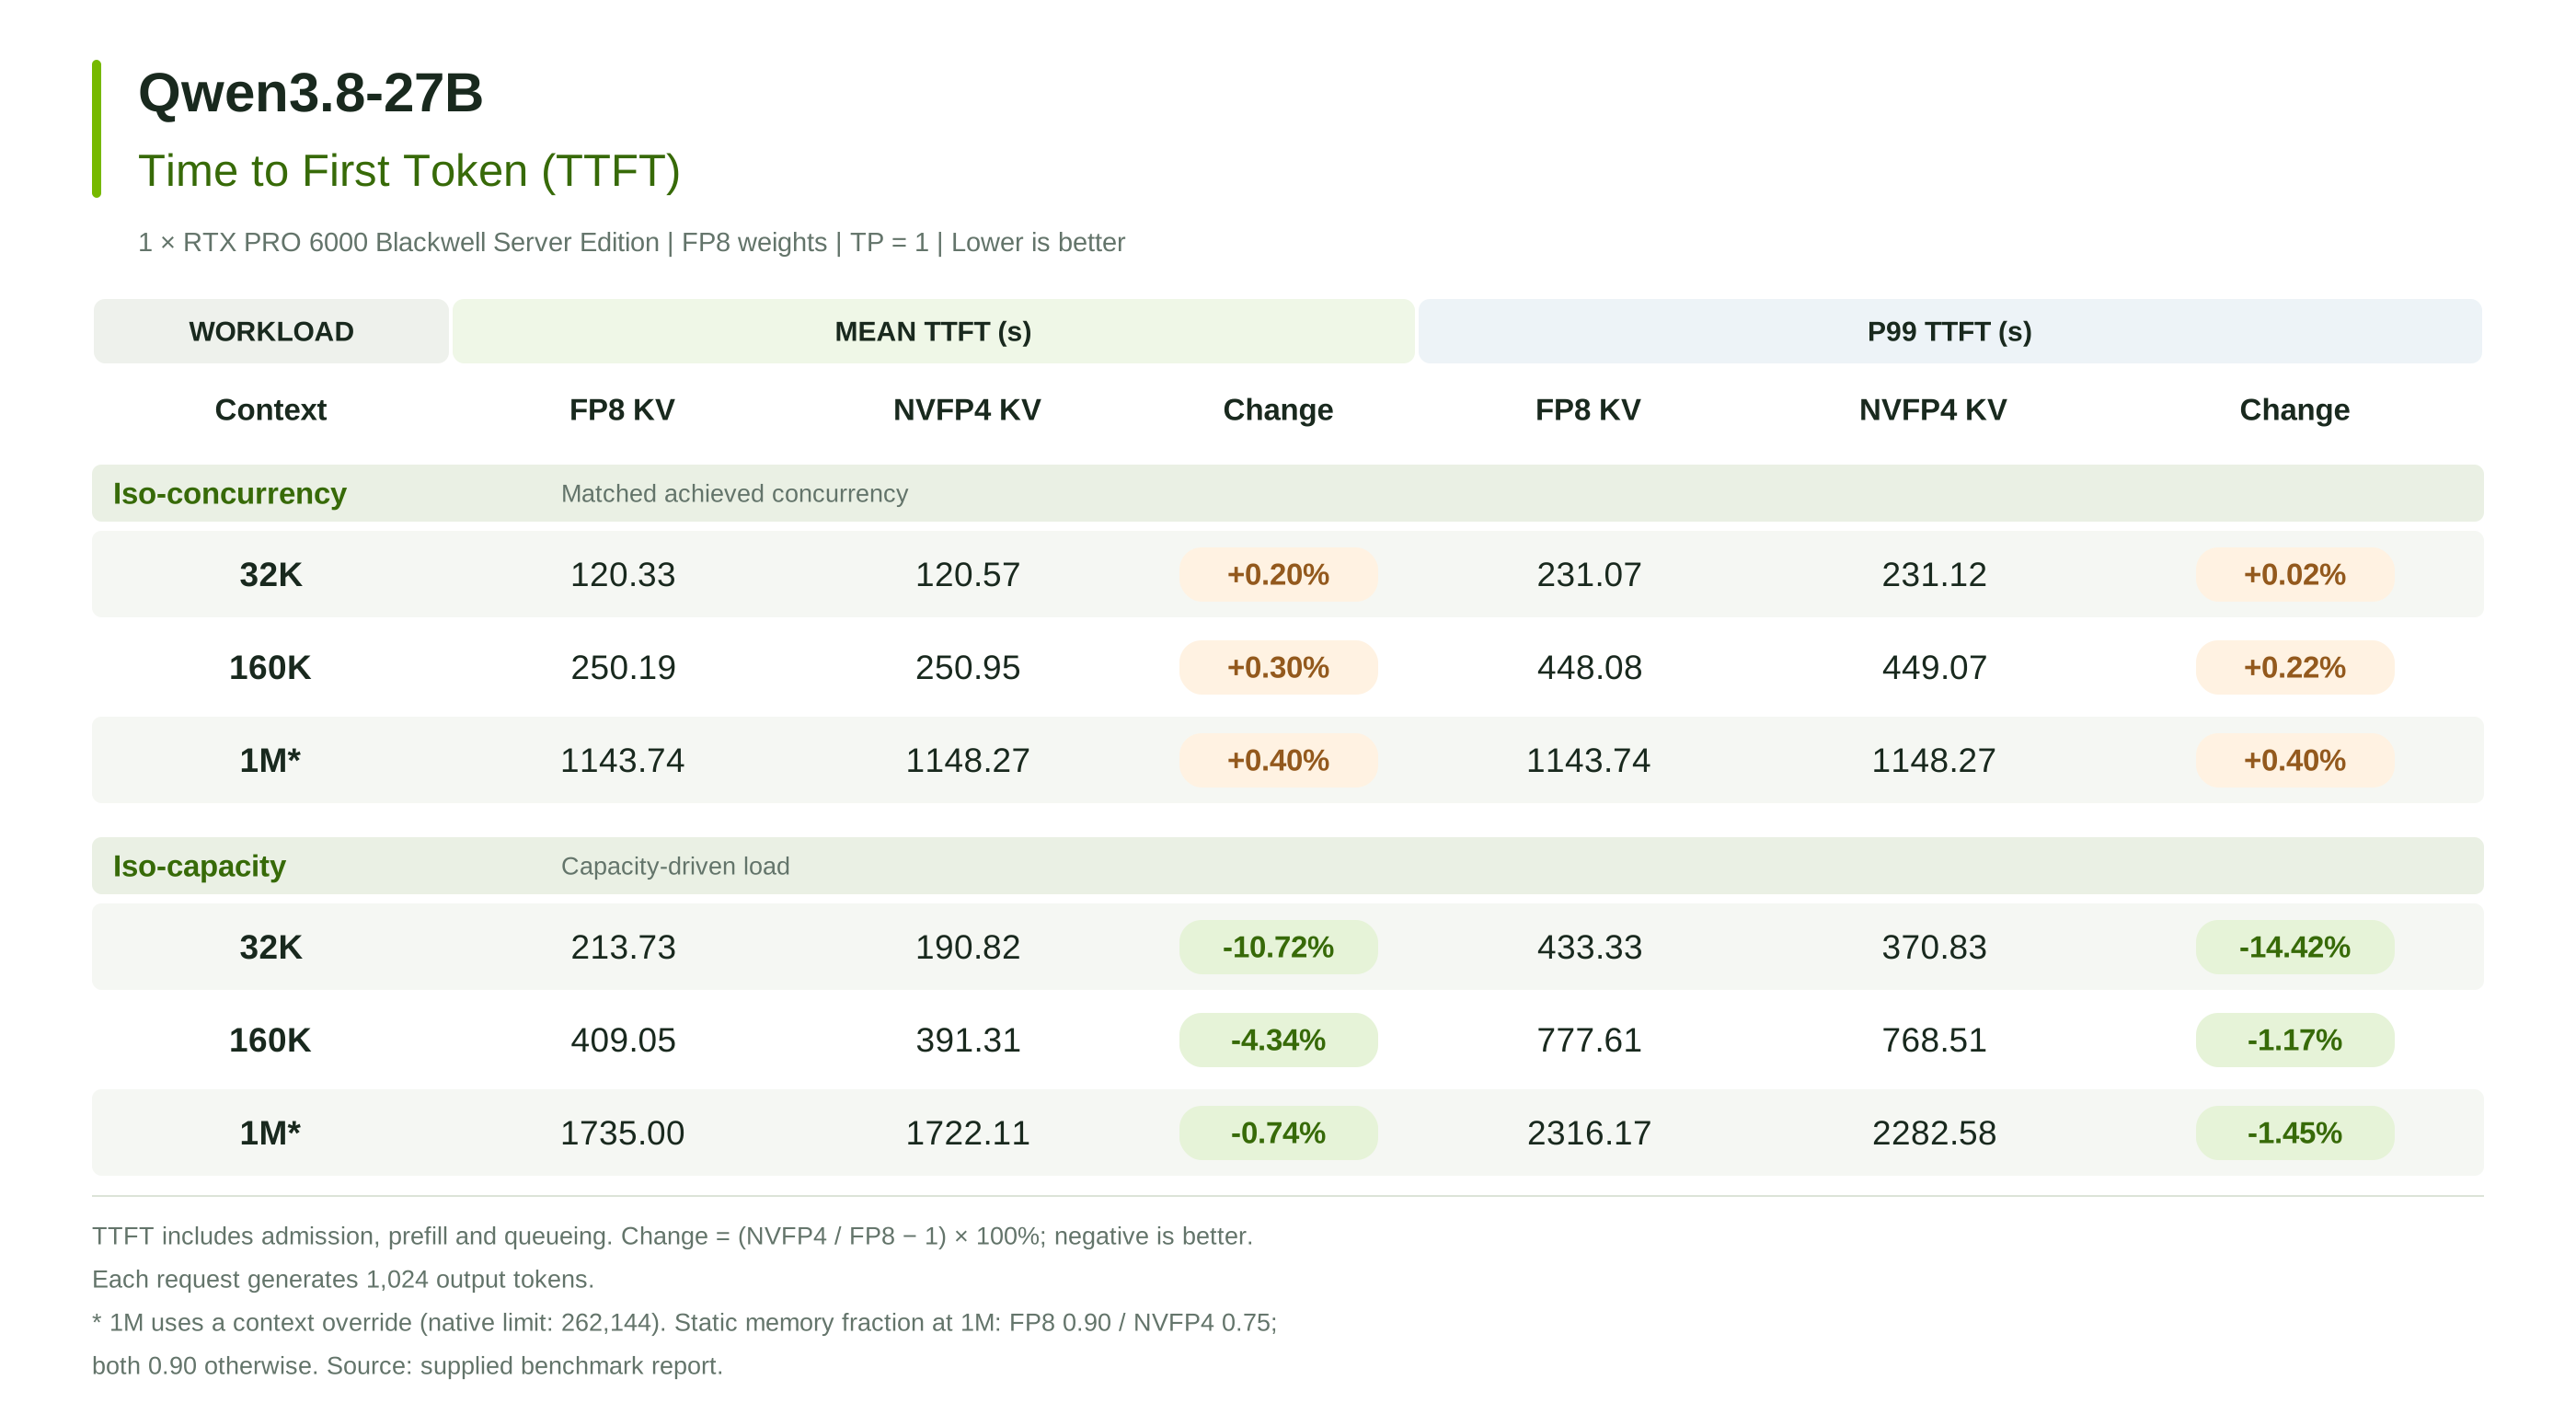
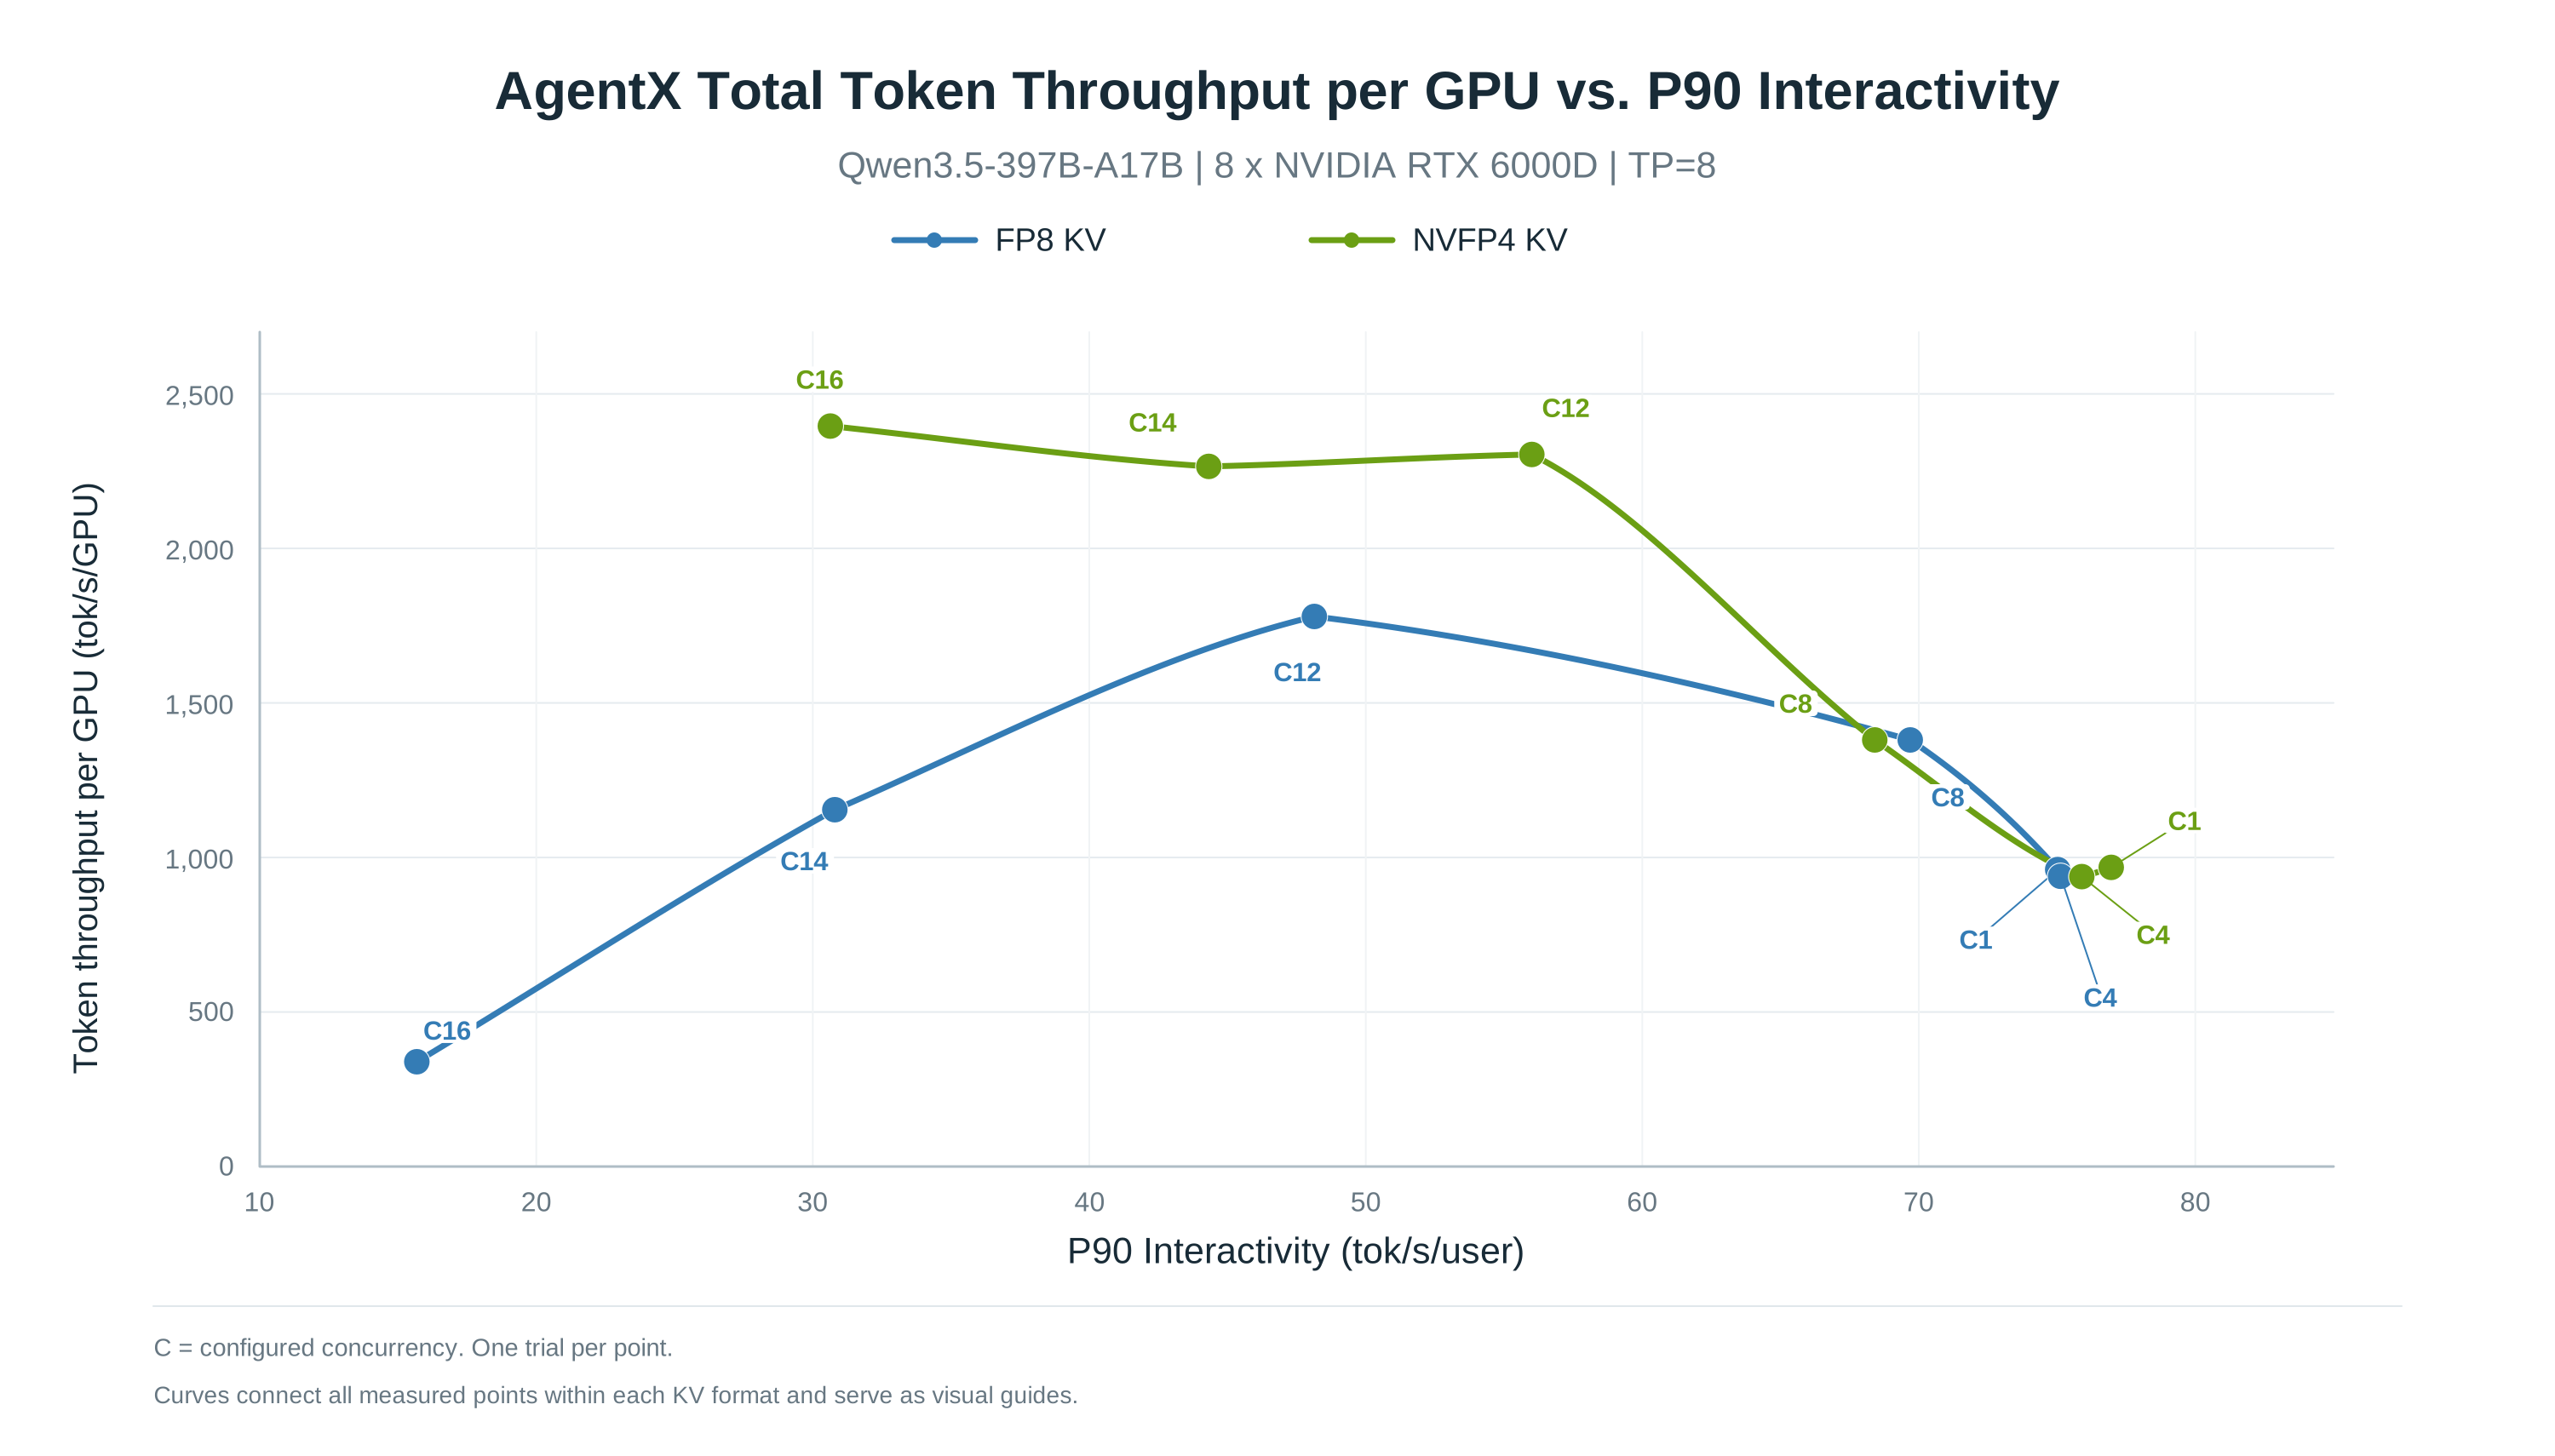
以上の結果は、NVFP4 KV Cacheが高い精度を維持しながら、長コンテキストおよびAgent推論の効率を大幅に向上させることを示している。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接