
MLPerf Trainingは2026年10月のv6.1提出ラウンドより、LLM後学習ベンチマークテストを新たに追加し、既存の事前学習ベンチマークスイートを補完する。事前学習は大量のデータによって基礎的な知能を構築するのに対し、後学習は精錬を通じてモデルの特定タスクにおける性能を向上させる。2025年下半期以降、LLM学習における主要な進歩の多くは後学習のスケール化から生まれており、例えば小型モデルが最先端性能に迫ったり、同一ベースモデル上で世代的な向上を実現したりといった事例が挙げられる。
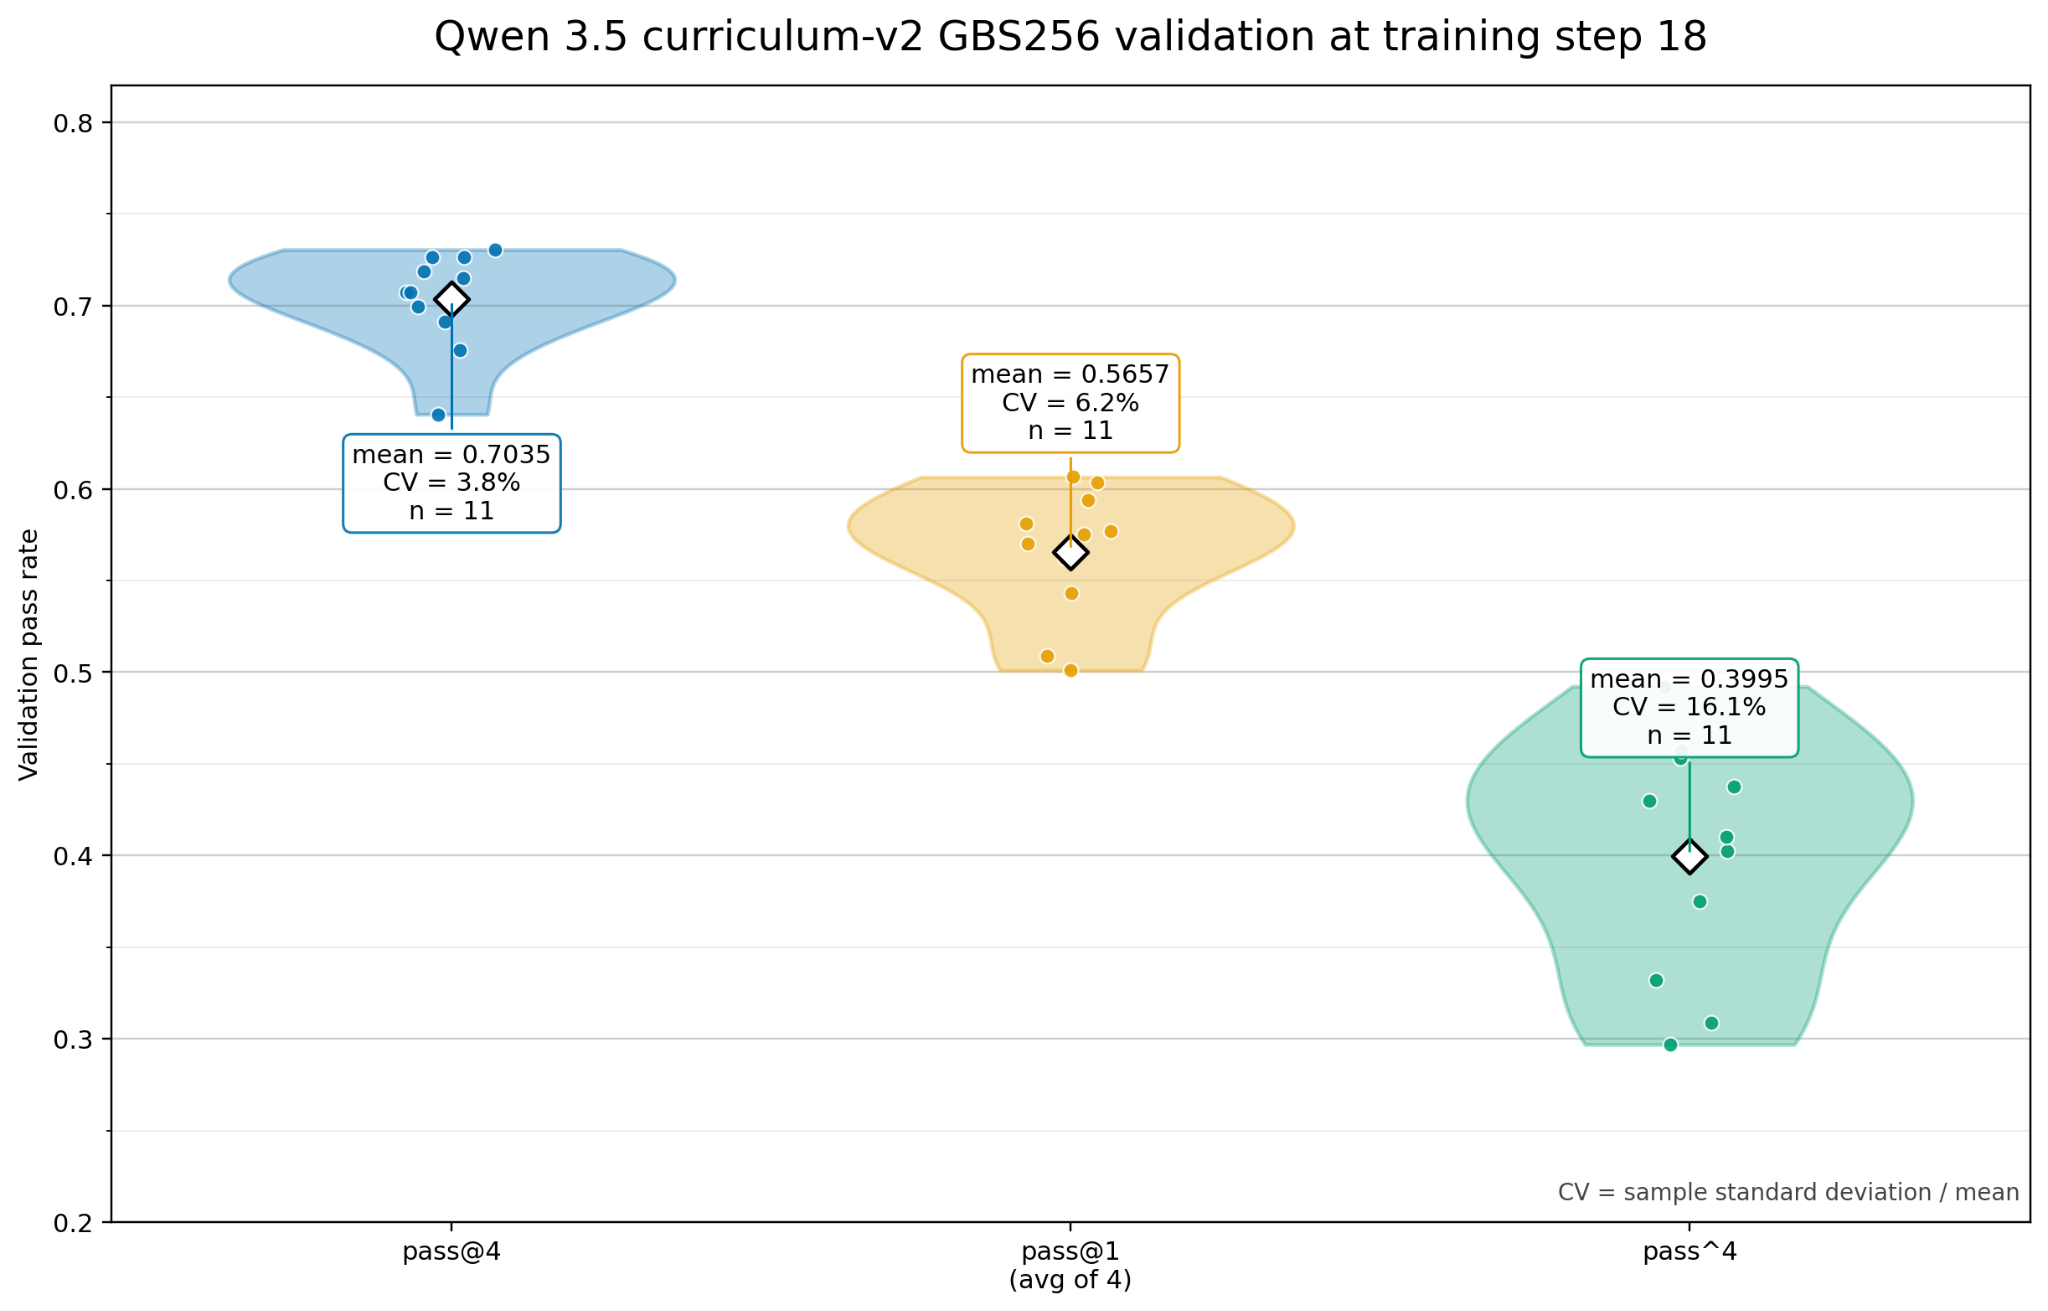
MLPerf Reasoning Task Forceは、1024台のGB300を用いて1時間以内に実際のLLM後学習ワークロードを完了できるベンチマークを設計した。実際の後学習は蒸留・強化学習・教師あり微調整を組み合わせており、数学・推論・エージェントタスクを網羅する。タスクグループは最終的に、強化学習と検証可能な報酬(RLVR:Reinforcement Learning with Verifiable Rewards)手法を選定し、ソフトウェアタスクのシナリオに適用した。LLM駆動のコーディングエージェントはサンドボックス環境内でエージェント型ソフトウェアエンジニアリング(SWE)タスクを解決し、各試行はロールアウト(rollout)と呼ばれる。システムは各問題に対して複数のロールアウトをサンプリングし、二値的な合格/不合格の報酬を与えた上で、グループ相対方策最適化(GRPO:Group Relative Policy Optimization)を用いてモデルを更新する。
モデルの選定
本ベンチマークには2026年2月にリリースされたQwen 3.5 397Bモデルを採用した。これはQwen 3.5シリーズ最大のオープンウェイトモデルであり、Apache 2.0ライセンスのもとで公開されている。同モデルはMixture of Experts(MoE)アーキテクチャを採用し、総パラメータ数3970億、1トークンあたりの活性化パラメータは170億である。Gated DeltaNet(GDN)とスパースMoEのハイブリッドアーキテクチャを初めて製品化した点が特徴で、各MoEレイヤーでは1つの共有エキスパートと512のルーティングエキスパートのうち10個(2%)が活性化される。GDNは線形増加するKVキャッシュを固定サイズの圧縮状態に置き換えるものであり、長コンテキストのシナリオに特に適している。
データセットの選定
ベンチマークにはApache 2.0ライセンスのR2E-Gym SWE問題データセットを使用した。このデータセットには複数のPythonプロジェクトのGitHubコミットから生成された700件の学習問題と251件の検証問題が含まれる。エージェントは依存関係があらかじめインストールされたLinuxコンテナ内で問題の説明を受け取り、修正パッチを生成する必要がある。タスクグループはデータセットの難易度によるフィルタリングを行い、クロスアーキテクチャの互換性問題も修正した。
環境と実装
ベンチマークでは最大コンテキスト長65536、最大エージェントターン数30回、プロンプトあたりの生成数16回に制限している。参照実装はNVIDIA NeMo-RLをベースとし、Rayを用いてポリシー学習とロールアウト生成を調整しており、それぞれMegatron Core、vLLM、OpenHands harnessによって支えられている。報酬ハッキングを防ぐため、評価時にはエージェントから不可視のテストファイルを使用する。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接