
はじめに:VRAMの問題をストレージの問題に変換する
DeepSeek-V4-FlashとKimi-K3の総パラメータ数は、コンシューマー向けGPU1枚のVRAM容量を大幅に超えている。従来の展開には複数のGPUや数百GBのホストメモリが必要であり、参入障壁は非常に高かった。SGLangのSSD Expert Packは、未選択のエキスパートの重みをNVMe SSD上に保持し、ルーティングで選ばれたエキスパートのみをSSDからGPUキャッシュにロードするアプローチを採用している。
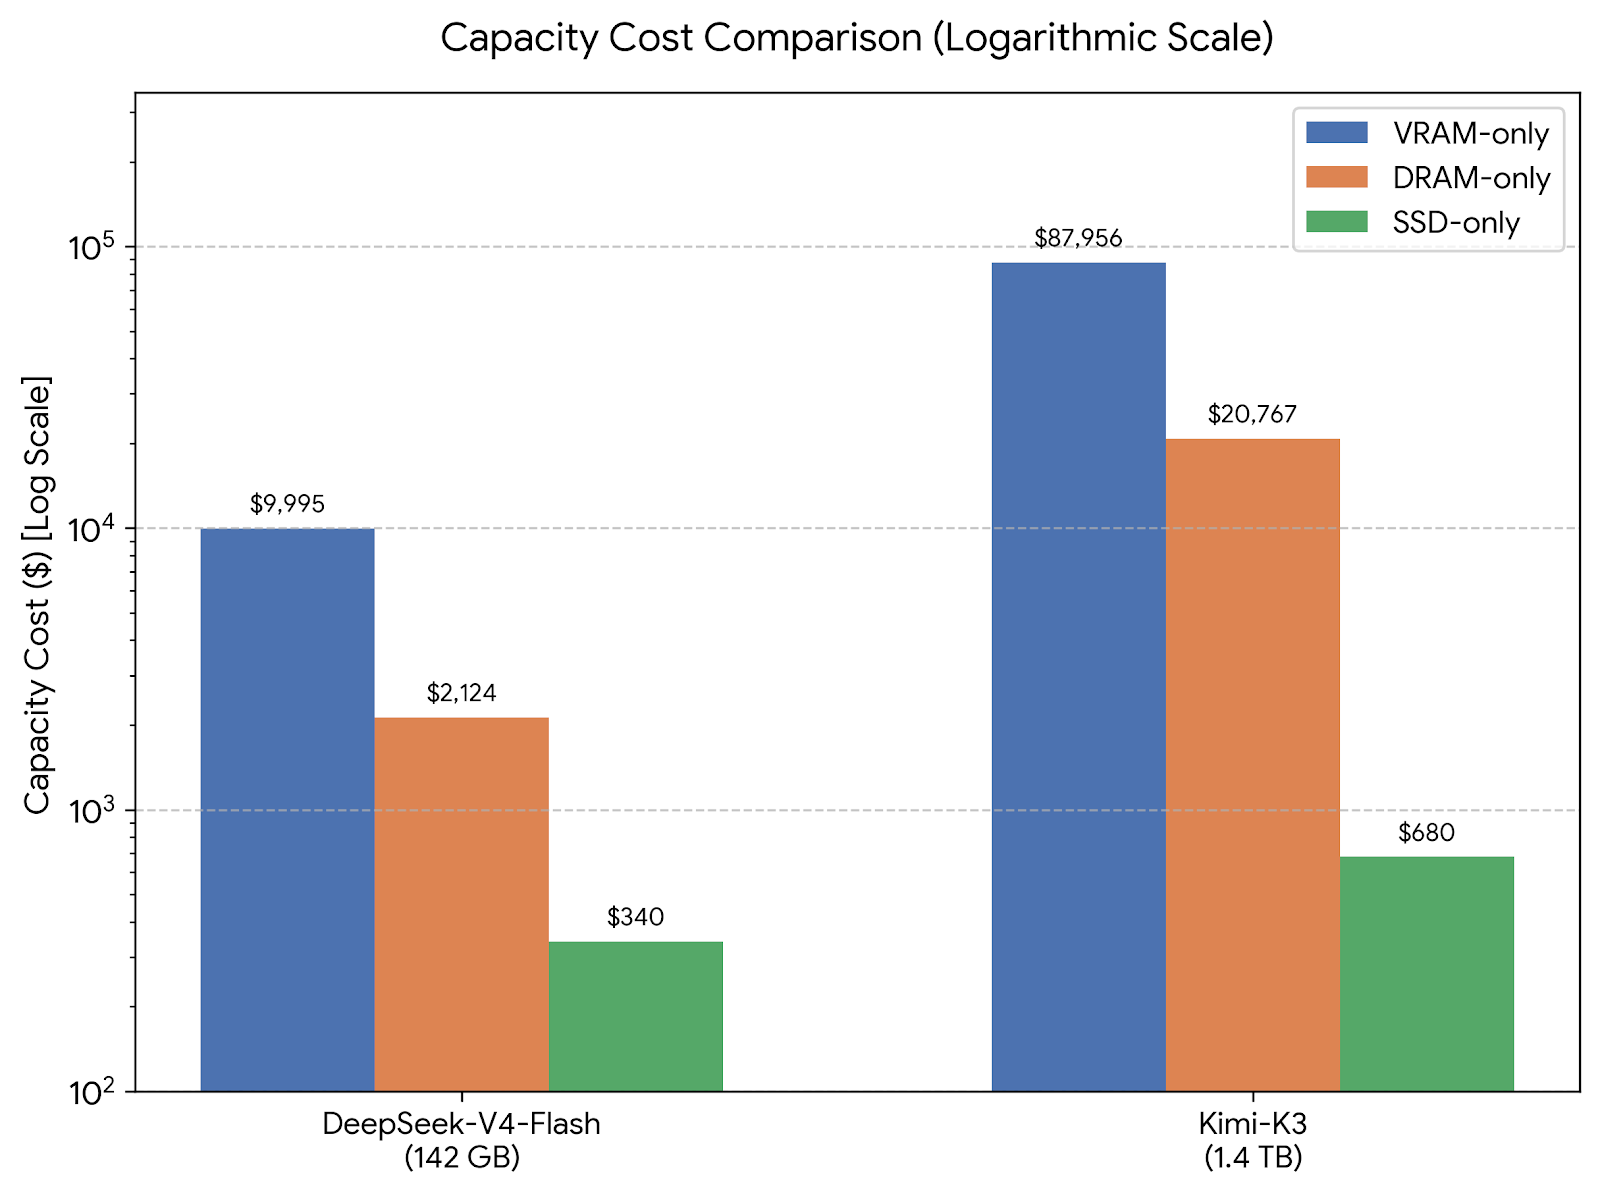
容量コストの比較
下図は対数スケールにより、VRAM・DRAM・SSDの容量コスト差を示している。SSDをバックアップ層として活用することで、ハードウェアの参入障壁を大幅に引き下げられることが明確に示されている。
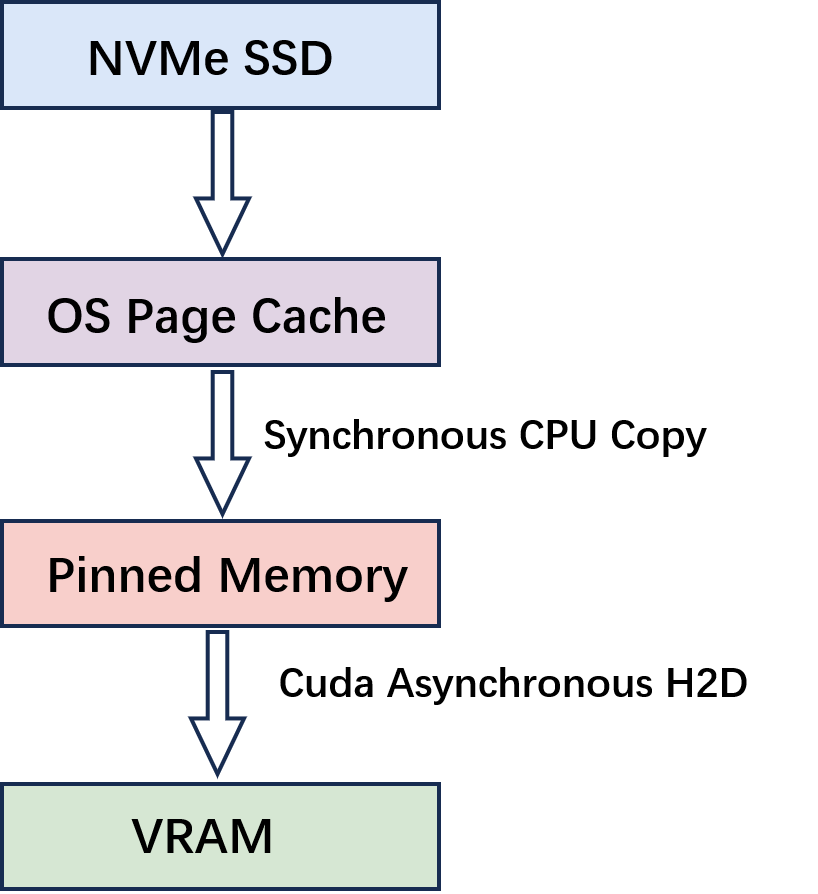
従来のファイル読み込みパスの限界
従来のGGUFロードでは、ページキャッシュからピン留めメモリへの同期コピーを経た後、非同期のH2D転送が行われる。
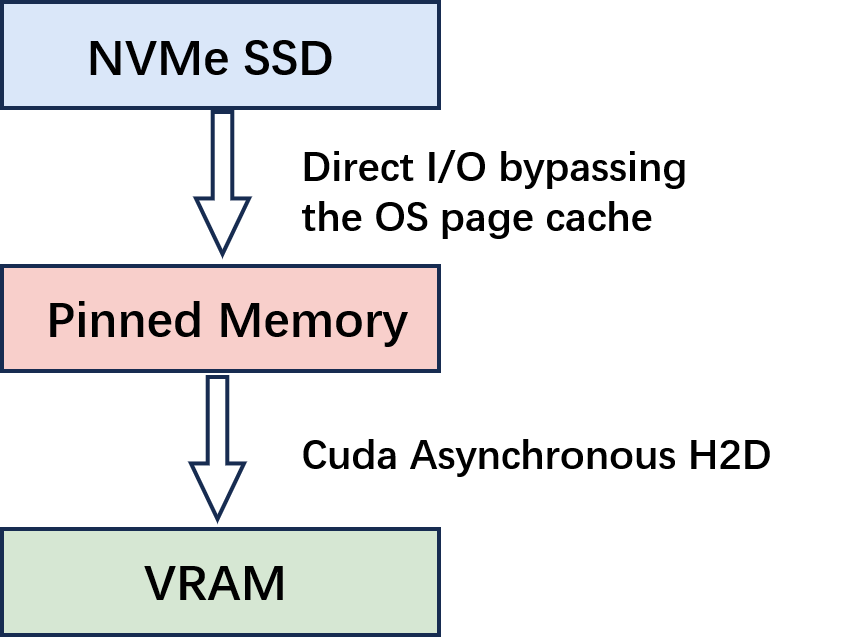
Expert Packによるダイレクトi/O最適化パス
Expert Packはアラインされたピン留めホストバッファを使用し、余分なコピーを排除してGPUエキスパートキャッシュへ直接データを供給する。
性能比較結果
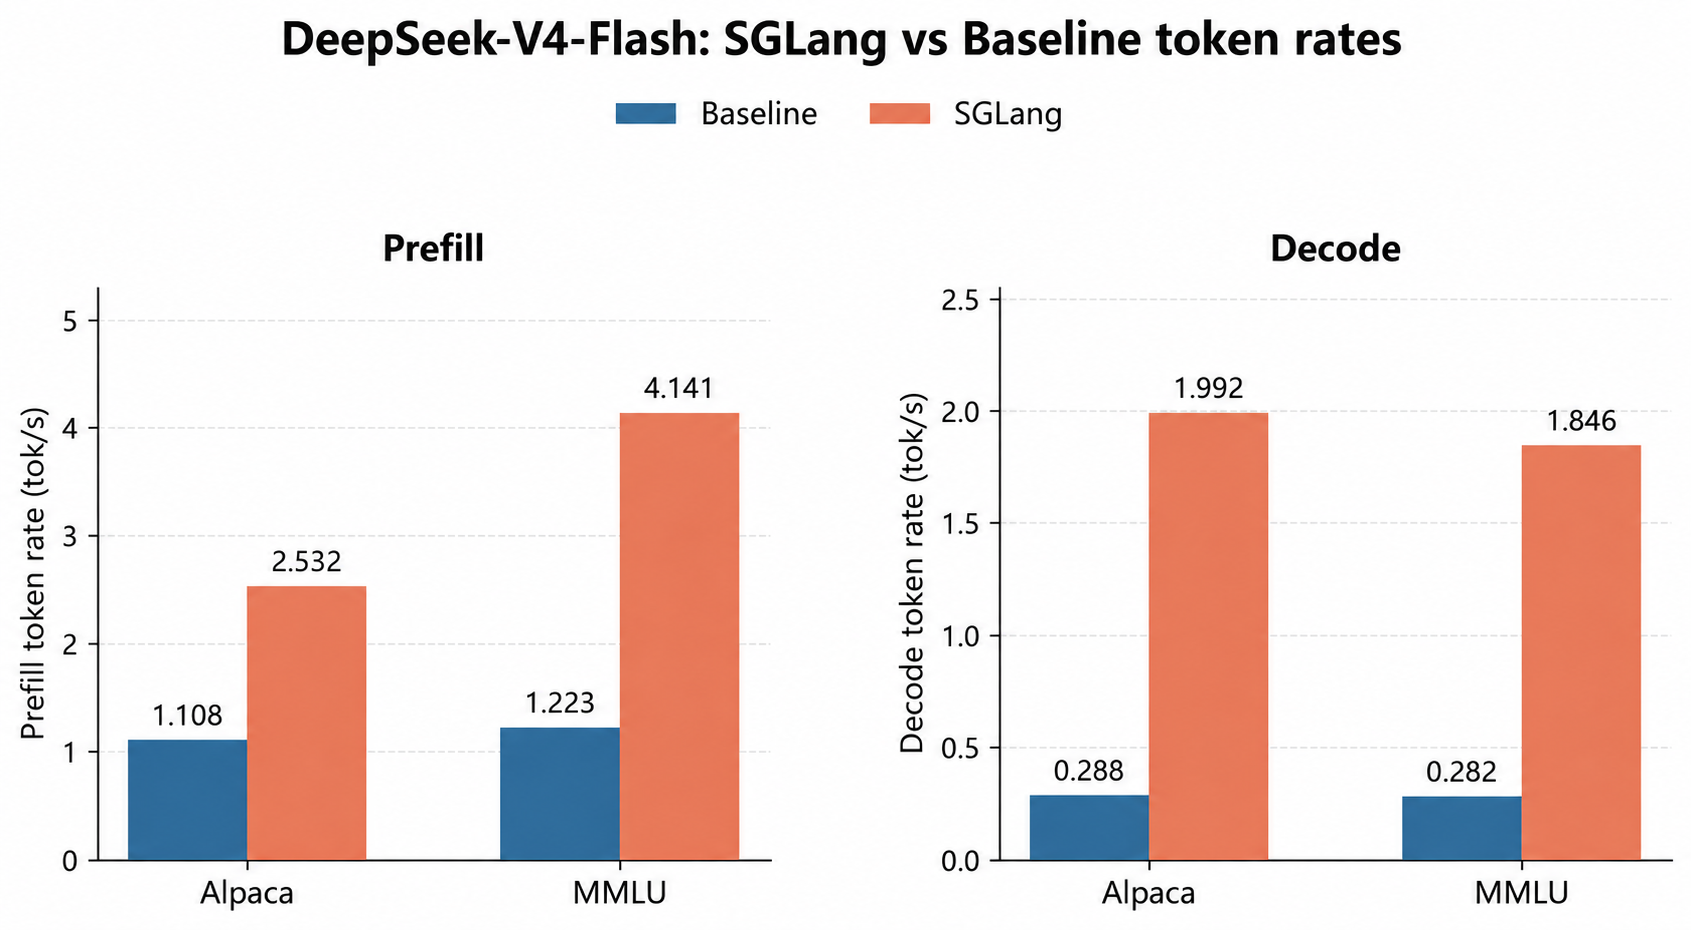
DeepSeek-V4-FlashをAlpacaおよびMMLUで評価したプリフィルおよびデコード速度の比較では、SGLangのアプローチがベースラインを大きく上回る結果が示されている。
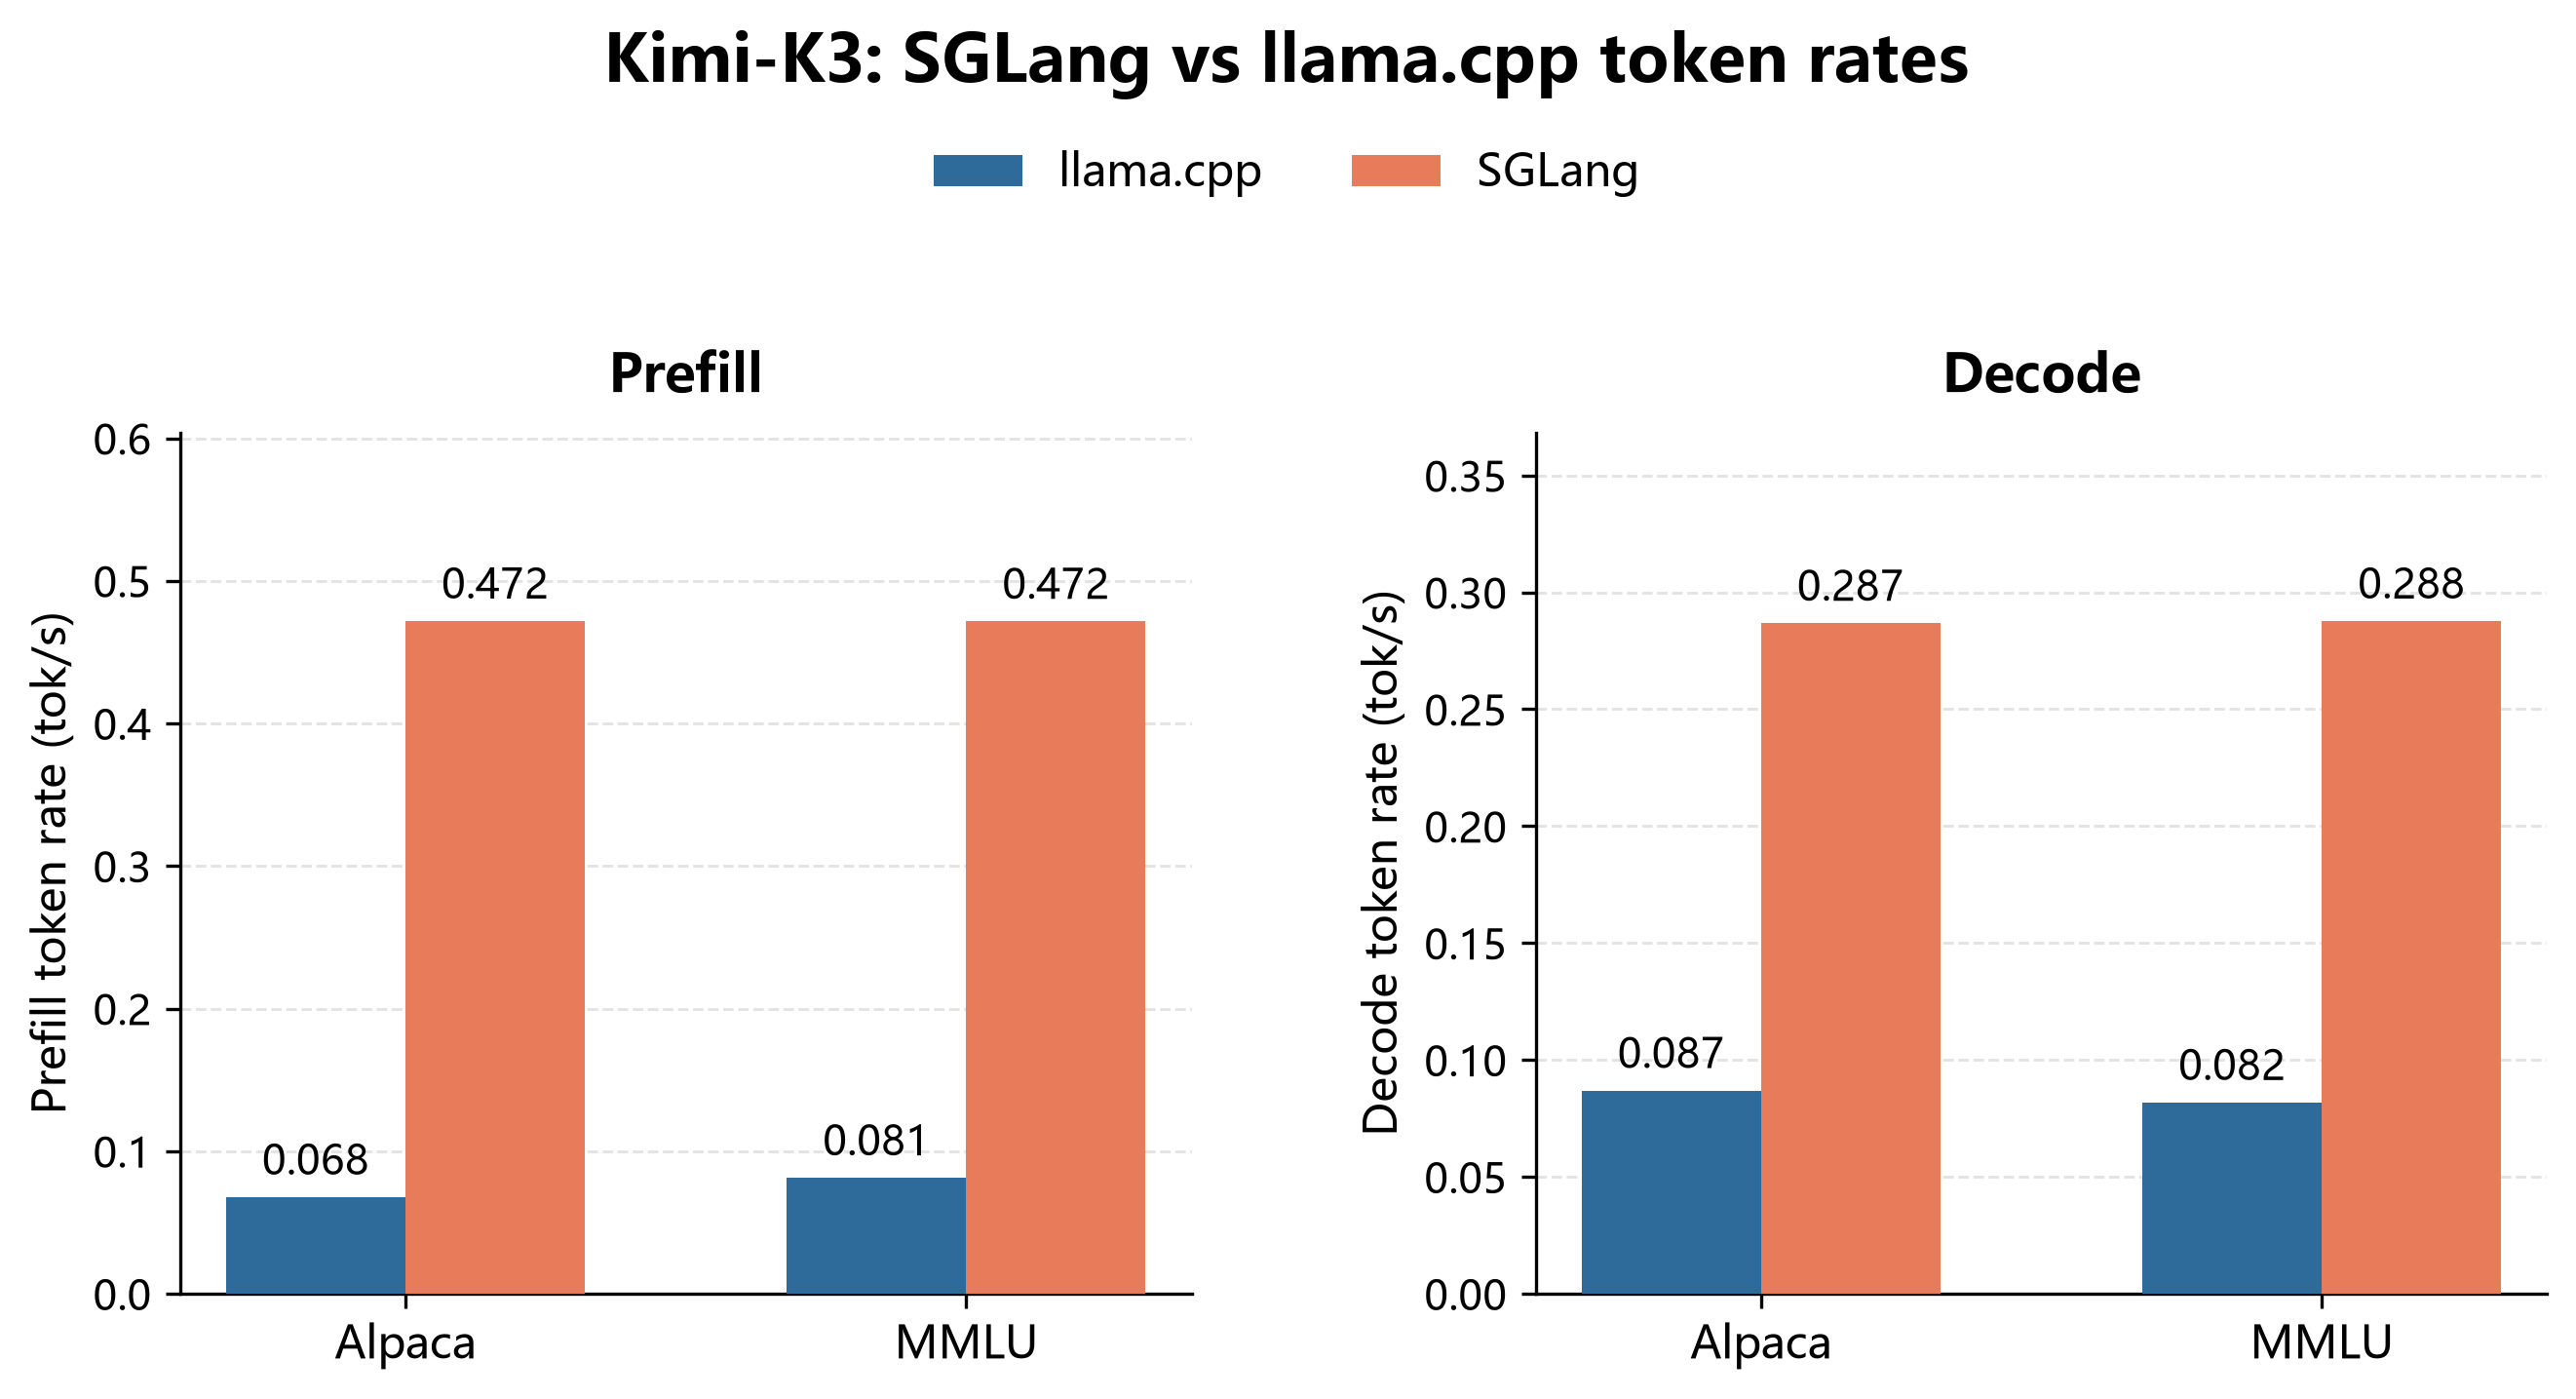
Kimi-K3においても、SGLangはllama.cppに対して明確な優位性を示している。
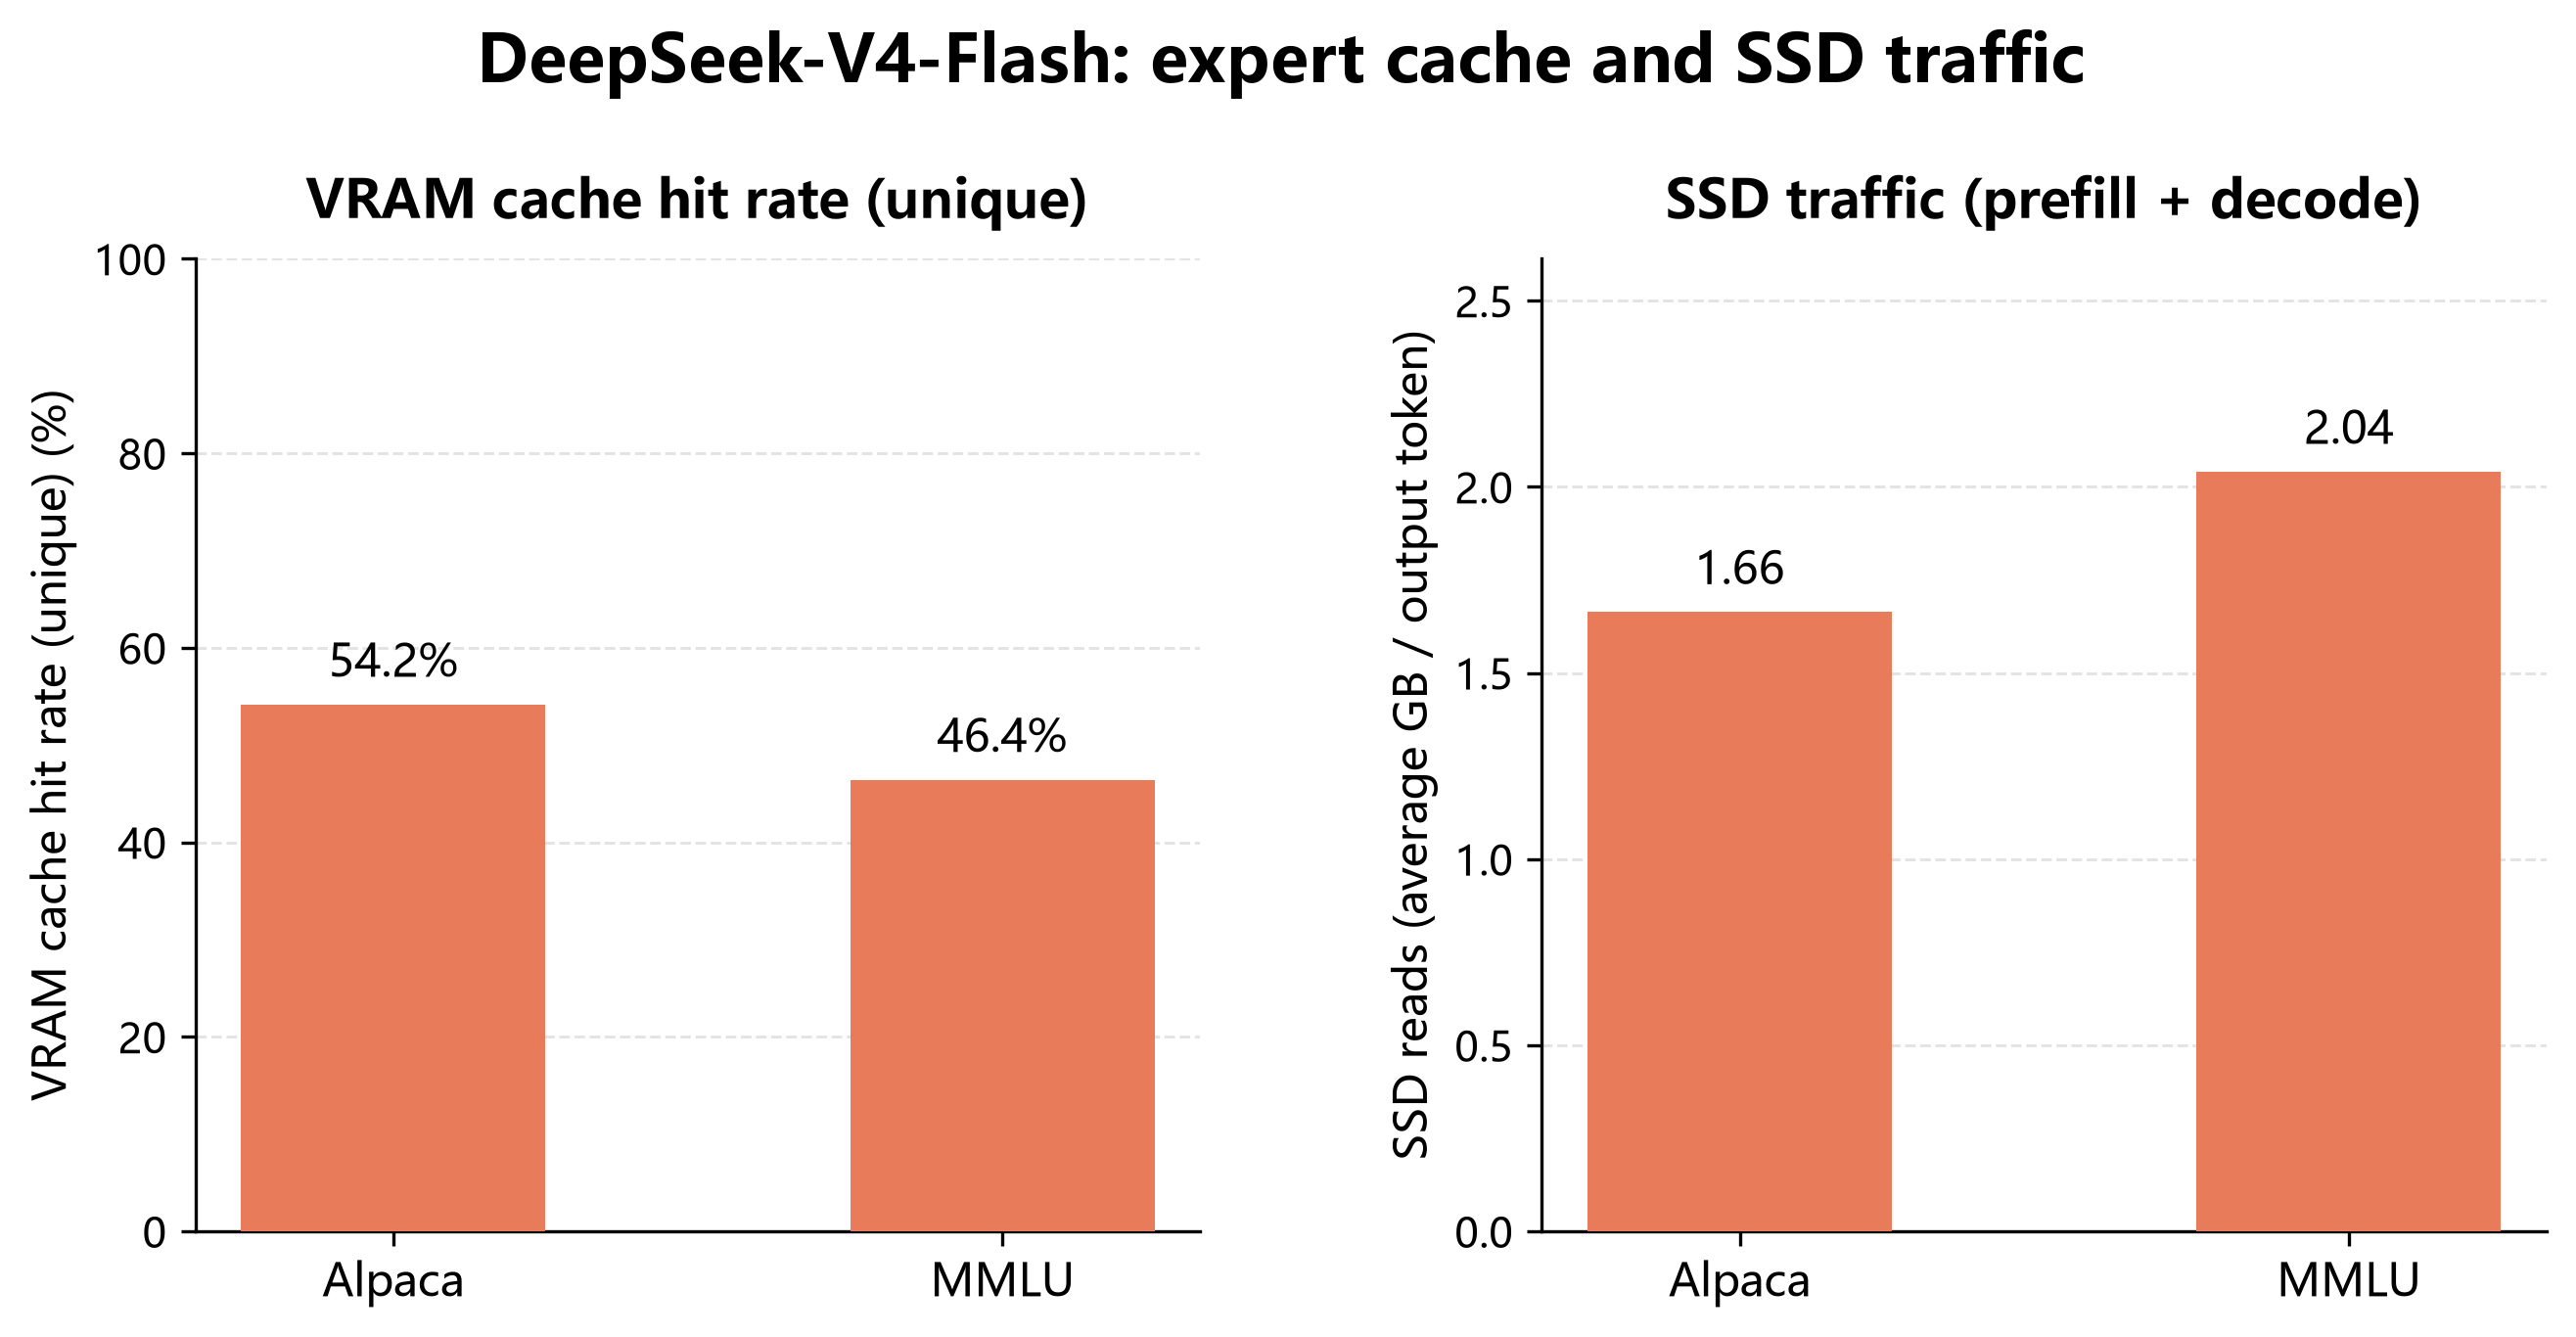
キャッシュヒット率とSSDトラフィック
DeepSeek-V4-FlashのVRAMキャッシュヒット率および生成トークンあたりの平均SSDトラフィックのデータは、本アプローチの高い効率性を裏付けている。
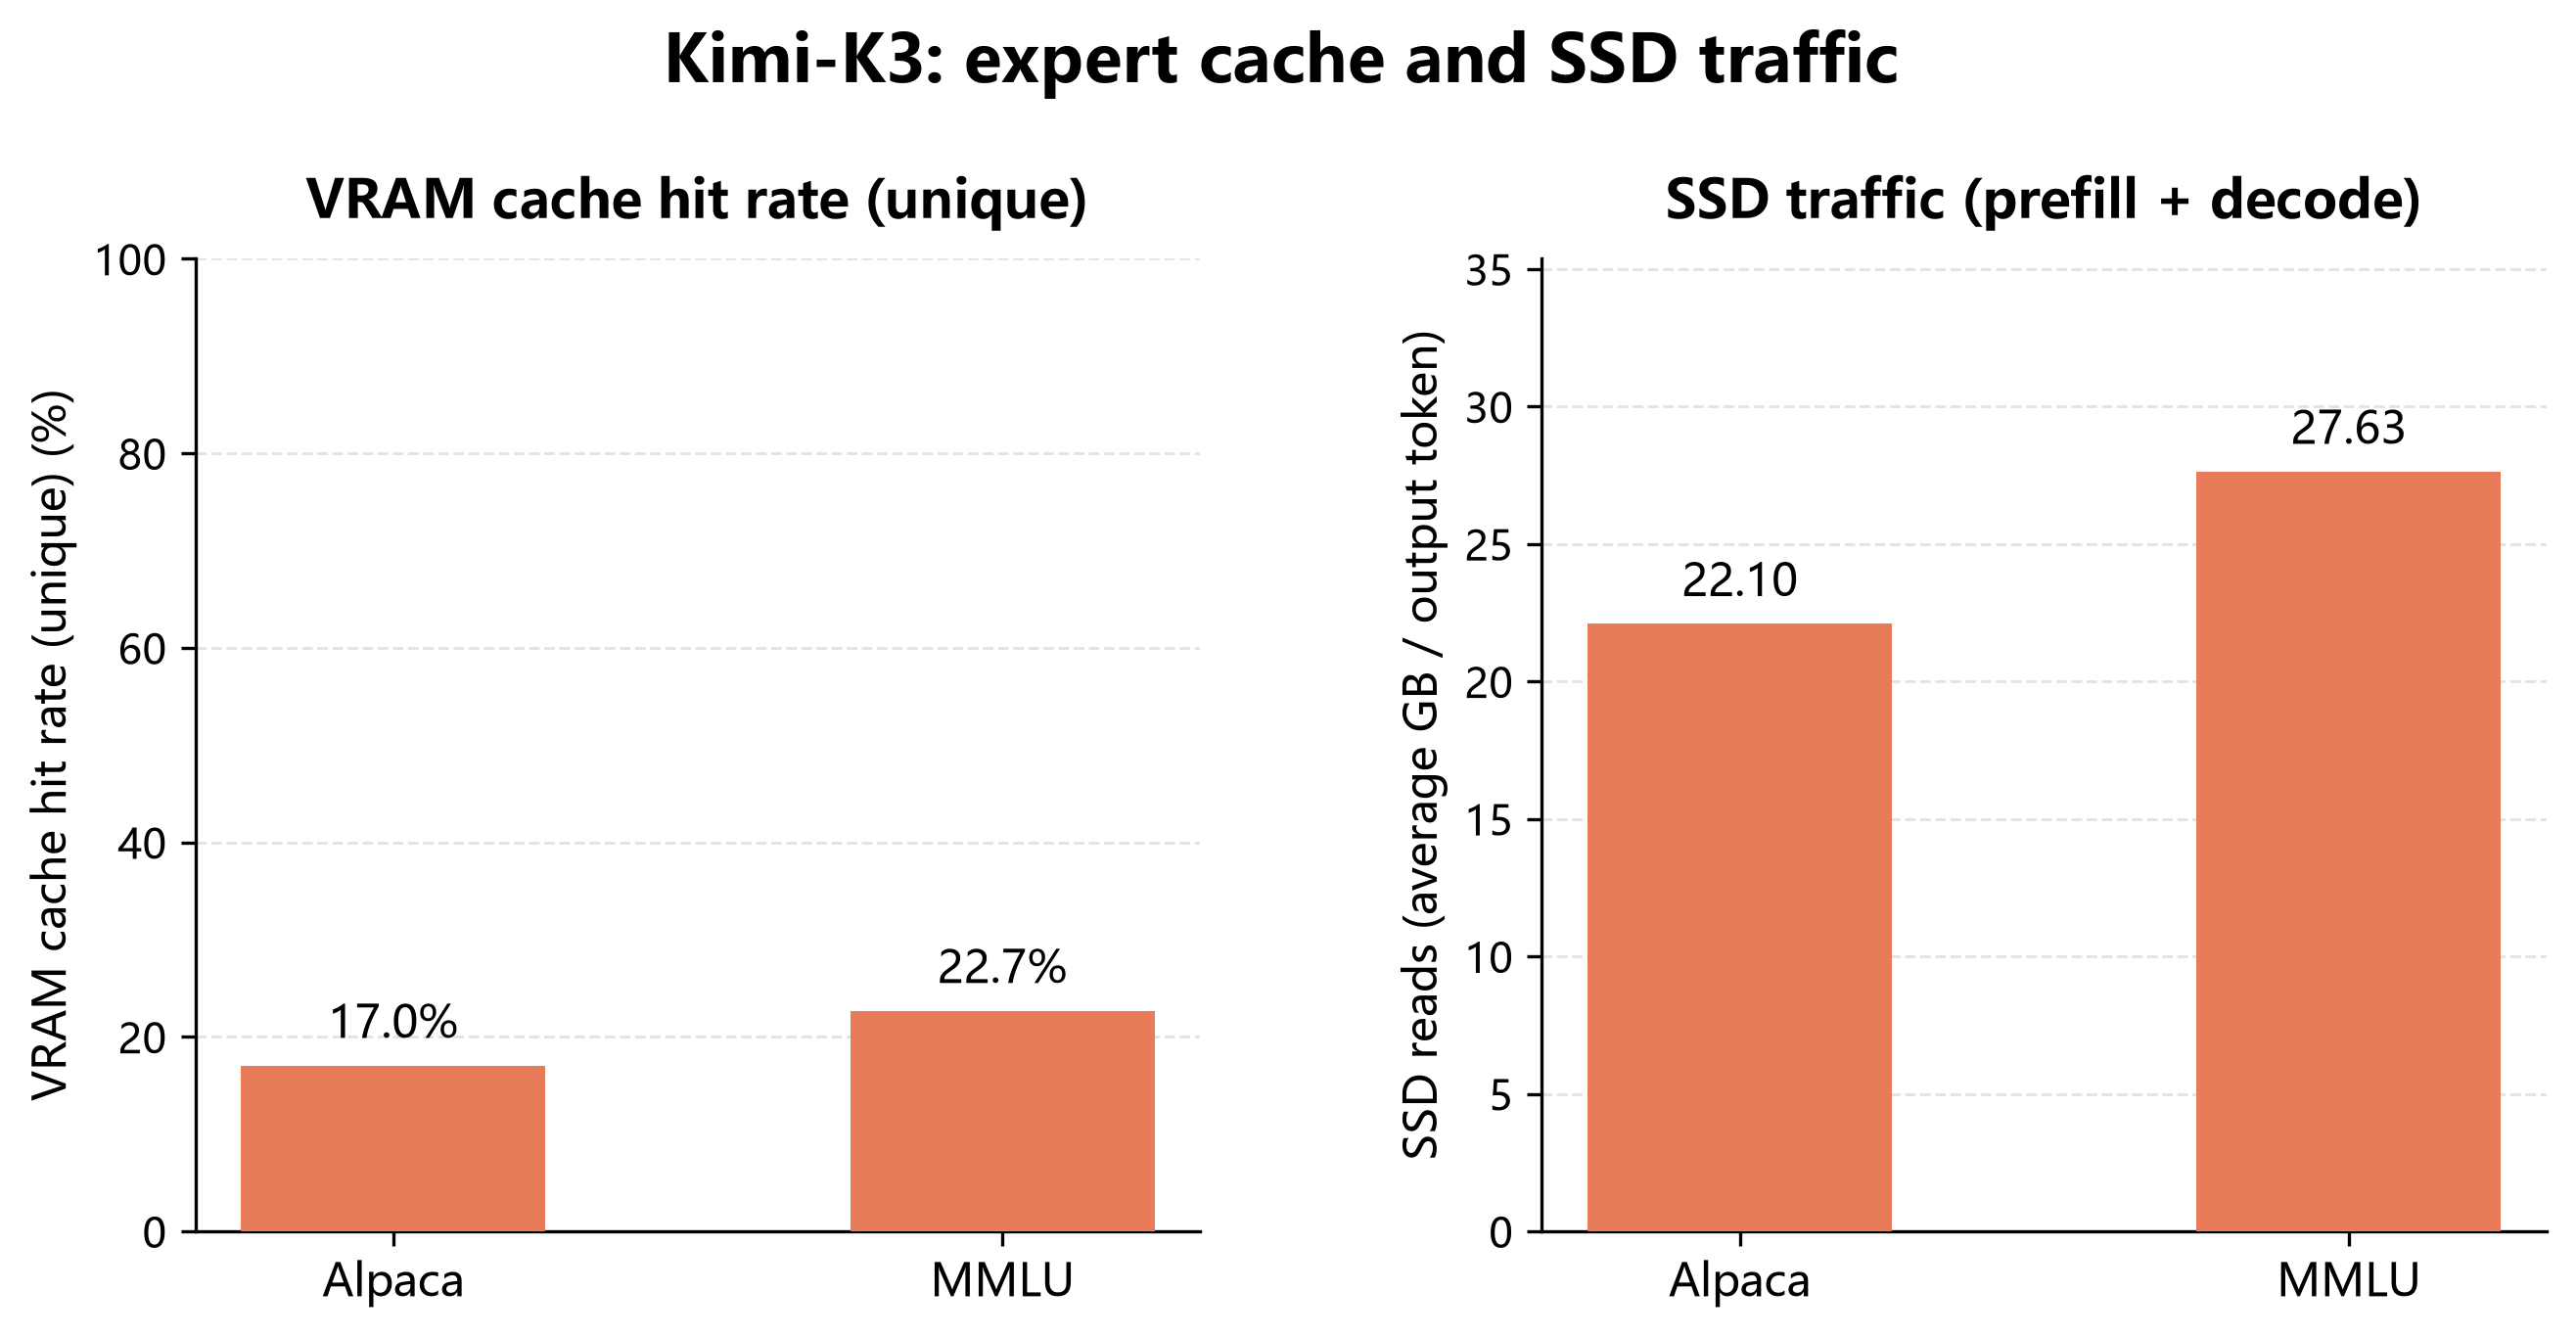
Kimi-K3の対応する指標もまた、SSDバックアップ層の実用性を証明している。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接