
今回のラウンド概要
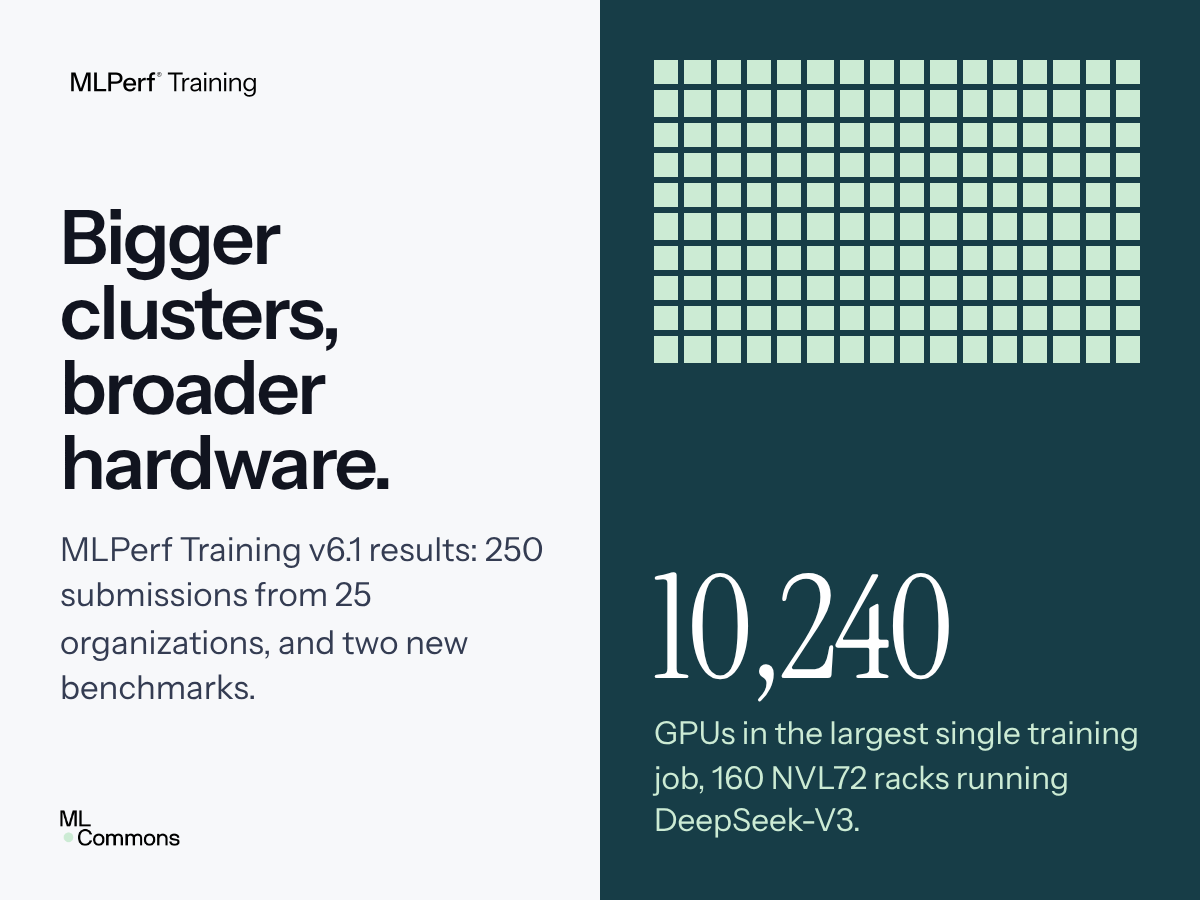
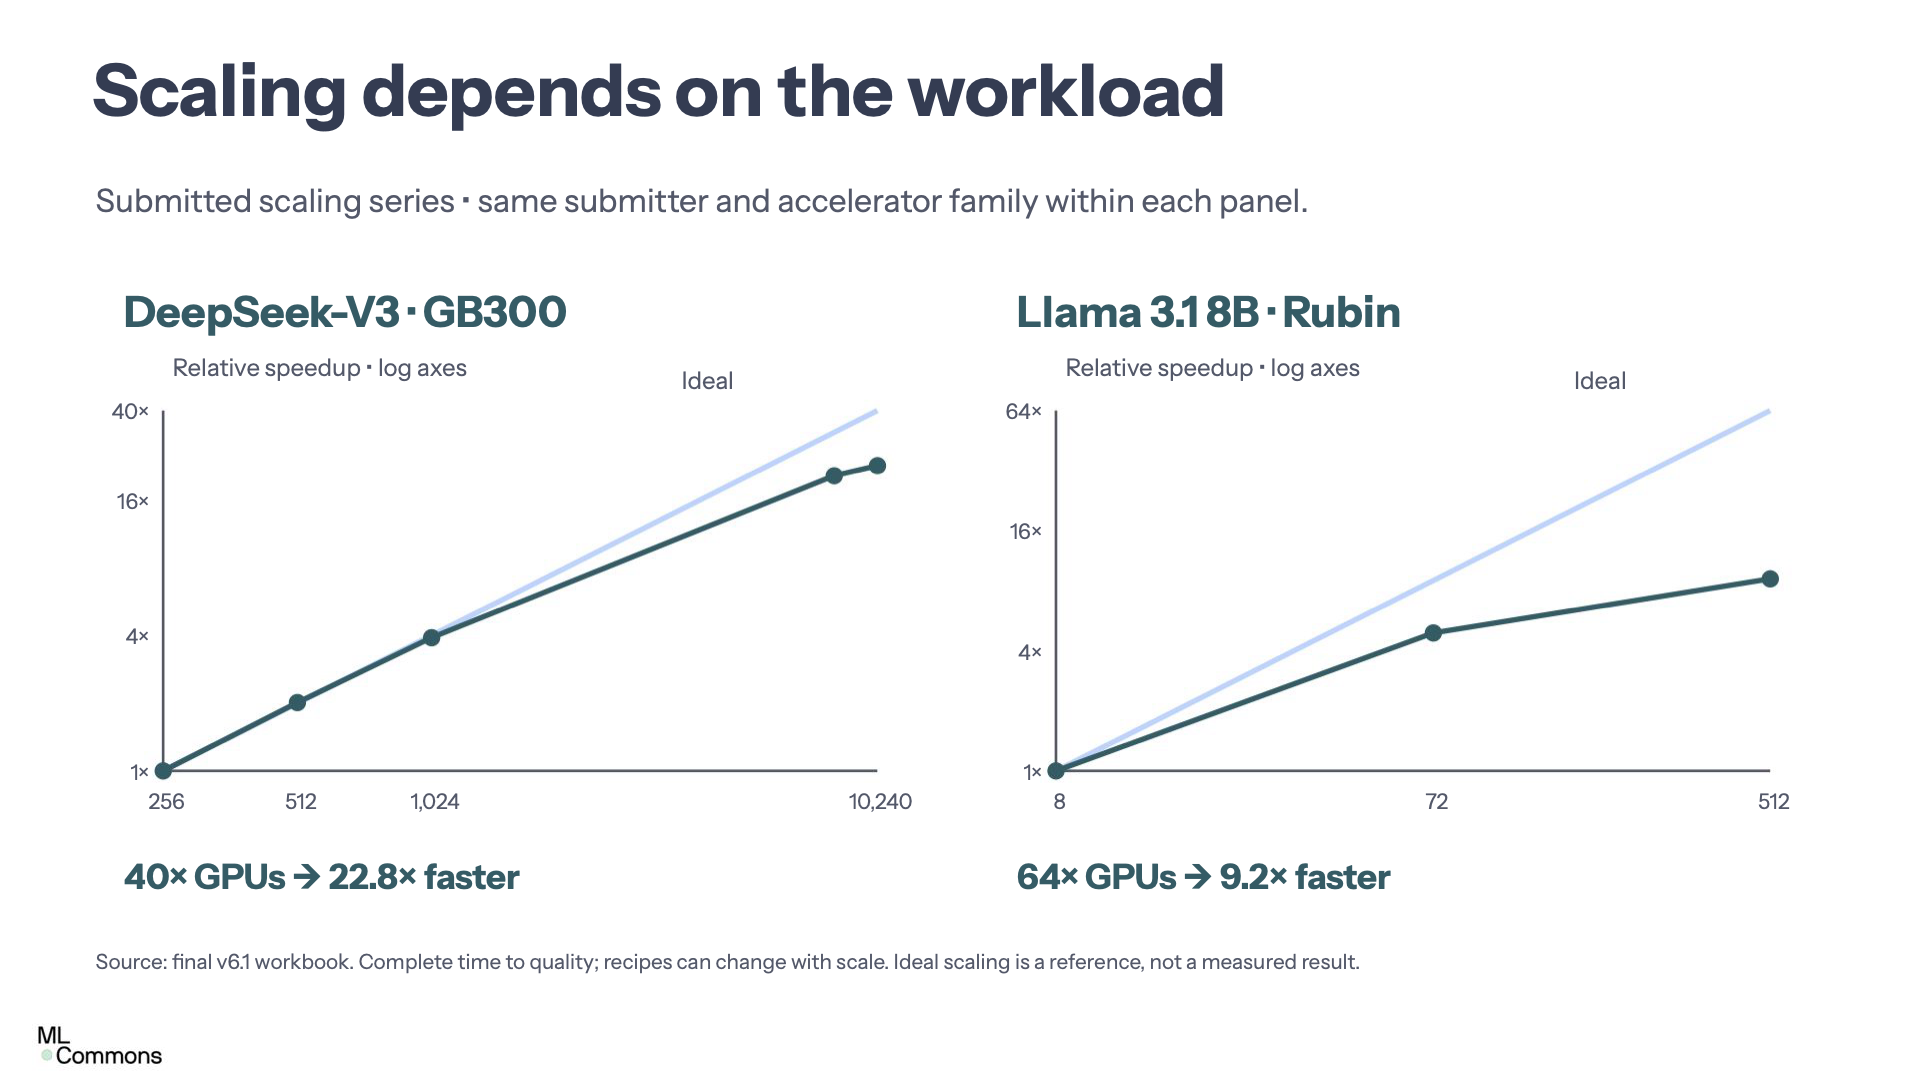
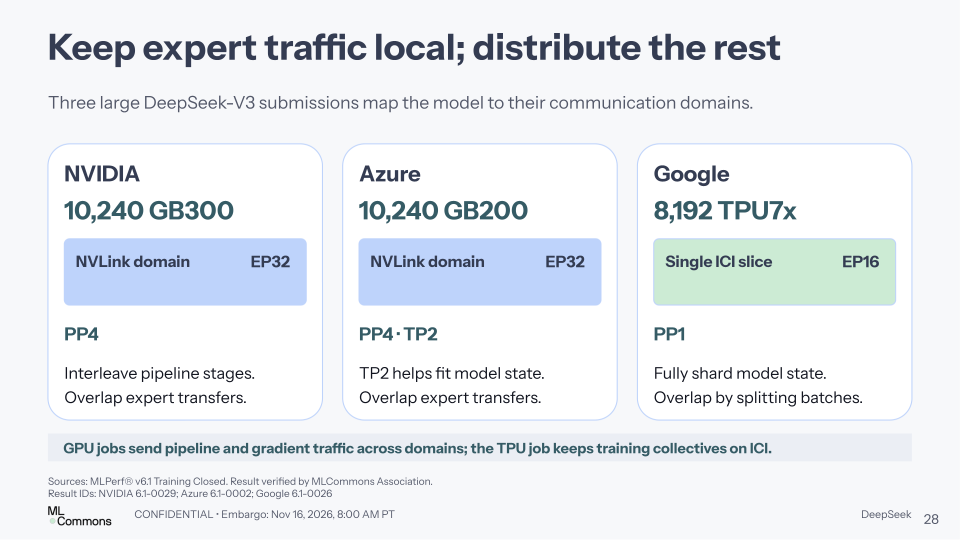
MLPerf Training v6.1はベンチマークスイートを拡張し、メンバーによるより大規模なシステムの提出が実現した。新たに2つのベンチマークが追加された。エージェント強化学習向けのQwen3.5-397B GRPOと、生成型推薦モデルのDLRMv4-HSTUである。Google IronwoodとNVIDIA Rubinが利用可能なシステムとして初登場した。最大ジョブ規模は10,240 GPU(NVIDIA GB300およびAzure GB200、いずれもDeepSeek-V3を学習)に達し、マルチノードシステムの割合は76%に上昇、ハードウェア構成は12種類のアクセラレーターと4種類のスケールアウト相互接続技術へと拡大した。
今回のラウンドでは25の提出者から250件の提出が寄せられ、v6.0の229件を上回った。
AI学習性能がムーアの法則を超える
MLPerf Trainingの性能指数の幾何平均成長率は、2年ごとに倍増するというムーアの法則の想定を大幅に上回っている。v0.6からv6.1にかけての累計性能向上は顕著であり、特にFLUX.1などのタスクで際立った成果を示している。
継続ベンチマークの性能比較
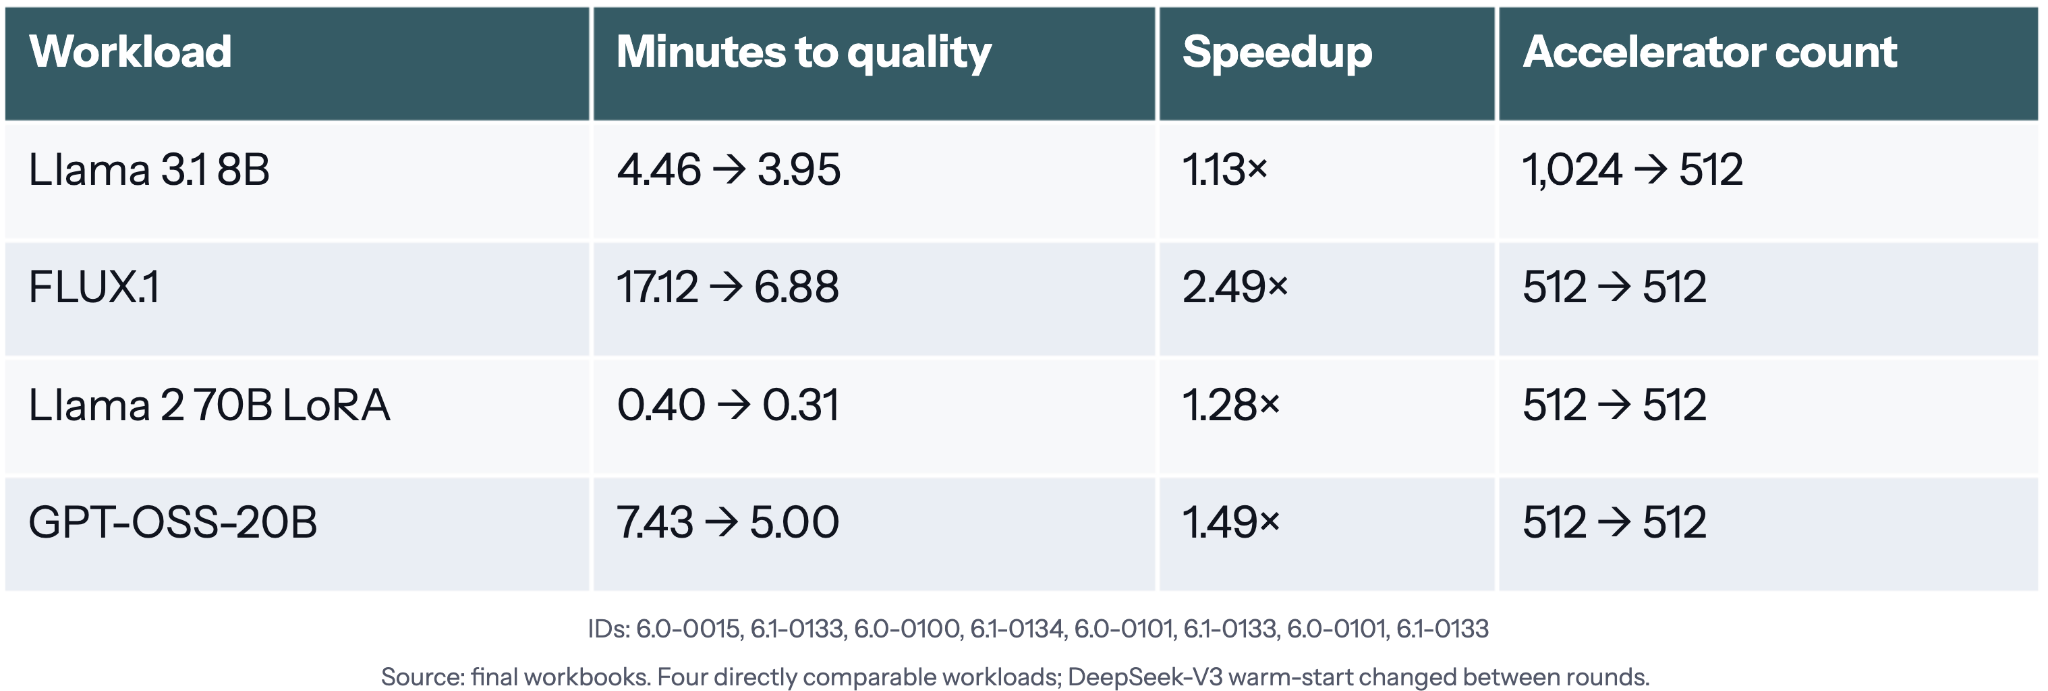
継続して実施されている4つのベンチマークにおいて、同規模のシステム(128ノード、512アクセラレーター)がv6.1で顕著な性能向上を示しており、特にFLUX.1の向上が著しい。
ベンチマークの更新
Qwen3.5-397B GRPO(7提出者・29件の結果)とDLRMv4-HSTU(8提出者・20件の結果)が新たに追加された。一方、Llama 3.1 405BとDLRM-DCNv2は退役し、MoEモデルと次世代推薦タスクへの移行が図られた。
提出者の構成と目的
チップベンダーは新シリコンの初披露に注力し、サーバーベンダーは多様な構成オプションを提示、クラウドサービスプロバイダーは本番環境における競争力を検証、学術機関は共有クラスター上で提出を完了した。ソフトウェア最適化と消費電力測定においても注目すべき成果が見られた。
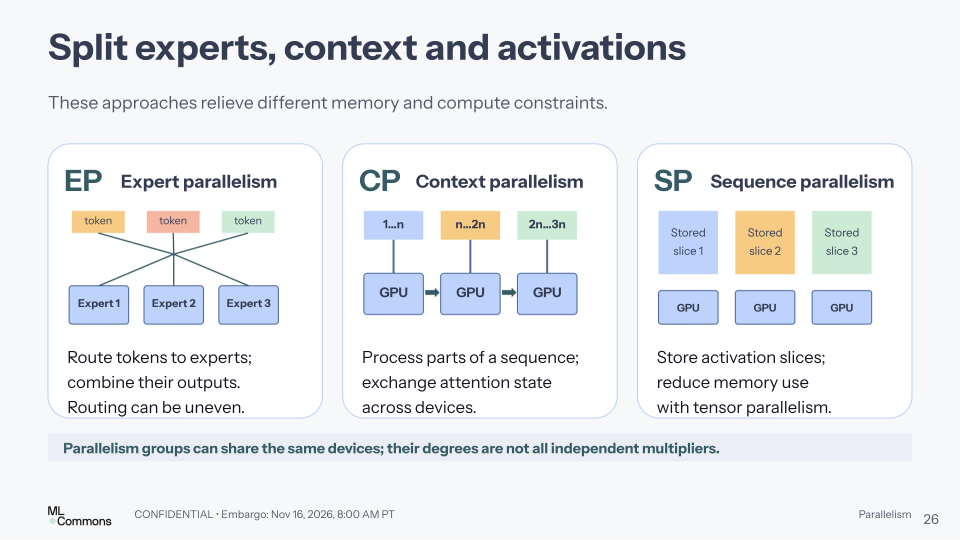
マルチノードシステムが標準に
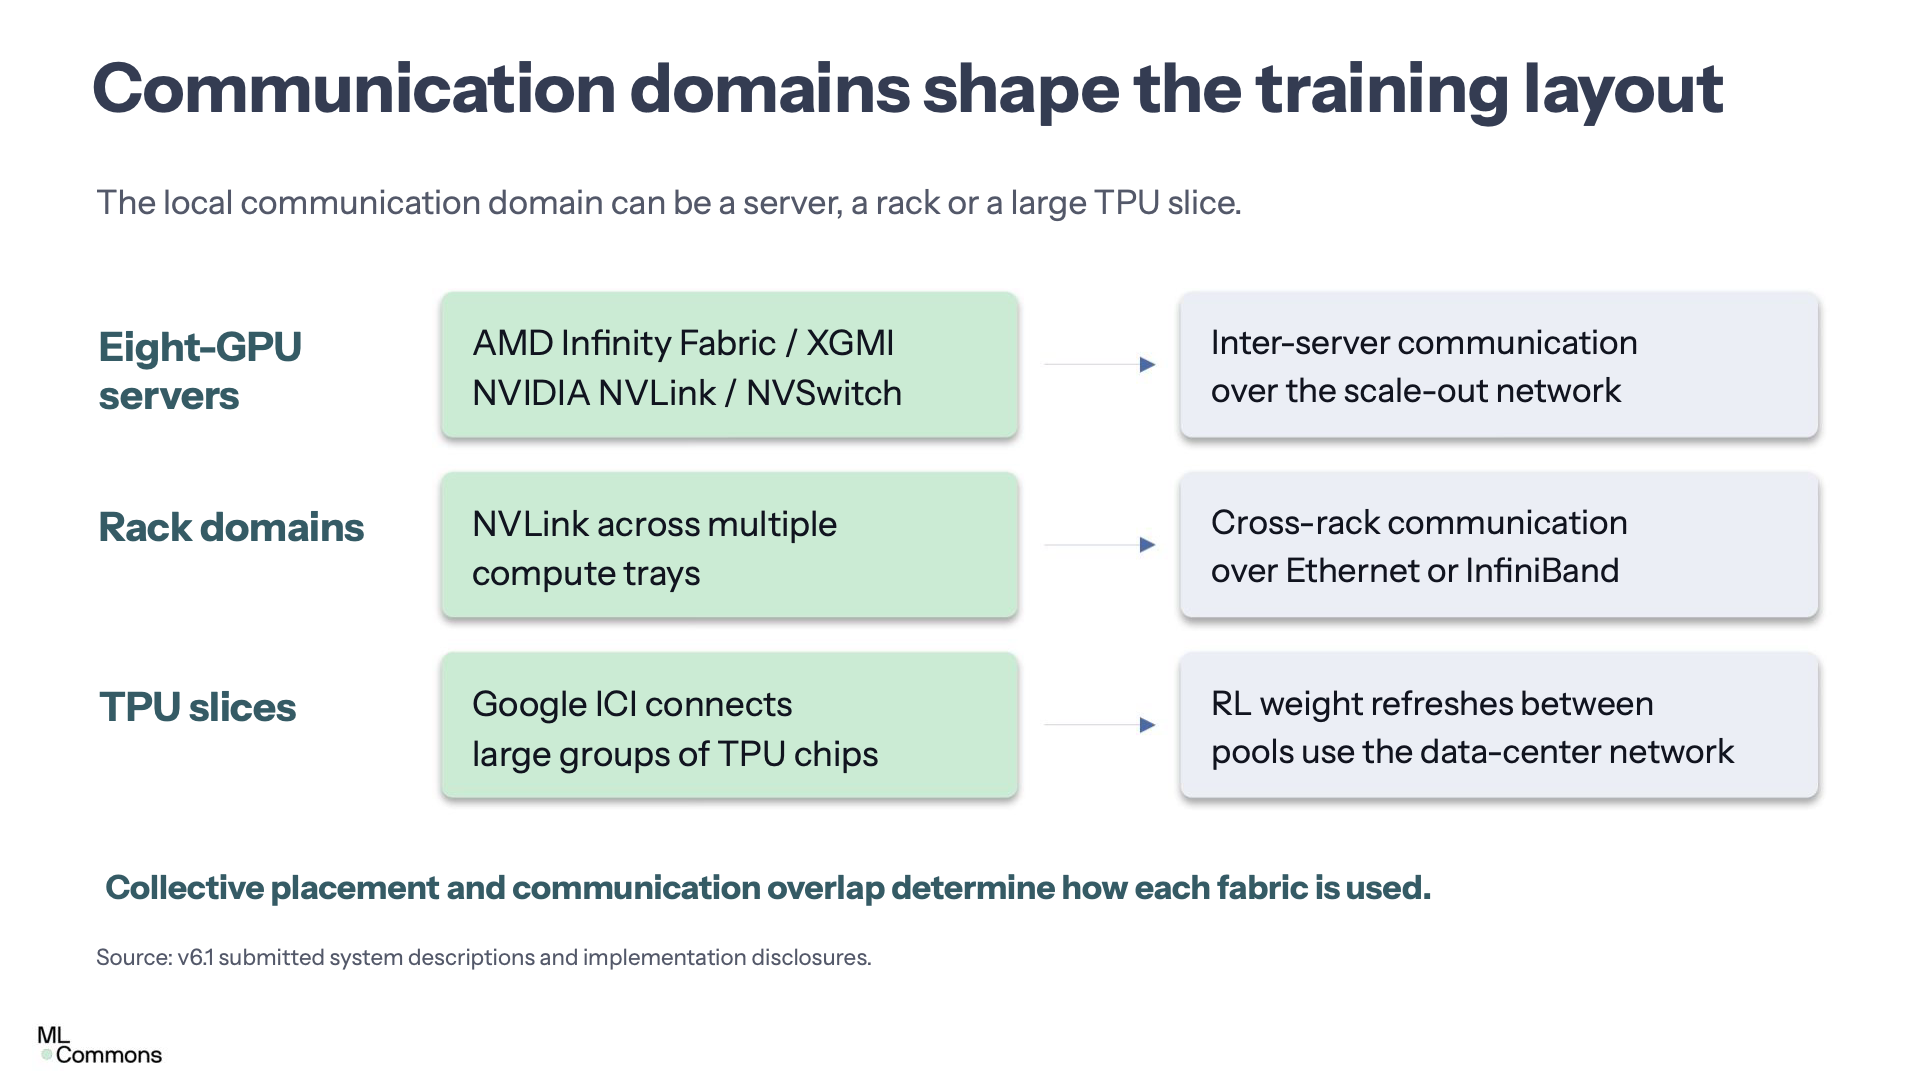
システムの76%がマルチノードを採用し、最大規模は10,240 GPUに達した。ノード設計はラック規模へと進化しており、4アクセラレーター構成のノードと8アクセラレーター構成のサーバーが共存している。
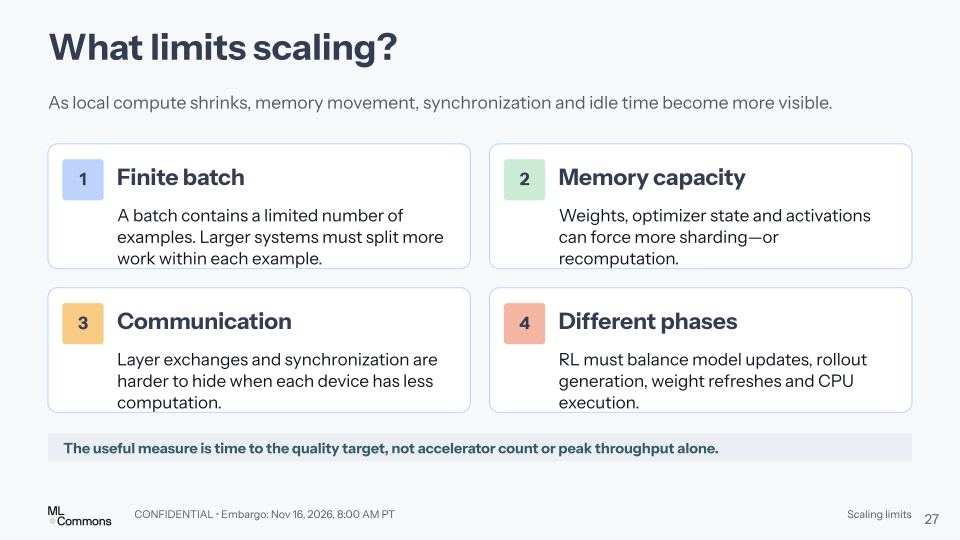
アクセラレーターの分布
NVIDIAの製品が122システムを占め、AMDとGoogle TPU7xがそれぞれ27システムと4システムに貢献しており、ハードウェアの多様性は引き続き拡大している。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接