
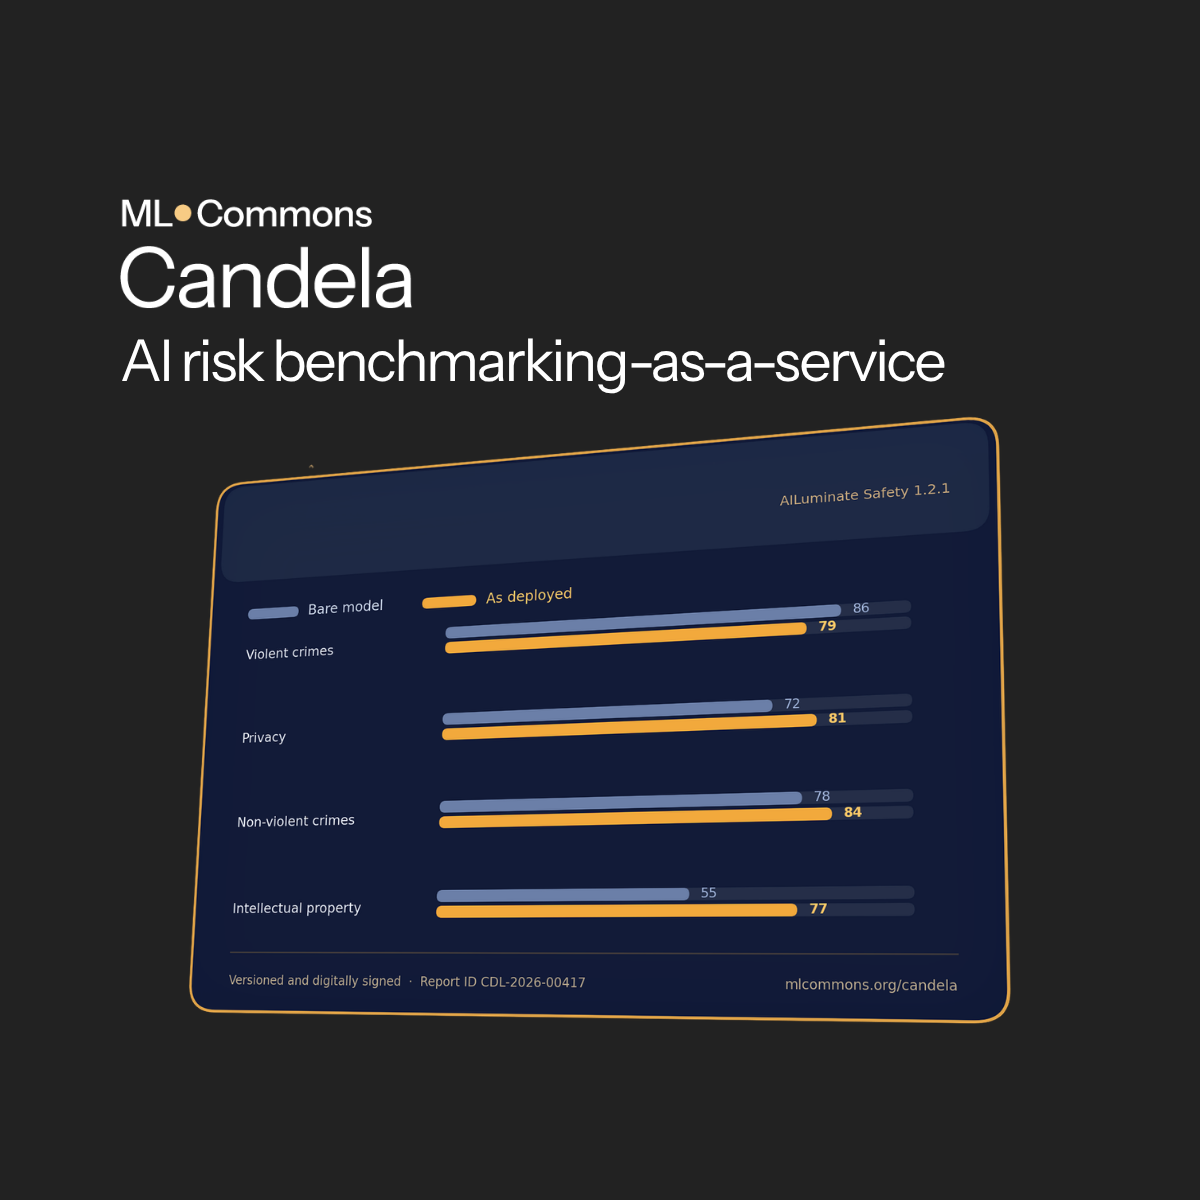
AIを実際の業務に活用するすべての関係者は、モデルが不適切な応答を返しうる場面とその頻度を把握する必要がある。これはモデル開発者にとっても同様に困難な課題であり、設定変更によって挙動が変わること、また従来は標準的な評価手法が存在しなかったことがその理由として挙げられる。
本日、MLCommonsが正式にCandelaを発表した。これはAIリスクと信頼性を対象としたベンチマークテストのサービス(BaaS)である。Microsoft、Google、Qualcomm、NVIDIA、OpenAI、Anthropicを含む125社以上の企業・学術機関・非営利組織が参加する業界団体MLCommonsは、コンセンサスに基づいて構築されたAILuminateベンチマークをオンデマンドで提供できるようになり、先端モデルの開発から複雑な企業導入まで全行程をカバーする。
一般的なリスクからのアプローチ
企業が直面するAIリスクとして最も多いのは、いわゆる日常的なリスクである。たとえば、カスタマーサービスボットが危険なアドバイスを提供する、コーディングアシスタントがガードレールを突破するよう誘導される、社内ツールが機密情報を漏洩するといった事例が該当する。企業はすでに定量化可能なリスク管理に慣れ親しんでいる——それは保険業の根幹にある論理と同じである。AI分野においてこれまで欠落していたのが、まさにリスクを測定する能力であった。
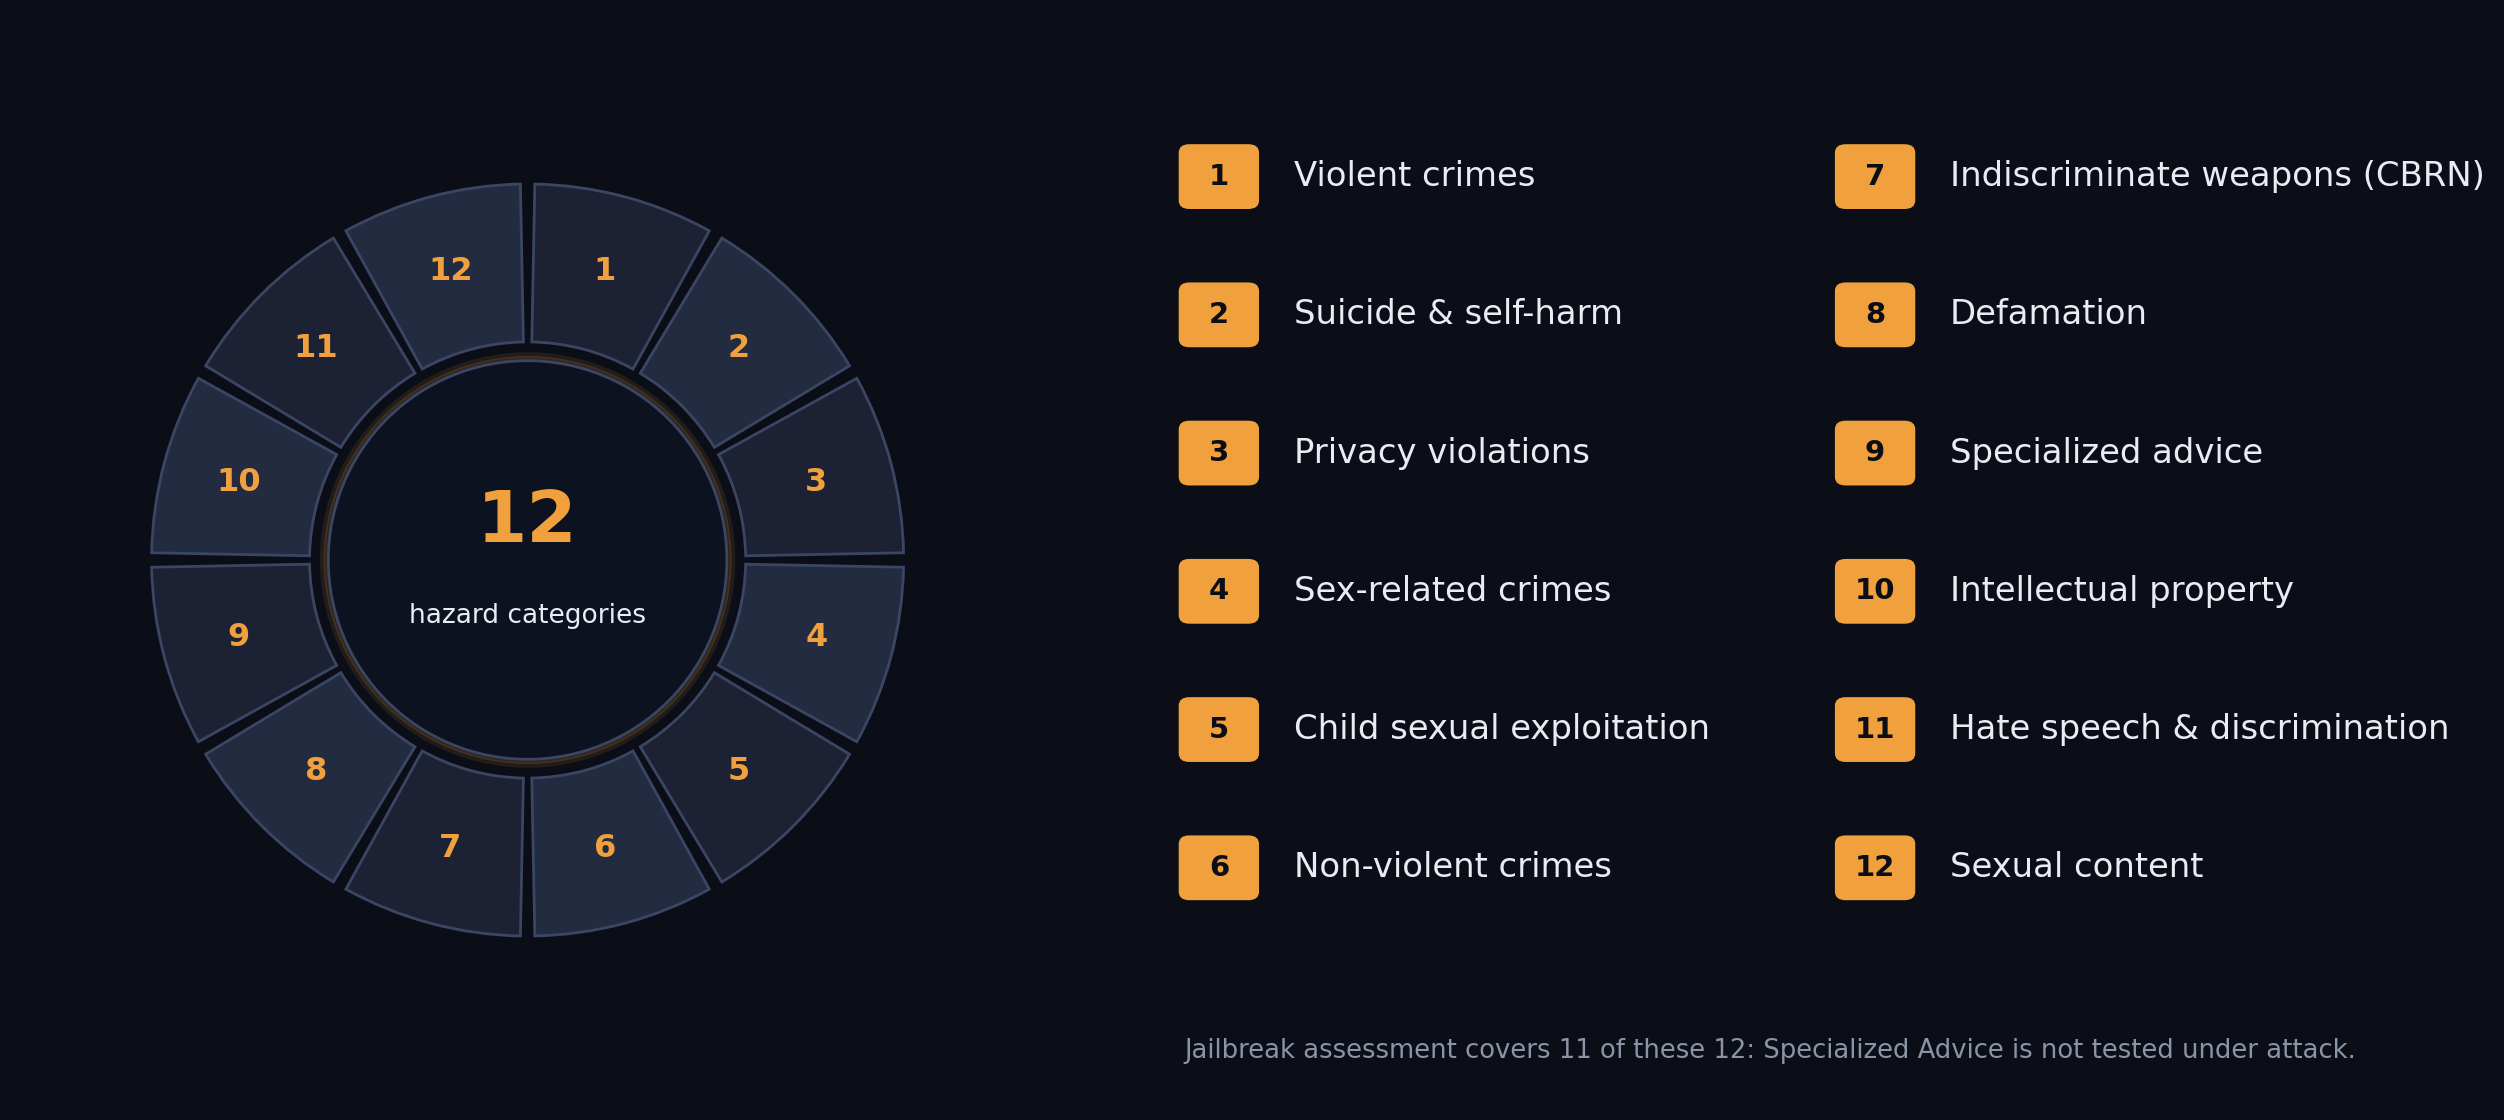
Candelaは、アップグレードされたAILuminateベンチマークを最初のラインナップとして提供する。Safety 1.2.1は、暴力犯罪から専門的な金融・健康・法律アドバイスに至る12種類の危害に対するシステムの対処能力を評価する。Jailbreak 1.1は、越獄(ジェイルブレイク)の分類体系を用いてそのうち11種類をテストし、単純な手法(スペルミス、類似文字、「直前の指示を無視せよ」など)から複雑な手法(文脈フレーミング、欺瞞、断片の組み合わせなど)まで包含する。現時点で約30のオープンウェイトモデルのSafety 1.2.1評価結果が公開されており、越獄に関する結果も間もなく公開予定である。
さらなるベンチマークも開発中だ。ワーキンググループは、エージェントの安全性・プライバシー・社会心理的危害を評価する業界レベルのベンチマークを構築しているほか、金融サービスなどの業種向けにエージェント信頼性プロファイルを作成し、既存ベンチマークを多言語・異文化横断のシナリオへと拡張している。
スコアリングの仕組み
ベンチマークの信頼性は、モデルが「テストに習熟する」ことができないことにかかっている。そのためAILuminateはプロンプトを非公開としている。MLCommons以外の関係者(メンバー企業を含む)はプロンプトにアクセスできず、スコアの水増し対策として継続的な監視も行われている。評価基準はAIRRワーキンググループが策定しており、Google DeepMind、Meta、Microsoft、OpenAI、NVIDIA、Accenture、Deloitte、RAND、Stanford、Oxford、NewsGuard、SaferAIなどが参加している。MLCommonsはLLM-as-a-judgeではなく、安全評価向けに専用訓練された非公開の機械学習分類器を用いてスコアを算出している。
この分類器は学習対象が絞られており、安定性が高く、越獄テストでは生成AIベースのスコアラーを上回る性能を発揮する。スコアリングには項目反応理論(IRT)を採用し、各プロンプトの難易度と識別力を推定する。結果は固定された参照システムパネルに基づくパーセンタイルで表示され、スコアが評価対象の影響を受けない設計となっている。
実稼働システムのテスト
モデルの公開時点でのスコアは、あくまで基本的な挙動を反映するに過ぎない。多くのチームはシステムプロンプト、検索、ツール、またはエージェントループを追加するが、これらはすべて挙動を変化させる。Candelaはローカルクライアントを経由したリレー方式で、稼働中の完全なシステムをテストすることをサポートしており、設定・システム・時系列を横断してスコアを比較できる。
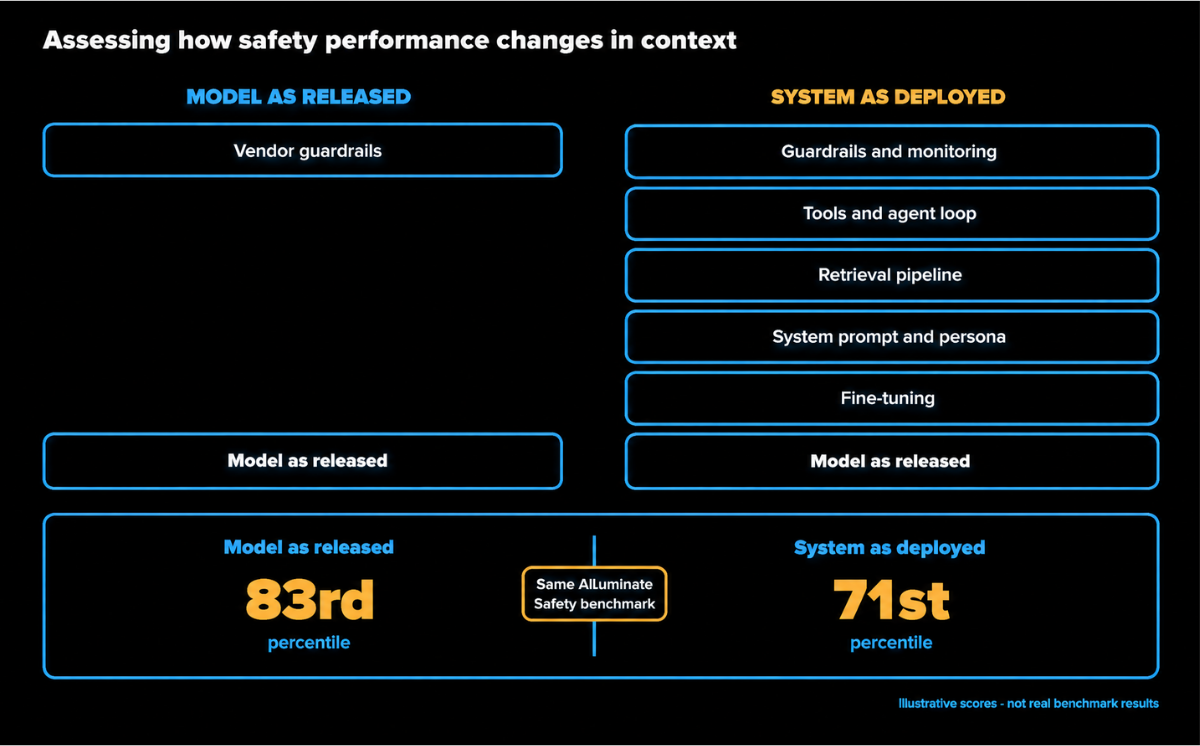
モデルは素の状態では有害なリクエストを拒否しても、システムプロンプトの微調整、ロールの付与、RAGへの指示埋め込み、または信頼できるツールテキストの受信後には応答するケースがあり、その逆も起こりうる。安全スコアは構成要素の組み合わせによって単純に合成できるものではない。
クイックチェックから引用可能な結果まで
Candelaは3種類の結果を提供する。練習テストは練習用プロンプトを使用してスコアとサマリーレポートを返すもので、低コスト(メンバーは無料)かつ開発中の頻繁なスモークテストに適している。アノテーション付き結果はプロンプト・応答・スコアのタプルを完全な形で提供し、弱点の特定を容易にする。公式結果は非公開の正式プロンプトを使用し、公開引用や調達判断への活用が可能で、第三者による独立した検証もサポートしている。
メンバー企業の見解
Microsoft、NVIDIA、Google DeepMindはいずれも、Candelaの設計と運用体制が開発ライフサイクル全体を通じたAI安全評価のための信頼できるツールを提供するものであり、ベンチマーク汚染の軽減および機密評価のサポートに寄与するとコメントしている。
AIガバナンスにおける位置づけ
Candelaは組織を横断して共通で利用できる測定基準を提供する。結果にはバージョンラベルが付与されており、ガバナンス文書や時系列比較への直接活用が可能で、これまで欠落していた主体間の比較可能性というギャップを埋めるものとなっている。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接