
推薦システムはMLPerf Trainingの重要な構成要素として長年にわたり位置づけられてきた。従来のDLRMベンチマークは、個人化推薦モデルを所定の品質目標まで訓練するために要する時間をシステム単位で測定するものだった。現行バージョンのDLRMv2はECサイトやストリーミングなどのシナリオを対象とし、ユーザー行動とアイテム特徴のモデリングを通じてディープラーニングで両者の相互作用を捉え、より関連性の高い推薦結果を生成する。
しかし、シーケンシャルモデリングやLLM関連技術の発展に伴い、超大規模な本番推薦システムではアーキテクチャの移行が進んでいる。ユーザー行動を少量の集約済みDense Featureに圧縮するのではなく、ユーザーの直近インタラクション履歴をイベント単位のトークンシーケンスとして表現するようになっている。この種のモデルは計算能力やパラメータ規模の増大に伴って継続的に改善できるが、初期のFeature Interactionベースの設計は収益の頭打ちに陥りやすかった。
MLPerfはすでにInferenceスイートにHSTUベースの推薦ベンチマークを導入していたが、Trainingスイートには対応するワークロードが欠けていた。DLRMv4はまさにこの空白を埋めるものであり、従来のFeature Interaction Stackに代えてHSTUを採用し、新たなYambda-5Bデータセットを導入することで、実際の多行動音楽インタラクションデータを本番級の約560GB規模のEmbedding Footprintに拡張している。
DLRMv2からDLRMv4へ:なぜアーキテクチャを刷新するのか
DLRMv4の目的は、MLPerf Trainingが現在の本番級DLRMワークロードの変化をより正確に反映できるようにすることにある。一方では、モデルがより長いユーザー履歴上でAttentionを実行する必要があり、計算コストが大幅に増加する。他方では、約560GB規模のEmbedding Tableを複数の現代的なアクセラレーター間でShardingすることも求められる。これによりDLRMv4は単なるモデル構造の更新にとどまらず、システムの訓練能力に対する新たなストレステストともなっている。
モデルアーキテクチャ:HSTUが従来の特徴インタラクションスタックに取って代わる
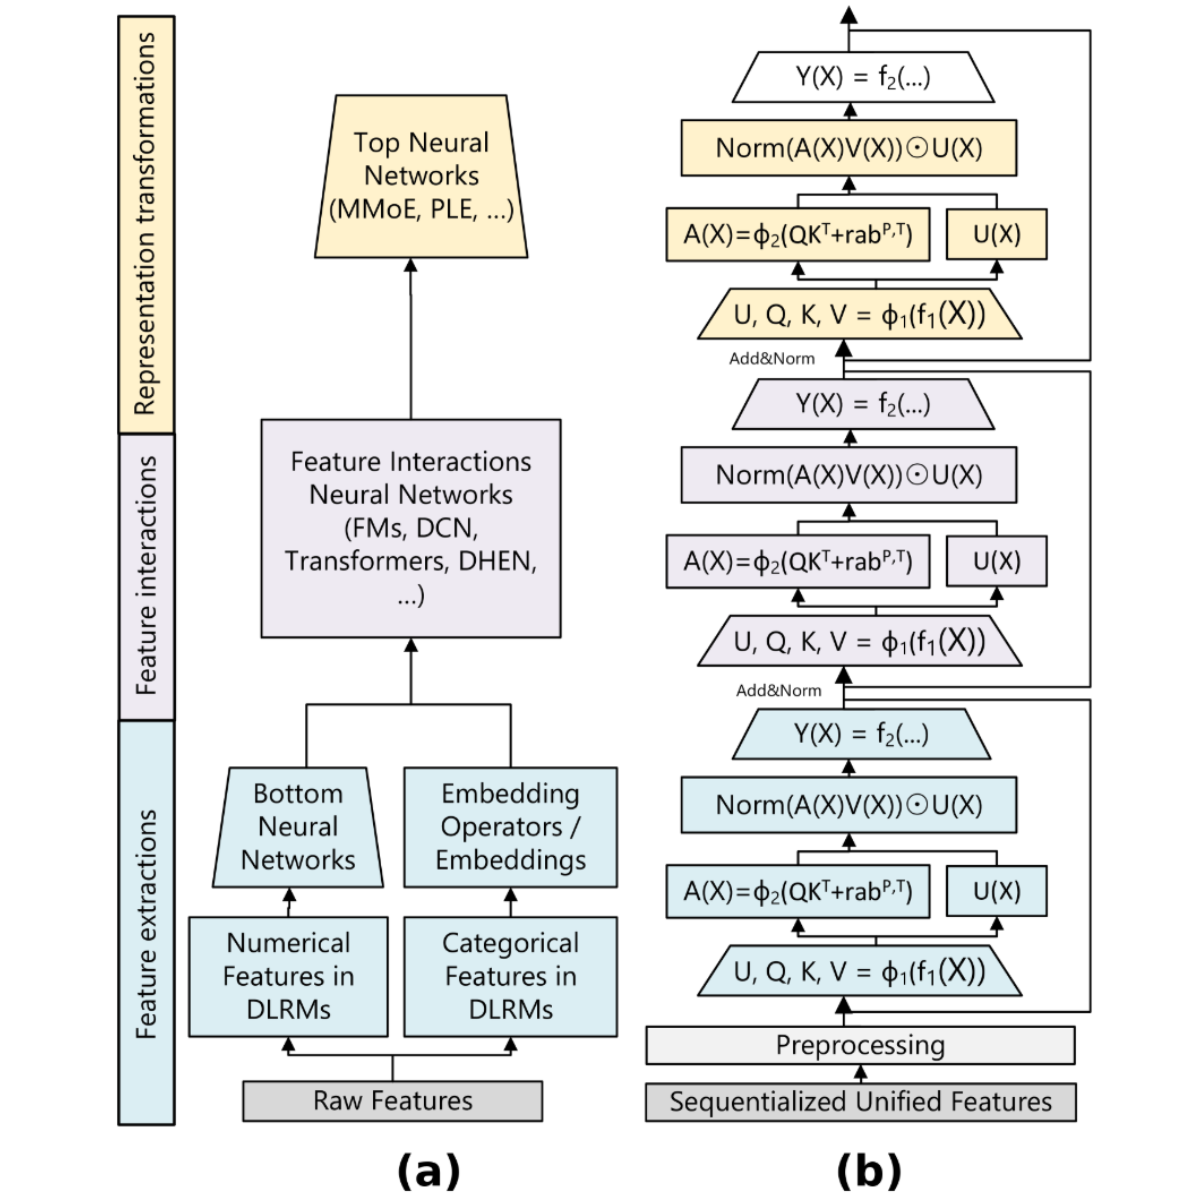
図1:従来のDLRMアーキテクチャ(a)とHSTUアーキテクチャ(b)の比較。
従来のDLRMv2が体現するのは「先にエンコード、次にインタラクション」という本番推薦の設計パターンだ。入力データは多様な形態をとり、数値特徴はBottom MLPで処理され、カテゴリIDはEmbedding LookupによってベクトルへとマッピングされるConvert。その後、これらの表現はCross Network、Factorization Machineといった専用のFeature Interactionモジュールへと送られ、最終的にTask Headが予測結果を出力する。
この設計では中心的なモデリング能力がInteractionモジュールに集中しているが、生の行動ストリームを直接参照することはできない。モデルが処理するのは通常、人手で設計されて事前に集約された入力、例えば減衰付きのカウンター、比率特徴、プーリング済みEmbeddingなどだ。
これに対しHSTUは、この役割分担を廃止する。まず異種の特徴空間を統一された時系列にシリアライズする。カテゴリ特徴やゆっくり変化するコンテキスト特徴は、ユーザーが時系列順に並べたアイテムとアクションの履歴に組み込まれ、同一のTransduction Layerの組みがエンドツーエンドで処理する。
各HSTU Layerの内部では、DLRMが分割していた3つのフェーズが1つのモジュールに統合されている。単一のProjectionがそのLayerに必要な内部表現を生成し、Pointwise Attentionが2つのイベント間の位置的・時間的距離に基づくBiasを導入してシーケンス情報を集約し、Gated TransformationがAttentionで集約された特徴を直接インタラクションさせることで、従来のCross NetworkおよびFeed-Forward Blockの役割を担う。
この設計によってモデルの主要なスケーリング次元はDepth・Width・Sequence Lengthの3つに集約される。HSTU関連研究によれば、計算量と品質の間において3桁にわたる規模の範囲でべき乗則(Power-Law)の関係を維持できる。一方、従来のEncode-Then-Interactionベースラインは同じ区間で頭打ちに陥りやすい。
1つの訓練サンプルがHSTUでどのように処理されるか
コンテンツプラットフォームで特定のユーザーに対して候補アイテムをスコアリングする場合を例に挙げる。システムはまずそのユーザーの過去のインタラクションを、アイテムとアクションを時系列に交互に並べたストリームへと整理する。行動タイプには実際の試聴・明示的なLike・スキップなど複数のシグナルが含まれ、数千イベントという固定の上限に切り詰められる。
各イベントはトークンとなり、「ユーザーが何を見たか・聞いたか」「ユーザーがどのアクションをとったか」「イベントがいつ発生したか」という情報を持つ。そのため、スキップのような負のフィードバックはあるカウンターに平均化されることなく、一級のイベントとしてシーケンス内に保持される。
ユーザーIDや事前計算済みのCross Featureといったゆっくり変化するコンテキストは、少数のPrefix Tokenに圧縮されて同一シーケンスの先頭に配置される。スコアリング対象の候補アイテムはシーケンスの末尾に追加される。これにより、モデルは追加のTarget-Aware Poolingステップを必要とせず、単一の順伝播(Forward Pass)の中で候補コンテンツと完全な履歴を比較できる。
最終的に、HSTU Stackがこの因果的シーケンス全体を処理し、候補位置の表現が小型のHeadに送られてEngagement Predictionを出力する。履歴・コンテキスト・候補ターゲットを同一のCausal Block内で統合的にモデリングするのが、HSTUが本番推薦システムにより近く、かつシステムの訓練能力をより試す点での核心だ。この構成はMLPerf DLRMv3 Inference Benchmarkのモデルカテゴリとも一致している。
データセット:Yambda-5Bがもたらすリアルな多行動タイムライン
DLRMv4はYambda-5Bを使って訓練を行う。Yambda-5BはYandex Musicが公開リリースしたもので、実際のユーザー多行動インタラクションを含む公開型推薦データセットとしては現在最大規模のものの1つだ。このベンチマークでは完全な5Bイベント版を採用している。
| 属性 | 数値 |
|---|---|
| Source | Yandex Music public release |
| Interactions | 約4.79B |
| Users | 1M |
| Items | 9.39M |
| Behavior types | 5種類:listen、like、dislike、unlike、undislike |
| Raw size | 約38GB(Yambda-5B variant) |
| Per-event bytes | 約20バイト |
表1:Yambda-5Bデータセットの主要属性。
DLRMv2が使用するCriteo 1TBデータセットと比較すると、YambdaはHSTU型モデルに適している。理由はHSTUが真のPer-User Timelineを必要とするためであり、各インタラクションにユーザー・アイテム・アクションタイプ・タイムスタンプが記録されているため、時系列順に各ユーザーの行動履歴を再構築してシーケンスとしてTransducerに入力できる。また約4.79Bのインタラクションは、完全な訓練実行を通じて継続的な負荷を維持するうえでも十分な規模だ。
| 指標 | Criteo 1TB(DLRMv2) | Yambda-5B(DLRMv4) |
|---|---|---|
| Real data | Yes | Yes |
| Interaction volume | 4.2B rows | 4.79B rows |
| Per-user history | No、Flat Featuresのみ | Yes、Multi-behavior pools |
| On-disk size(raw data) | 約4TB(denormalized) | 約38GB(normalized) |
| Embedding Table Size | 約100GB | 約560GB(Cross-Feature Tables追加後) |
| HSTU-aligned | No、Sequence Axisなし | Yes |
表2:Yambda-5BとCriteo 1TB(DLRMv2)の比較。
特徴拡張:Embedding Tableが約560GBへ拡大
元のYambdaには4種類のNative Sparse Feature(item、artist、album、uid)が含まれる。DLRMv4はさらにCross-Product Hashed Tableを追加する。Cross Featureは産業用推薦システムで広く用いられる手法であり、user × artistやitem × hour-of-dayといった特徴の組み合わせを明示的に表現することでランキング品質を向上させる。最近の研究では、Cross Featureへのメモリ配分を増やすことでその効果がスケールアウトし続ける可能性も示されている。
これらの特徴を導入することで、DLRMv4は実際の本番モデルに一層近づくと同時に、512次元EmbeddingおよびFP32精度の下でEmbedding Tableの規模が約560GiBに達する。
| Table | Category | Cardinality | Size(512 Embedding Dimension、fp32) |
|---|---|---|---|
| item | native | 9.39M | 19.2GB |
| artist | native | 1.29M | 2.6GB |
| album | native | 3.37M | 6.9GB |
| uid | native | 1M | 2.0GB |
| user × artist | cross feature | 100M | 204.8GB |
| user × album | cross feature | 40M | 81.9GB |
| user × hour | cross feature | 24M | 49.2GB |
| item × hour | cross feature | 40M | 81.9GB |
| artist × hour | cross feature | 32M | 65.5GB |
| user × is_organic | cross feature | 2M | 4.1GB |
| user × artist × hour | cross feature | 40M | 81.9GB |
| Total | 約560GB |
表3:Cross-Product Feature Tableを用いたYambda-5Bの特徴拡張。
データ分布がなぜ重要なのか
実際の推薦トラフィックは通常、高度に偏在している。一部の人気アイテムが大量のインタラクションを生み出す一方、ロングテールのコンテンツが広大なアイテムカタログの大部分を占める。推薦ベンチマークが本番システムを代表するものであるためには、同様のデータ分布特性を備えていなければならない。MLCommonsはYambda-5Bを分析し、実際の推薦シナリオにおけるSkewed Trafficの特性を備えているかどうかを確認している。
総じてDLRMv4の意義は、単一のモデルやデータセットを置き換えることにとどまらない。MLPerf Trainingにおける推薦ワークロードを、従来の特徴エンジニアリングと明示的インタラクションモジュールの枠組みから、長いユーザー履歴・シーケンシャルな行動モデリング・超大規模Embedding Shardingに向けた新たな段階へと押し進めるものだ。訓練システムにとっては、より複雑なAttention計算・より大きなEmbedding Footprint・超大規模な本番推薦システムのデータ形態に近い入力の三重の課題に同時に直面することを意味する。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接