
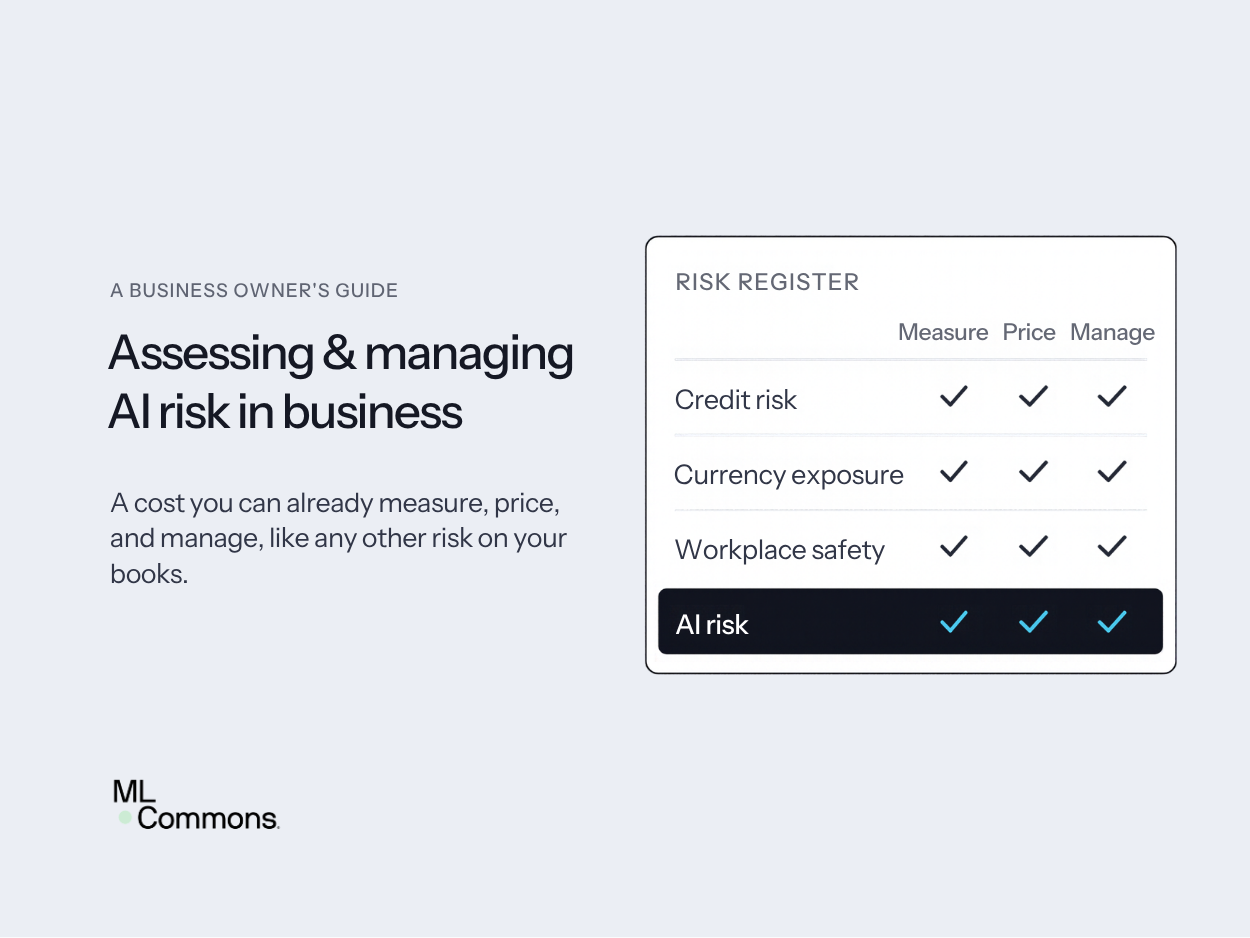
AIリスクを担当するチームは、二つの目標の間に挟まれている。一方では企業を損害から守り、他方ではAIのより迅速かつ広範な実装を支援しなければならない。しかもリソースはほとんど増えていない。MLCommonsは、AIガバナンスの価値はまさにここにあると考えている。すなわち、リスク管理をビジネスの優先事項・企業価値観・監査可能なエビデンスと結びつけることだ。
AIリスクはすでに企業の帳簿に載っている
成熟した組織はすでにリスク管理のサイクルを持っている。リスクエクスポージャーの特定、期待損失の試算、リスク水準に応じたコントロール措置の配分、そして残余リスクを責任ある経営層へ報告するというサイクルだ。保険会社がリスクに価格をつけ、監査機関がテストを行い、取締役会が最終的に承認する。
企業はセキュリティインシデントのコストをよく知っており、AIはそのコストをさらに増大させている。IBMの2025年版Cost of a Data Breachレポートによると、データ侵害の世界平均コストは444万ドル、米国では過去最高の1,022万ドルに達する。同研究はさらに、AIの導入速度がAI監督能力を上回っていることも明らかにした。侵害が発生した組織のうち、63%がAIガバナンスポリシーを持っていないか、策定中の段階にあった。また「シャドウAI」を多用する組織では、データ侵害コストが平均でさらに約67万ドル増加する。
規制面での影響も無視できない。生成AIが登場する以前から、GDPRやCCPAはAIが関与し得る自動化された意思決定に対して厳格な要件を課している。EU AI Actの制裁はさらに強力で、最大3,500万ユーロまたは全世界売上高の7%に達するため、AIリスクの積極的な管理は企業にとって避けられない課題となっている。
朗報は、すでに展開されたAIシステムのリスク管理にまったく新しい哲学が必要というわけではないことだ。企業は他のオペレーショナルリスクと同様に、十分に信頼できるエビデンスを求め、AIシナリオに適した新しい測定ツールを活用すればよい。
航空業界からの教訓:測定できてこそ、信頼できる
新たなリスクを効果的に管理することの見返りは、損失回避だけではない。業界全体の健全な発展を形成することにもつながる。1959年、米国の商業航空では百万回の離陸あたり約40件の致命的事故が発生していた。10年も経たないうちにその数は2件以下に減少し、その後の半世紀でおおむね10年ごとに半減し続けた。航空が安全になったのは、業界が継続的に反復改善するリスク管理の仕組みを構築したからだ。
測定によって飛行は十分に安全となり、信頼を勝ち取り、大規模な保険引き受けも可能になった。今日では毎年数十億人の乗客が、そして3万機以上の商用機を支える融資機関や保険会社が、飛行を日常的な活動として捉えている。
「自己採点」の時代は終わりを迎えつつある
AIリスク管理には信頼できる測定が不可欠だ。信頼を構築するためには、組織は独立した透明性の高い評価メカニズムを採用する必要がある。製薬会社は自社の臨床試験結果を自ら裁定しないし、上場企業は自社の財務諸表を自ら監査しない。
しかしAI市場では、ベンダーが独自のベンチマークを設定し、自らテストを実施して結果を公表するケースが今なお多い。あるAIコードレビューの事例では、あるベンダーの自社テストでバグ検出率が82%とされた。競合他社が同一のコードベースで再テストしたところ45%という結果が出た。そして利害関係のない独立ラボが独自のベンチマークを構築したところ、いかなるベンダーも63%を超えなかった。製品は変わっていない。変わったのは誰が審判を務めるかだ。
AILuminate:ベンダーが自ら問題を作れない仕組みへ
MLCommonsが提供するAILuminate®は、まさにこのギャップを埋めるために設計されている。2024年12月に公開されたこのプロジェクトは、AIシステムが有害な回答を避ける信頼性を評価するための、独立したコンセンサスに基づくベンチマーク群だ。
AILuminateは、AI企業・学術界・市民社会からのワーキンググループが共同で構築し、非公開のテストセットと独立した評価者によってテストの完全性を保護している。つまりベンダーは自ら問題を作ることも、事前に問題を確認することも、採点権を持つこともできない。
ガバナンスチームはこのスコアをどう活用できるか?
- リスク集中箇所の特定:危害カテゴリー別のモデルスコアにより、類似ユースケースにおけるリスクエクスポージャーの集中箇所を把握でき、リスク台帳の基礎資料となる。
- コントロール措置の指針:敵対的なプレッシャー下でシステムのスコアが著しく低下するなら、それは漠然とした「慎重に」という言葉ではなく、エビデンスに裏付けられた指令だ。システムレベルでガードレールを構築する必要がある。
- 実際の展開構成のテスト:調達側はベンダーと同じテスト手法を用いて、実際に展開している構成を評価すべきだ。基盤モデルのスコアは自動車の燃費ラベルに似ており、出荷時の状態を示すものであって、実際の通勤ルートで得られる燃費ではない。
展開前後のスコアはいずれもリスク台帳に記録されるべきだ。定量化・比較・監査が可能な形で。これらのスコアは外部向けのエビデンスであるだけでなく、継続的な改善や回帰問題の発見のためのフィードバック機構としても機能する。
AIアシュアランスの連鎖の方向性はすでに明確だ。2025年末、主要保険会社は米国の規制当局に対し、企業保険からAI関連責任を除外する許可を求めた。これはAIリスクが管理不可能だからではなく、測定手段が存在しないからだ。測定できないリスクは、保険引き受けも困難となる。
実際に展開するシステムをテストしなければならない
基盤モデルのスコアが証明できるのは、モデルが開発者から引き渡された時点でのパフォーマンスに過ぎず、企業環境での実際の稼働状態を示すものではない。多くの組織は裸のモデルをそのまま展開するのではなく、プロンプト・社内データ・ツール呼び出しと接続し、場合によってはエージェントとして機能させる。このような「ハーネシング」がモデルを有用なものにするが、同時にベンダーが組み込んだ安全対策を脆弱にする可能性もある。
このような保証メカニズムの進化は、Agent Reliability Profileなどの取り組みに見ることができる。このプロジェクトはMLCommonsの金融サービスワーキンググループから生まれ、今年のCDIRハッカソン決勝に選出された。これは個々のエージェント向けの証明文書であり、特定の自律性レベル・特定の運用設計ドメイン・特定のコントロールエンベロープ内でシステムが信頼性を持って動作するという、境界が明確で反証可能な主張を記録するものだ。
これはエージェントが「信頼に値するか」という曖昧な感覚ではなく、監査機関や保険会社が検証できる具体的な主張である。
他のリスクと同様にAIリスクを管理する
MLCommonsの核心的な主張は、AIリスクは特定・価格付け・比例的な管理・報告が可能であり、企業が数十年にわたって信用リスク・為替エクスポージャー・職場安全を管理してきたのと同様だということだ。それはAI導入のブレーキではなく、責任ある形でAIの恩恵を享受するための前提条件だ。
AIリスクはすでに企業の帳簿に載っている。真の問題は、企業がそれを測定し始める意志を持てるかどうかだ。
MLCommonsによると、AILuminateはこの問題の解決を支援し、チームがAIリスクを測定できるよう支援することを目的としている。本稿はより長い白書How to Think About AI Risk: A business owner's guide to a cost you can already measure, price, and manageの概説である。
参考文献
- McKinsey、The State of AI(2025年)およびThe AI reckoning: How boards can evolve(2026年)
- PwC、2026 Annual Corporate Directors Survey
- IBM、Cost of a Data Breach(2025年)
- Center for Democracy & Technology、Getting Third-Party AI Assessment Right(2026年)
- NIST、AI Risk Management Framework
- MLCommons、AILuminate v1.1 and Jailbreak Benchmark v1.0、arXiv:2610.02827(2026年6月)
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接