
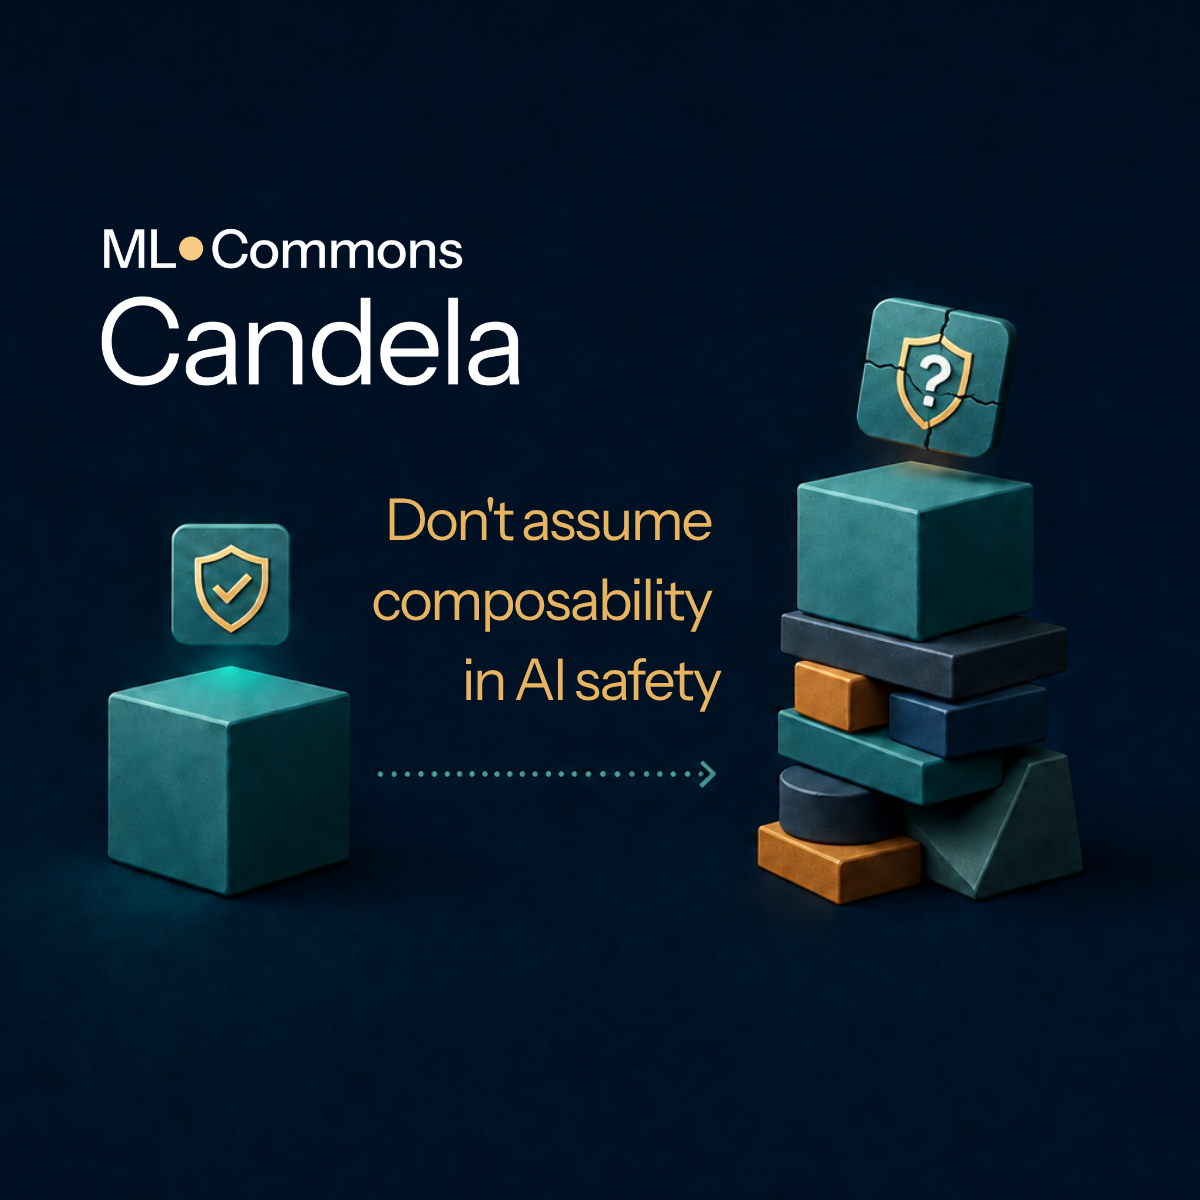
現場の実務者はよく知っているように、デプロイ後のAIシステムの挙動は基盤モデルとは大きく異なる。システムプロンプト、検索レイヤー、微調整などの変更が加わるにつれて、挙動は継続的に変化する。しかし安全性評価では、基盤モデルのシステムカードに記載された安全スコアをそのまま引用するという、組み合わせ可能性(composability)を誤って前提とするケースが多い。
システムの組み合わせ可能性は自明ではない
組み合わせ可能性とは、上流システムの評価結果が下流で構築されたシステムにも適用できるかどうかを指す。従来のソフトウェアではこの前提が一般に成立するが、AI安全の領域では状況はしばしば逆となる。
安全スコアの変化は予測不可能
CDTとMITの研究によると、医療・法律分野に向けて微調整されたモデルの安全スコアは基盤モデルと比較して高くなる場合も低くなる場合もあり、変化の方向や幅を予測できる単一の要因は存在しない。実行時ガード(runtime guardrails)の追加は一般にスコアを向上させるが、具体的な効果は実際のテストによって確認する必要がある。
測定手法も同時に改善が必要
広く使われているベンチマークの多くはノイズが大きく、デプロイ前後のシステムを信頼性高く比較することができない。MLCommonsのCandela(ベンチマーク・アズ・ア・サービス製品)は、プロンプト・ガード・検索・ツールを含む完全なデプロイ済みシステムに対してAILuminateテストを実施し、誤差範囲を提示することができる。
組み合わせ可能性をテスト可能にする
測定の不確実性が明らかになれば、研究者はどの変更が評価結果を維持し、どの変更が結果を損なうかをテストできるようになる。これにより、チームはテストをスキップするか、簡略化するか、あるいは全面的に審査するかを判断しやすくなり、開発者とデプロイ者の責任を区分する規制面での議論も支えることができる。
今すぐ参加を
デプロイチームはCAndelaを用いて今すぐシステムのテストを始めることができる。研究者はAIRR Analyticsワーキンググループに参加し、AI安全における組み合わせ可能性研究の推進に貢献できる。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接