
はじめに
ReflectionのBeamは、501Bパラメータの混合エキスパート(MoE)モデルであり、トークンごとに23Bパラメータをアクティベートする。ソフトウェアエンジニアリングおよび長期エージェントタスク向けに設計されており、SGLangはBeamをネイティブサポートし、本番APIに高性能な推論サービスを提供している。
主なハイライト
- Beam 1.0 501B-A23B:スライディングウィンドウとフルアテンションを組み合わせたデコーダーオンリーMoEで、256個のルーティングエキスパートからtop-8を選択し、1Mトークンのコンテキストをネイティブサポート。
- チェックポイントサポート:BF16、ModelOpt NVFP4、およびcompressed-tensors動的FP8に対応。
- サービス機能:DFlash2推測デコード、radixキャッシュとHiCache、チャンクプリフィル、CUDAグラフ、TP/EP/PPおよびアテンションデータ並列処理。
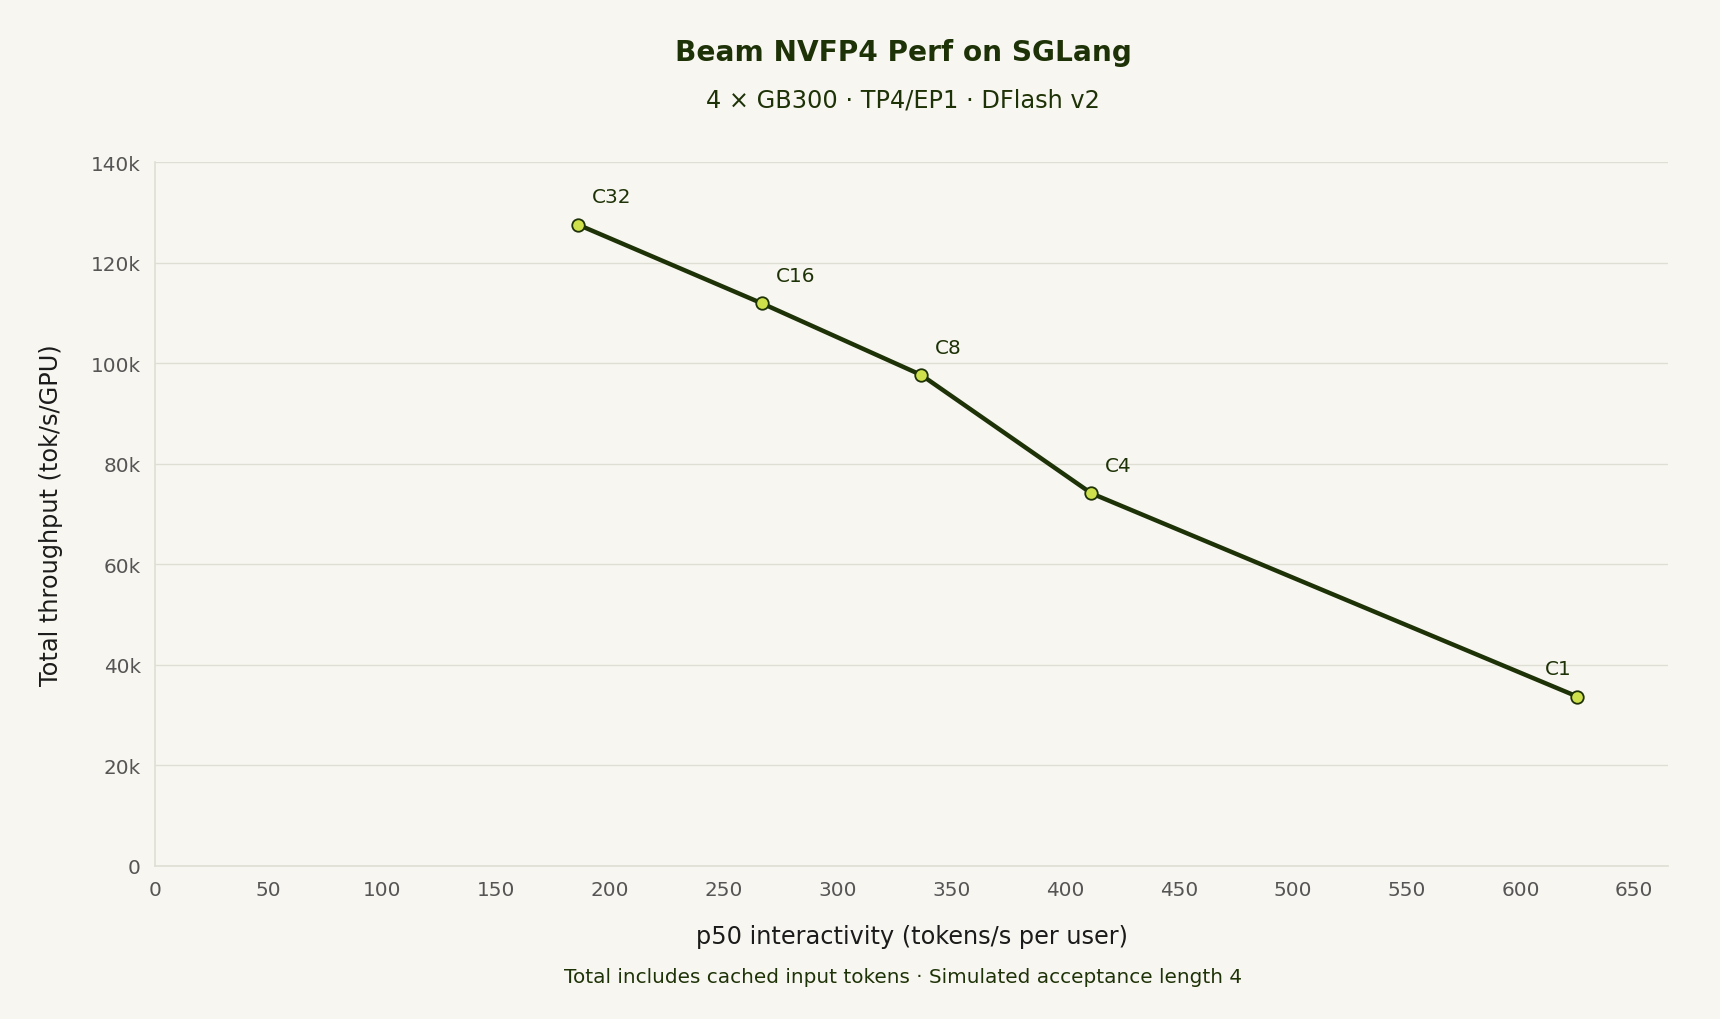
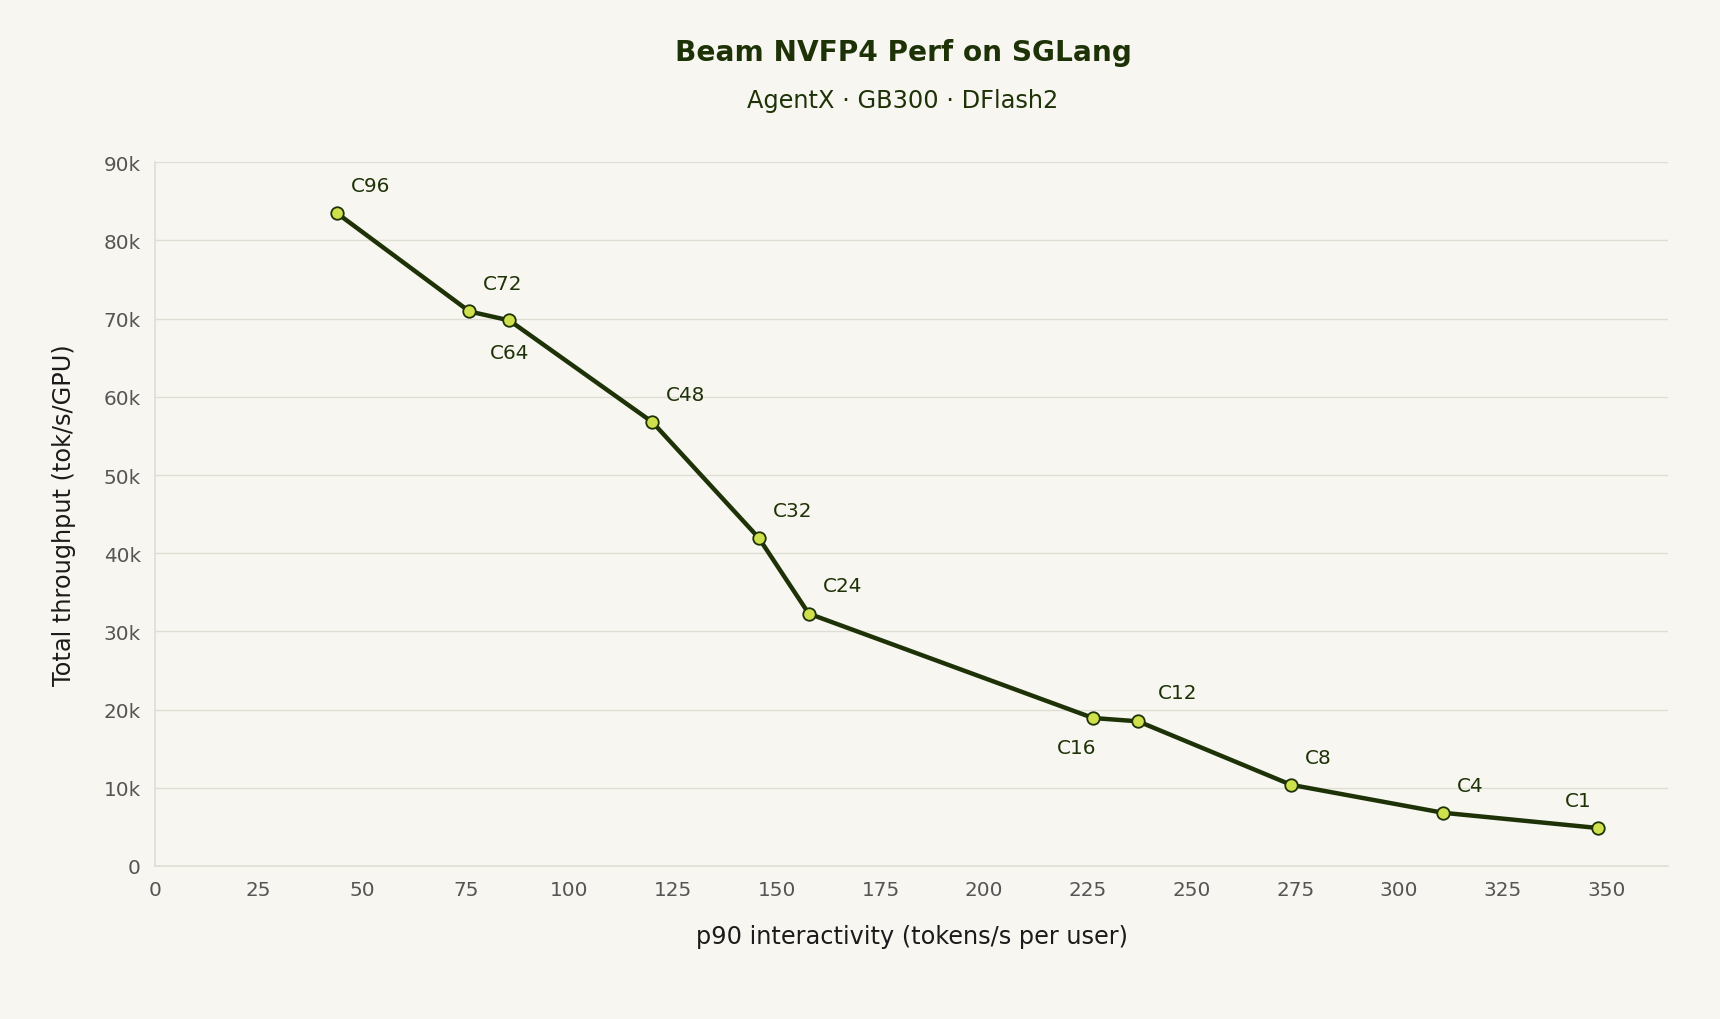
- 性能:4台のNVIDIA GB300 GPU上でNVFP4チェックポイントを実行し、OpenHandsマルチターンエージェントコーディング再生タスクにおいて、SGLangはGPUあたり127.6Kトークン/秒の総スループットを達成し、p50インタラクティビティは185.87トークン/秒(並列数32)。
モデルアーキテクチャ
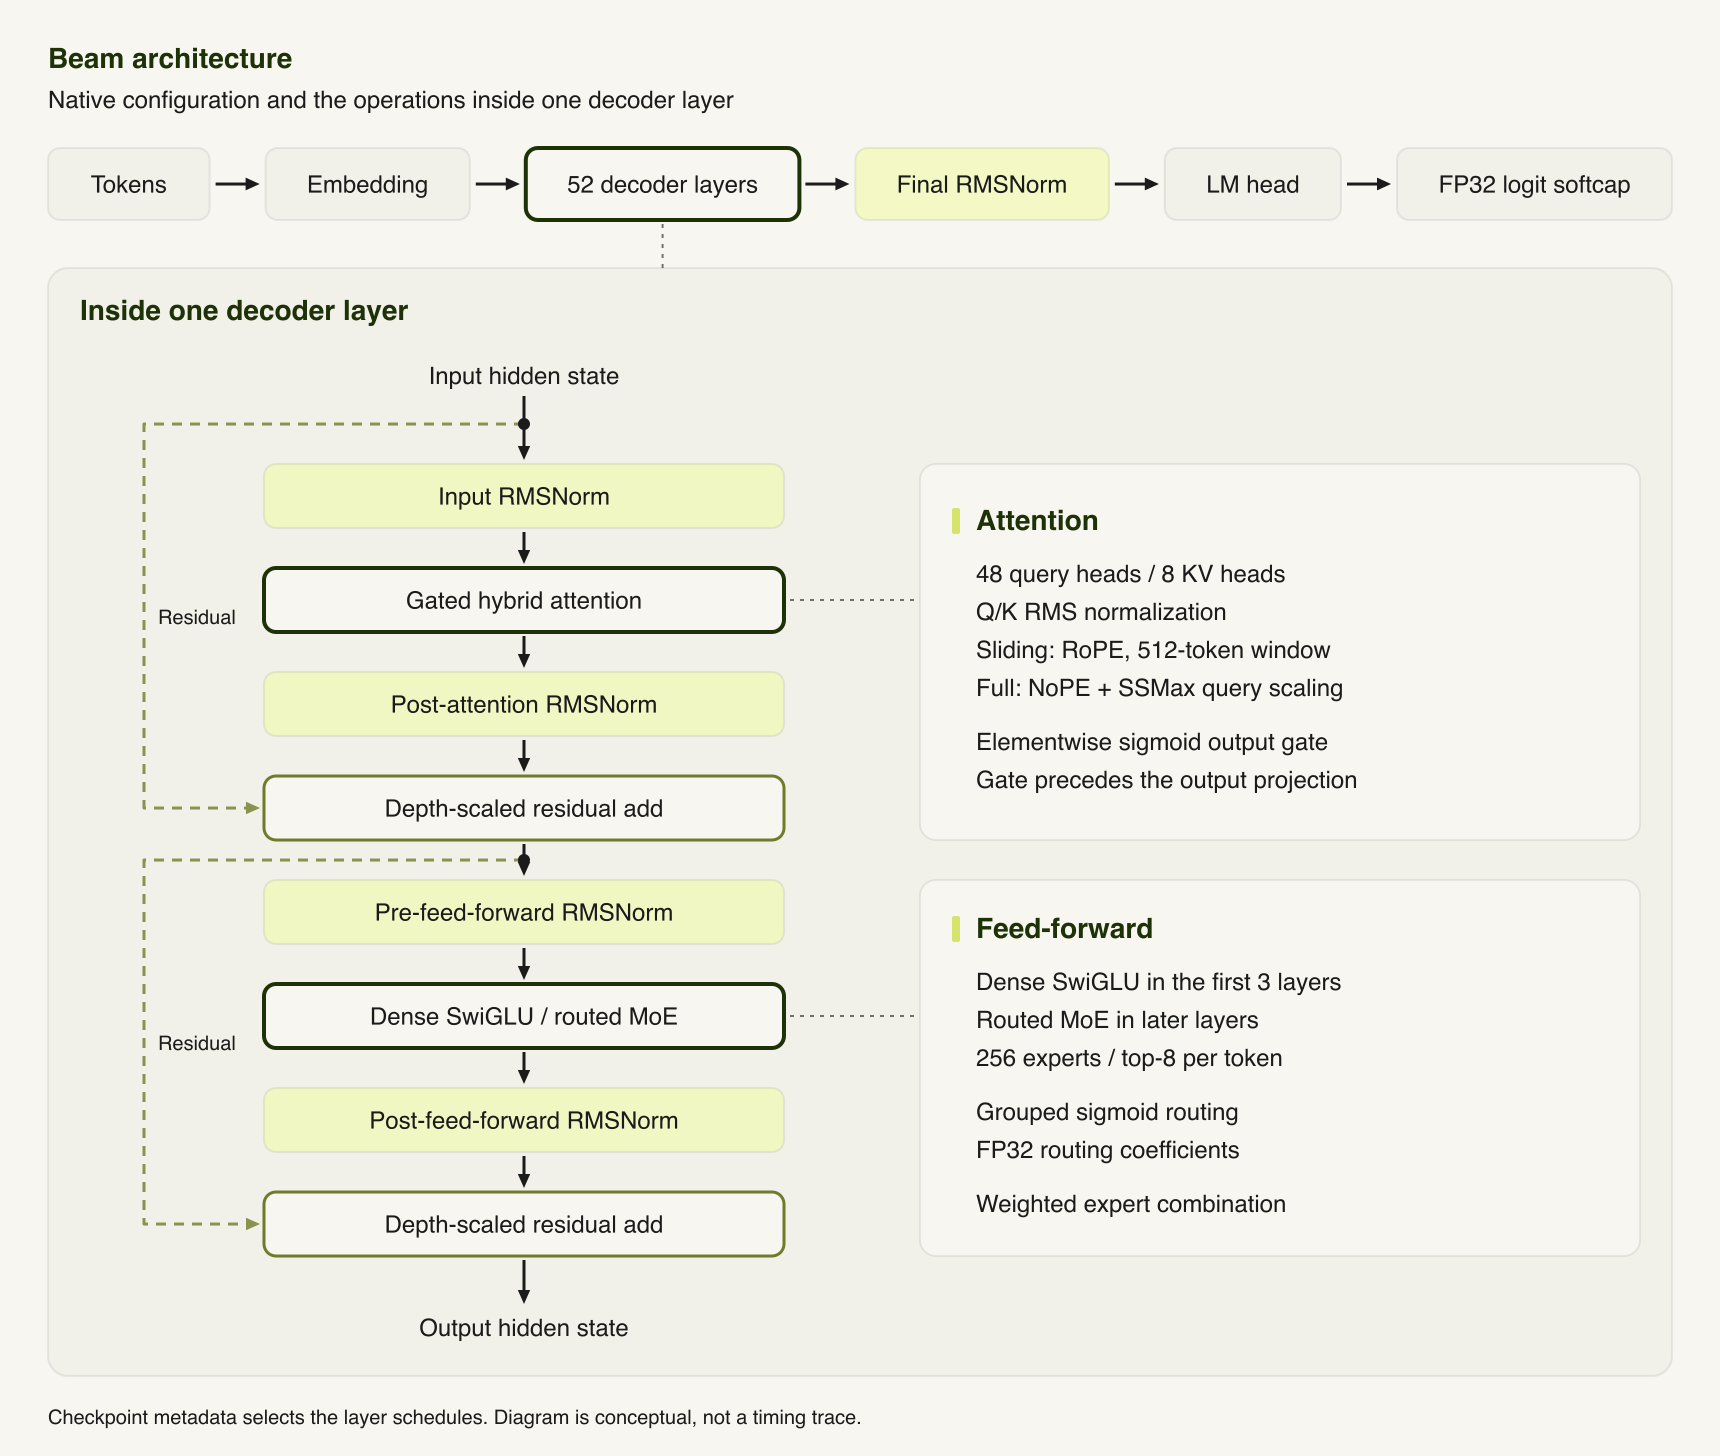
Beamはグループクエリアテンション(GQA)とスライディングウィンドウ/フルアテンション混合レイヤーを組み合わせている。フィードフォワードネットワークはまず密なSwiGLUレイヤーを使用し、その後ルーティングMoEへ切り替わる。アテンション出力はゲーティング後に再投影され、サンドイッチ正規化と深さスケーリング残差接続を採用している。
混合アテンションと出力ゲーティング
48個のクエリヘッドが8個のKVヘッドを共有することで、KVキャッシュの使用量を大幅に削減している。スライディングウィンドウレイヤーは履歴長を制限し、フルアテンションレイヤーはSSMaxスケーリングを使用して長いコンテキストにおけるアテンションの集中を維持する。
密レイヤーとグループMoEルーティング
最初の3層は密なSwiGLUであり、後続のレイヤーでは256個のエキスパートから8個を選択する。ルーターはFP32でlogitsを計算し、エキスパート修正バイアスを使用する。
機能サポート
DFlash2推測デコードとアテンションデータ並列処理
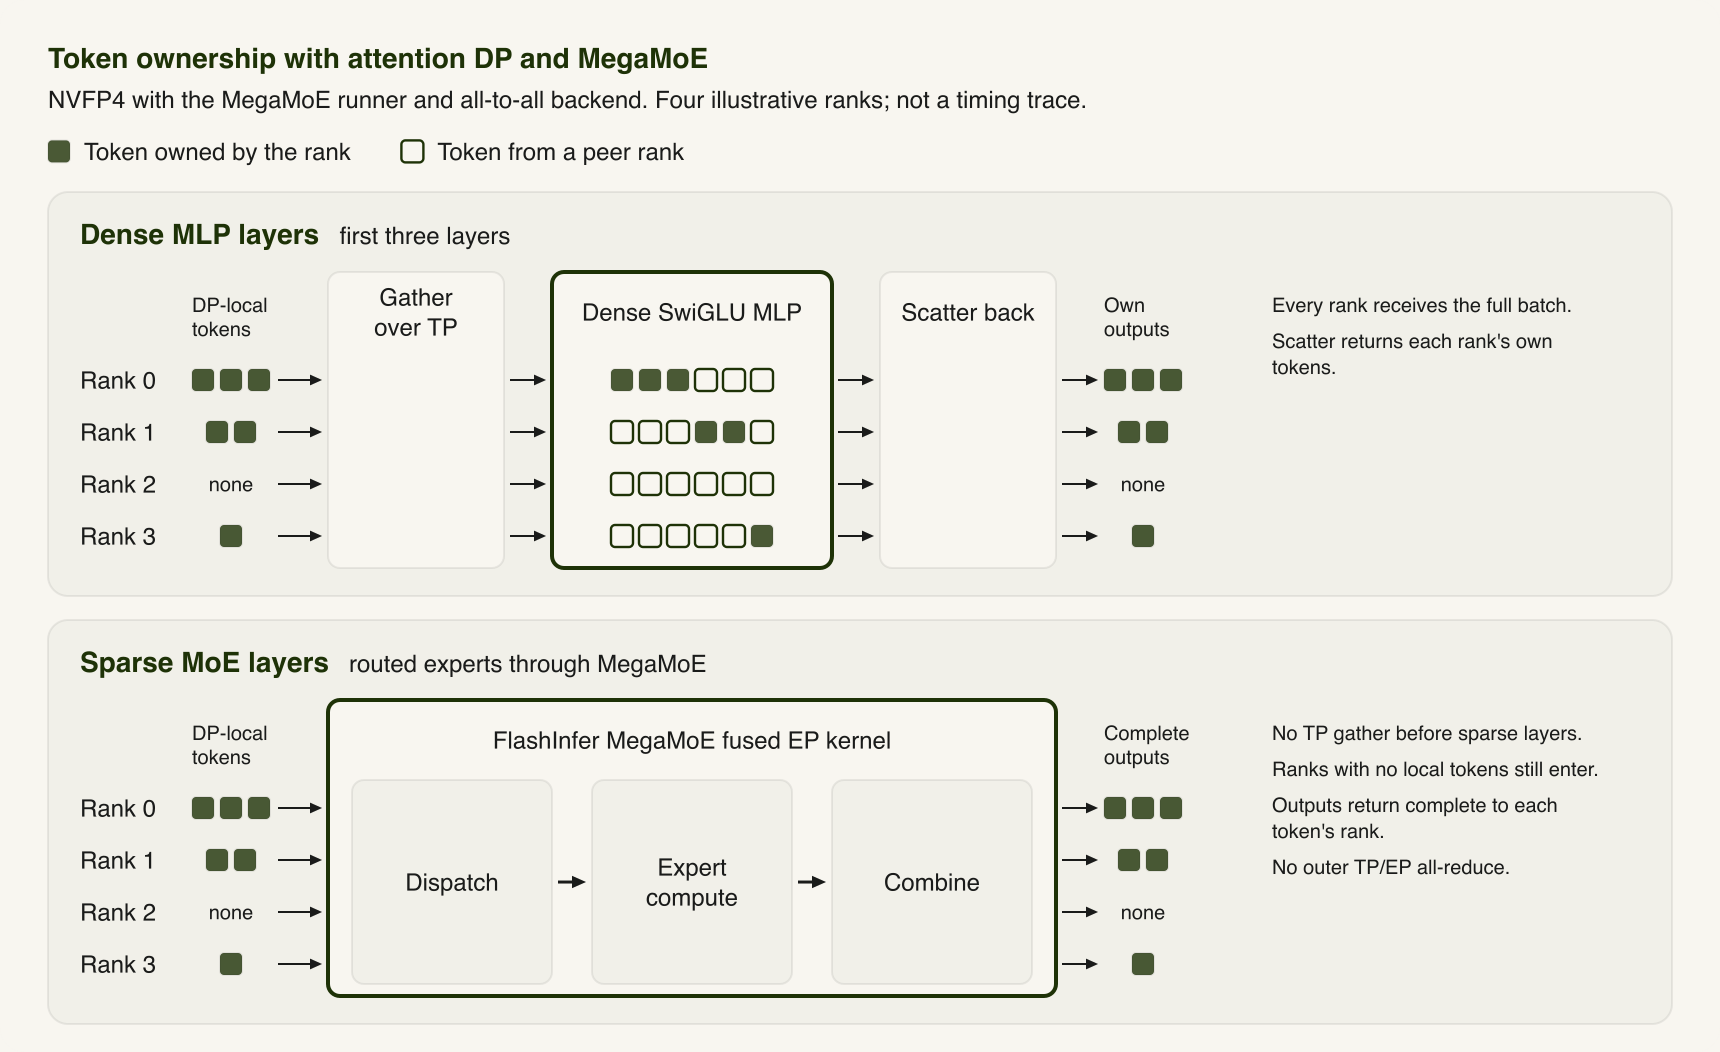
SGLangはDFLASHランタイムを通じてDFlash2をサポートし、アテンションデータ並列処理と組み合わせて効率的な検証を実現する。統合KVメモリプールにより、ターゲットとドラフトのKVキャッシュを同時に管理する。
プリフィル/デコード分離のための異種TP
NIXLとMooncakeを通じて、プリフィルとデコードフェーズで異なるTPサイズを実現し、フルアテンションおよびスライディングウィンドウのKV状態を完全に保持する。
推論・ツール呼び出し・LoRA
SGLangはBeamチェックポイントの応答テンプレートを自動解析し、ストリーミングおよび非ストリーミングリクエストにおける推論・回答・ツール呼び出しの分離をサポートするとともに、BF16 LoRAとも互換性がある。
マルチ精度モデルサポート
ネイティブBF16、動的FP8、およびNVFP4チェックポイントを完全サポートし、FlashInfer MegaMoEによるエキスパート並列高速化パスを提供する。
性能評価
GB300プラットフォーム上において、NVFP4版BeamはOpenHandsおよびAgentXタスクで優れたスループットとインタラクティビティのバランスを発揮した。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接