
ハイライト概要
Muse Spark Openは、オープンウェイトのマルチモーダル混合専門家(MoE)モデルであり、816BパラメータのテキストTransformerバックボーンを採用している。1トークンあたりの活性化パラメータは約42Bで、テキスト・画像・動画・音声の入力に対応し、コンテキストウィンドウは1Mトークンに達する。チェックポイントはNVFP4版とBF16版が提供されている。
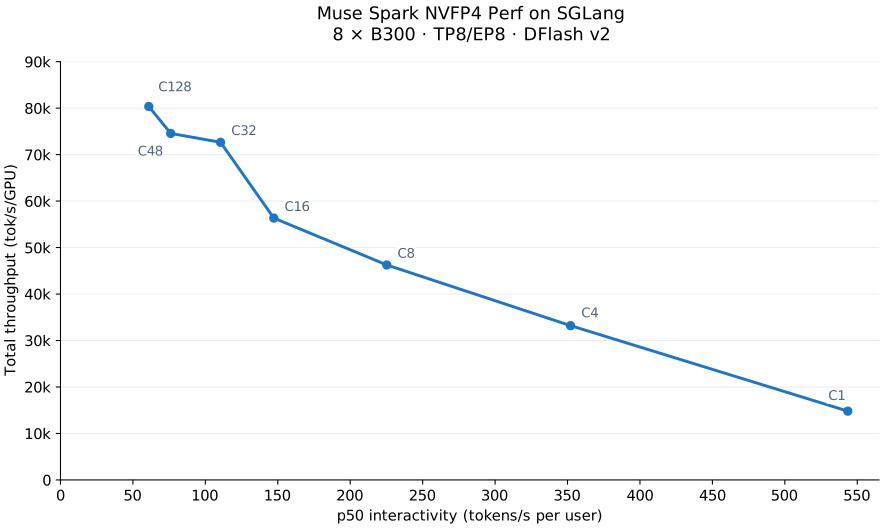
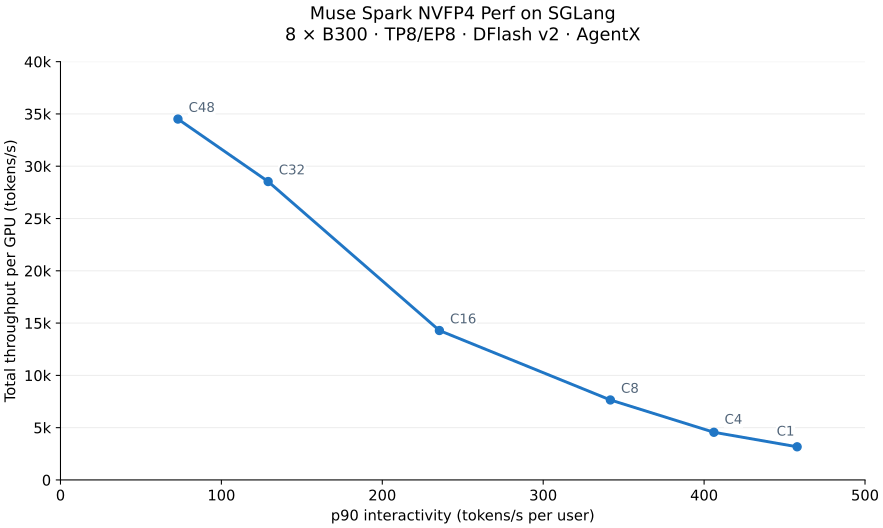
8枚のNVIDIA B300 GPU上でNVFP4チェックポイントを実行した場合、SGLangはGPUあたり14.8K総トークン/秒(同時接続数1、p50: 543トークン/秒/ユーザー)および80.3K総トークン/秒(同時接続数128、p50: 61トークン/秒/ユーザー)のパフォーマンスを達成する。
Muse Spark Openのアーキテクチャ
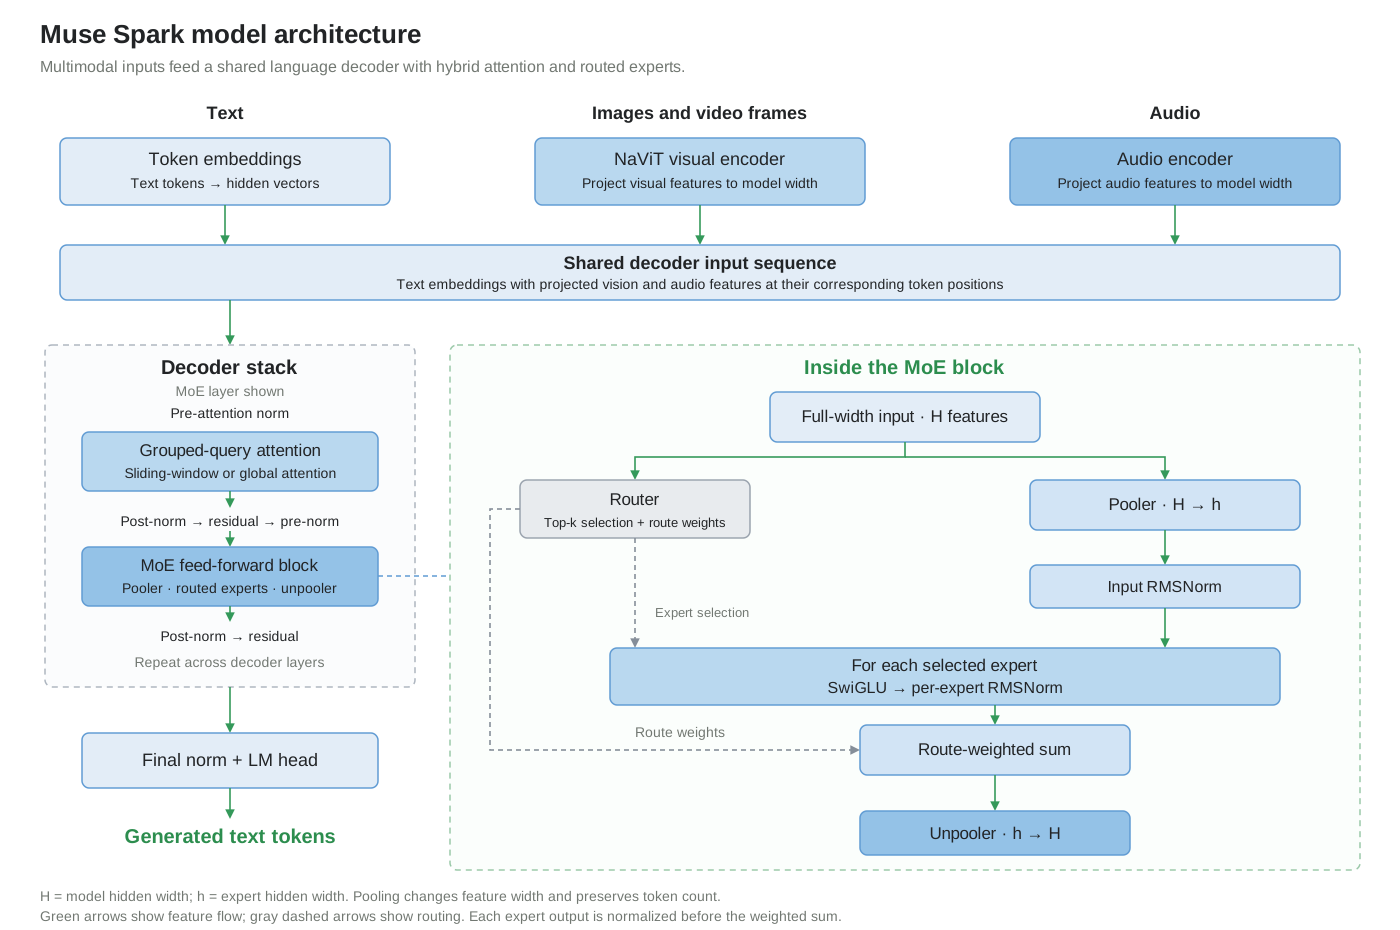
Muse Spark Openは、スパース言語デコーダーに視覚エンコーダーと音声エンコーダーを組み合わせ、マルチモーダル入力を統一して共有トークン生成パイプラインに送り込む。
GQAとスライディングウィンドウアテンション
1Mトークンのコンテキストをサポートするため、モデルはグループクエリアテンション(GQA)と、スライディングウィンドウアテンおよびグローバルアテンションを組み合わせたハイブリッド機構を採用している。
テキスト・音声・画像・動画の処理
画像と動画フレームはNaViT視覚エンコーダーを共有し、波形音声は専用の音声エンコーダーで処理され、出力はデコーダーの隠れ次元に投影される。
Pooler/UnpoolerおよびPer-Expert正規化を備えたMoE
MoEモジュールはpoolerとunpoolerによる投影を使用し、各専門家の出力にper-expert RMSNormを適用する。
ランタイム最適化
シーケンス並列化
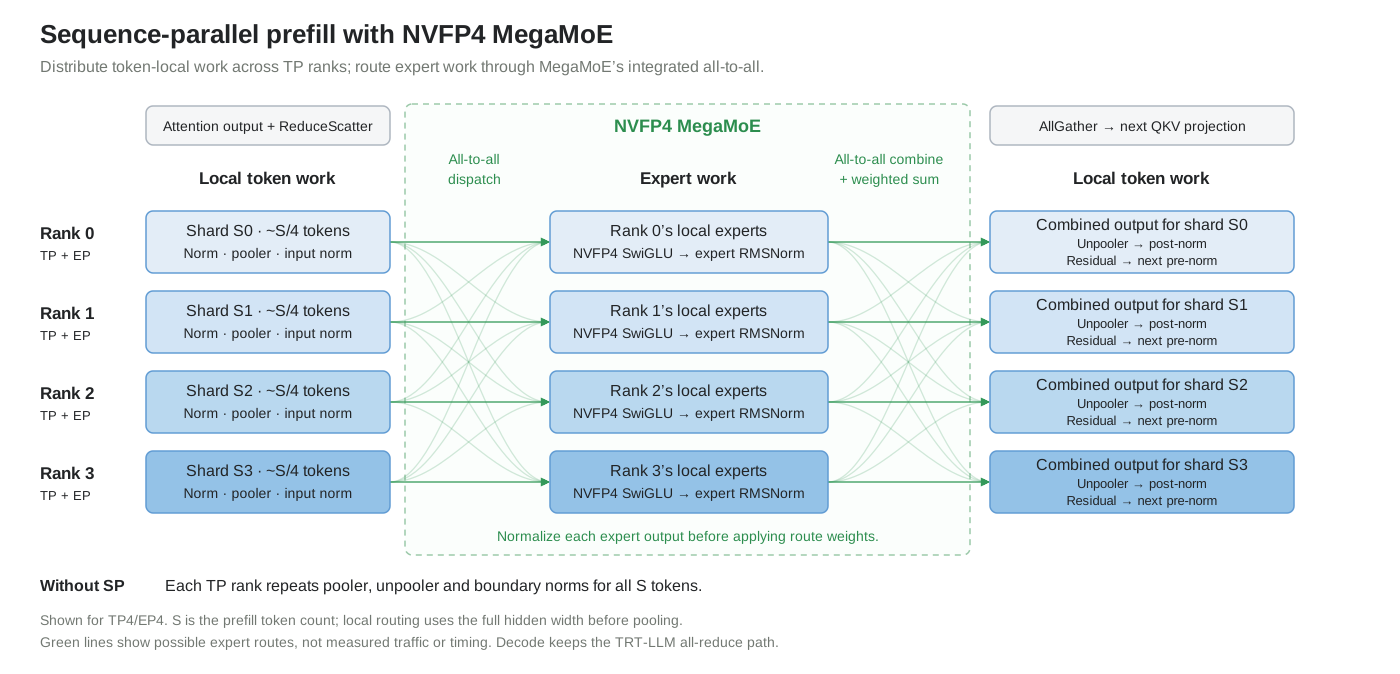
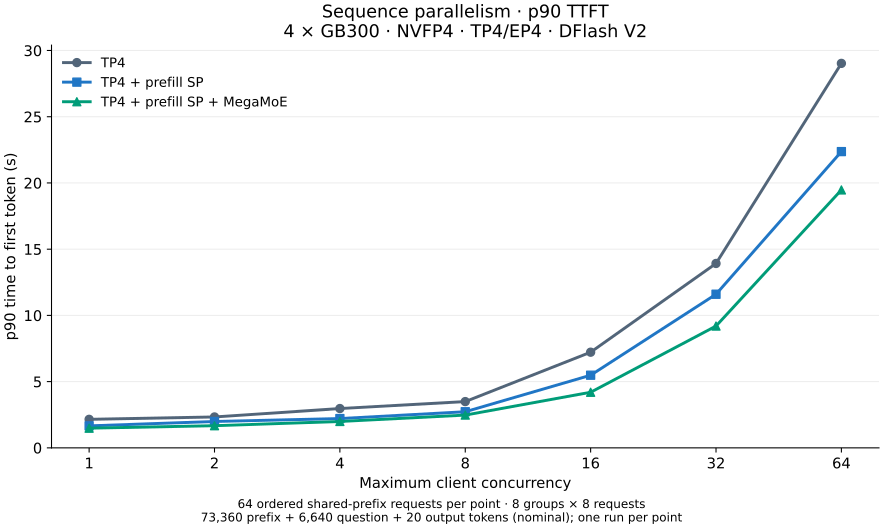
シーケンス並列化(SP)は、活性化をトークン次元に沿って分割し、NVFP4 MegaMoEと組み合わせることでプリフィルを高速化する。4枚のGB300 GPU上のテストでは、SP + MegaMoEによりp90 TTFTが28.3〜41.9%低減されることが示された。
マルチモーダル最適化
CPUサイドのRust/Pillowによる画像前処理およびSGLang最適化済みアテンションバックエンドをサポートし、EPD分離にも対応している。
DFlash V2投機的デコーディング
DFlash V2による動的畳み込みおよび候補選択を通じて、ブロック検証をサポートする。
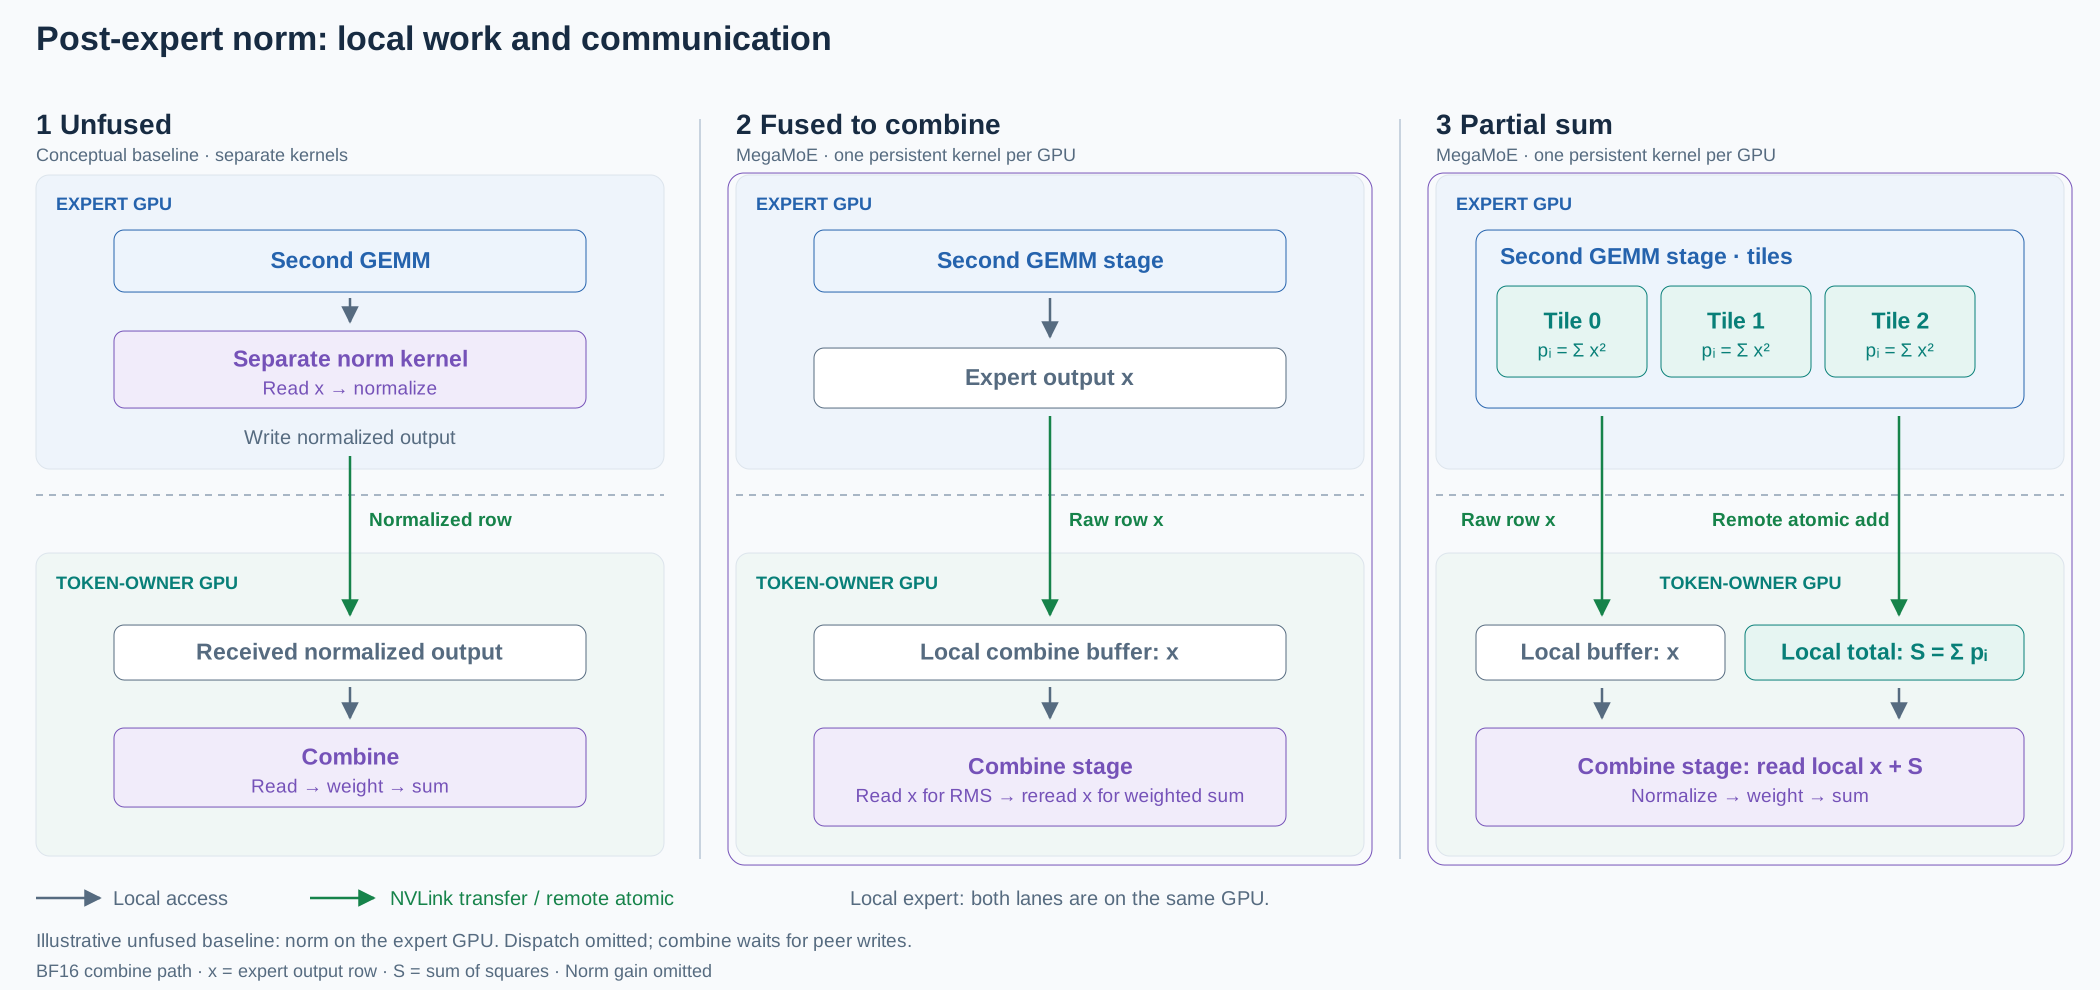
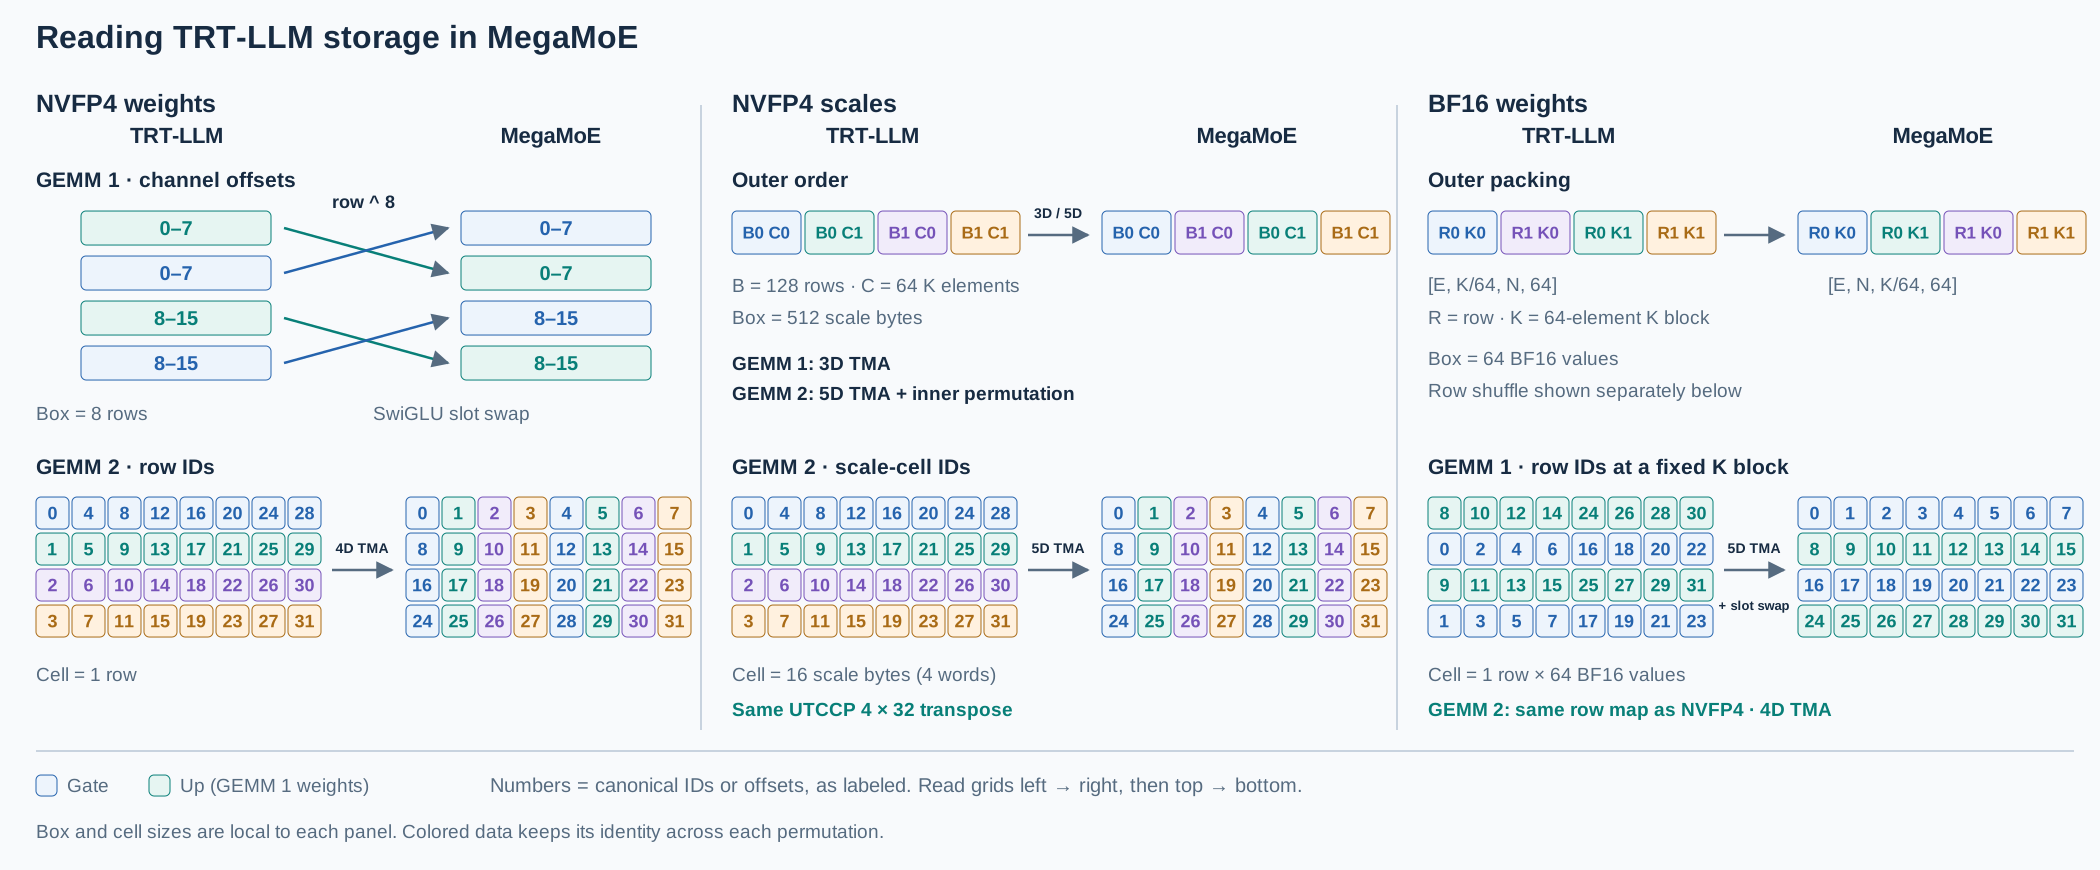
カーネル最適化とパフォーマンス
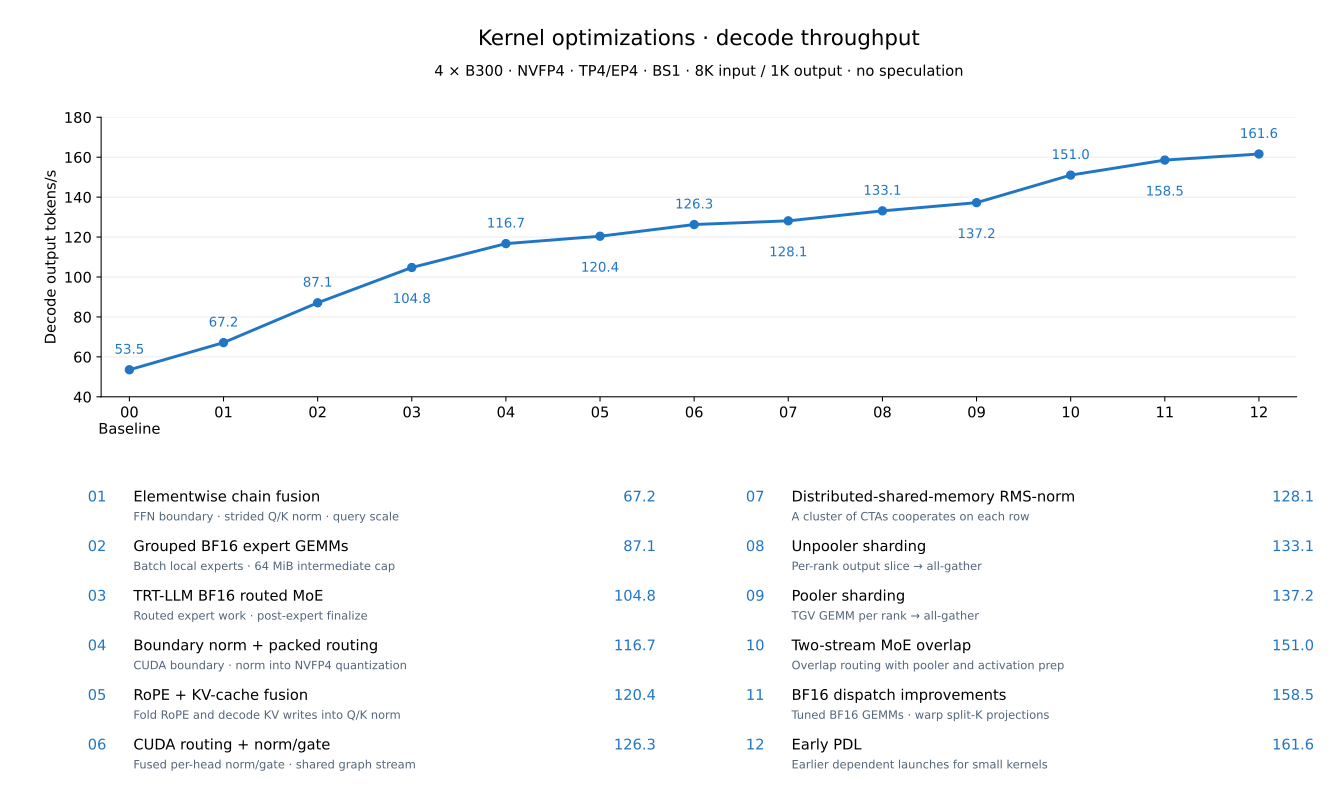
カーネル起動回数の削減、メモリトラフィックの最適化、および計算のオーバーラップにより、スループットを大幅に向上させている。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接