
SGLangの低レイテンシモードは、特定のモデル、ハードウェア、ワークロード向けに設計されており、プラグインフレームワークを通じて専用カーネルを導入することでコードの重複を避け、レイテンシを大幅に低減する。
低レイテンシ推論カーネル
NVIDIA 低レイテンシカーネル
NVIDIA GPU上では、プラグインが依存カーネルと通信のオーバーラップ、小バッチ向けのアテンション・MoE・ドラフトサンプリングの最適化を通じて、レイテンシを大幅に低減する。関連カーネルはsgl-nvidia-megaリポジトリに格納されている。
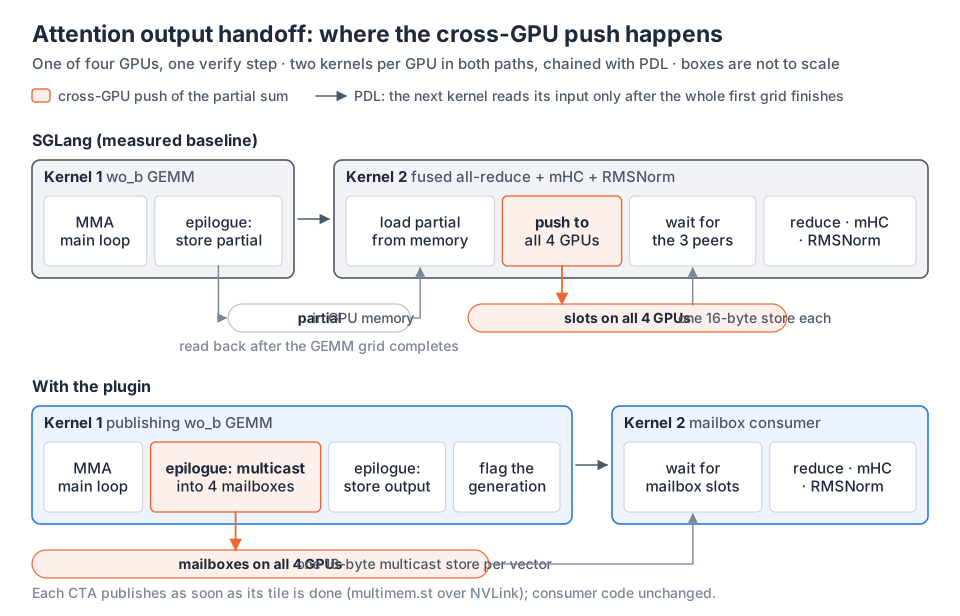
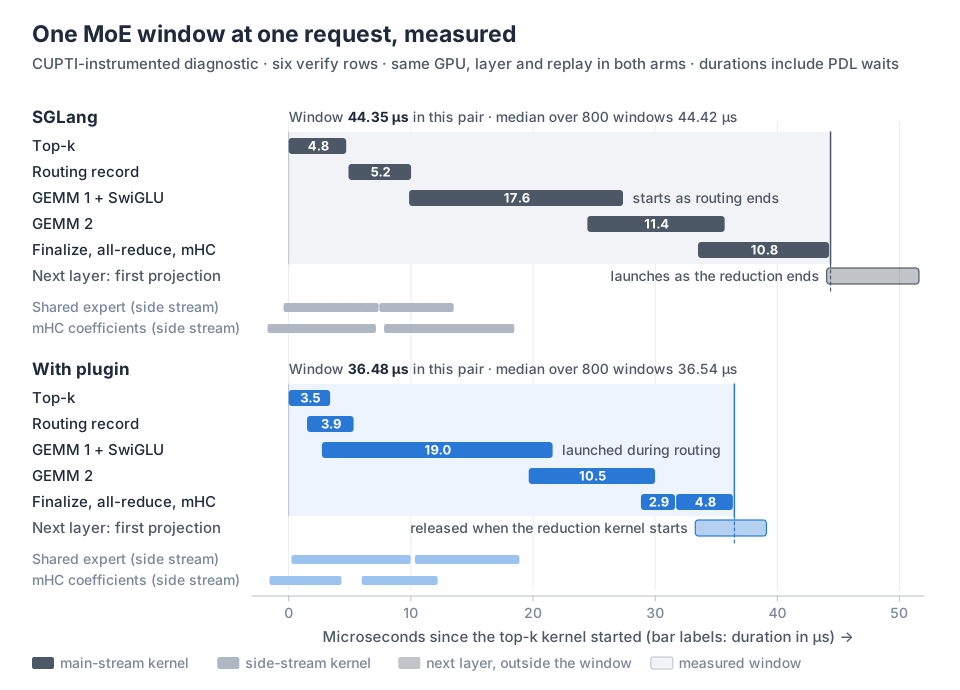
単一リクエストのシナリオでは、DSparkが各ステップで6つのトークン行を検証する。プラグインにより、デコーダー層の中央値レイテンシが96.8 µsから68.4 µsに低下した。これは主に次のカーネルの早期起動とGPU間通信のオーバーラップによって実現されている。
低レイテンシ専用最適化
1. PDLを使用して入力準備前に次のカーネルを起動する;2. プロジェクション出力をGEMMのエピローグから直接NVLinkへ送出する;3. ルーティング完了前にエキスパートGEMMを起動する;4. ドラフトサンプリングを単一カーネルに統合する。
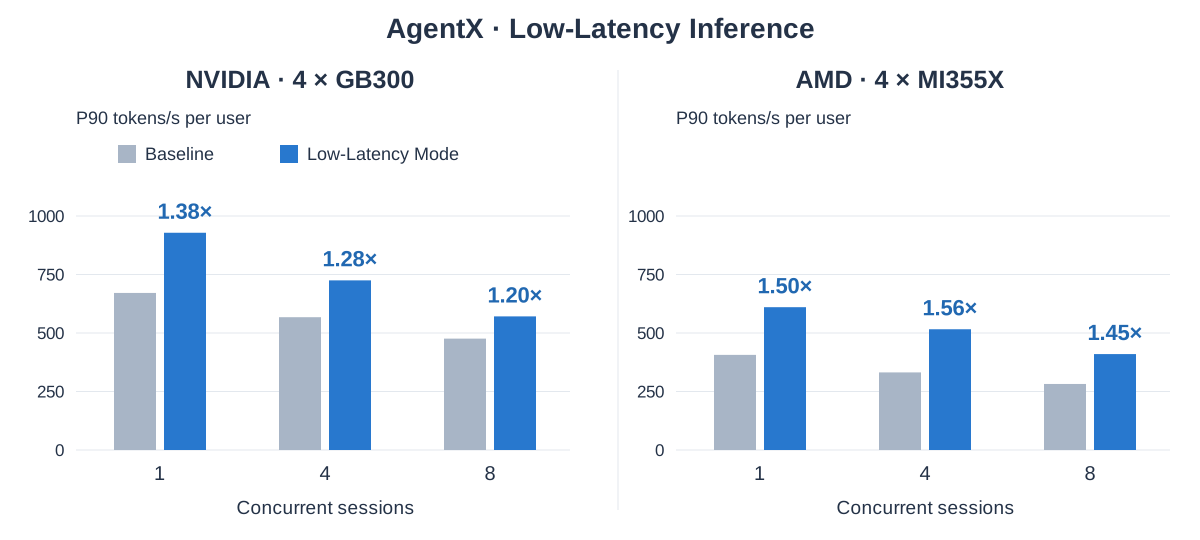
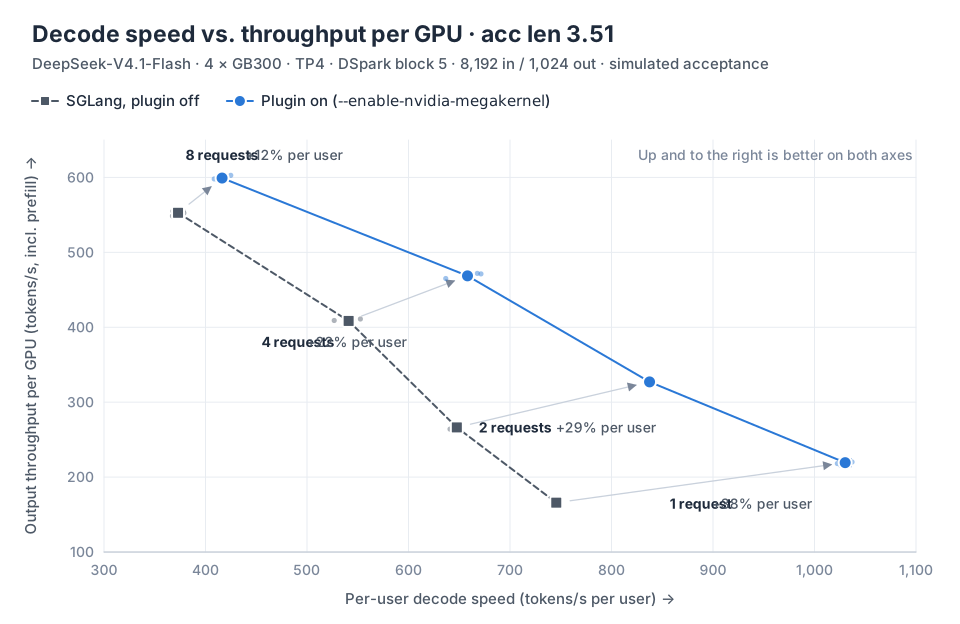
サービス結果によると、8K入力/1K出力のワークロードにおいて、4枚のGB300 GPU上でユーザーあたりのデコード速度が12〜38%向上した。
AMD 低レイテンシカーネル
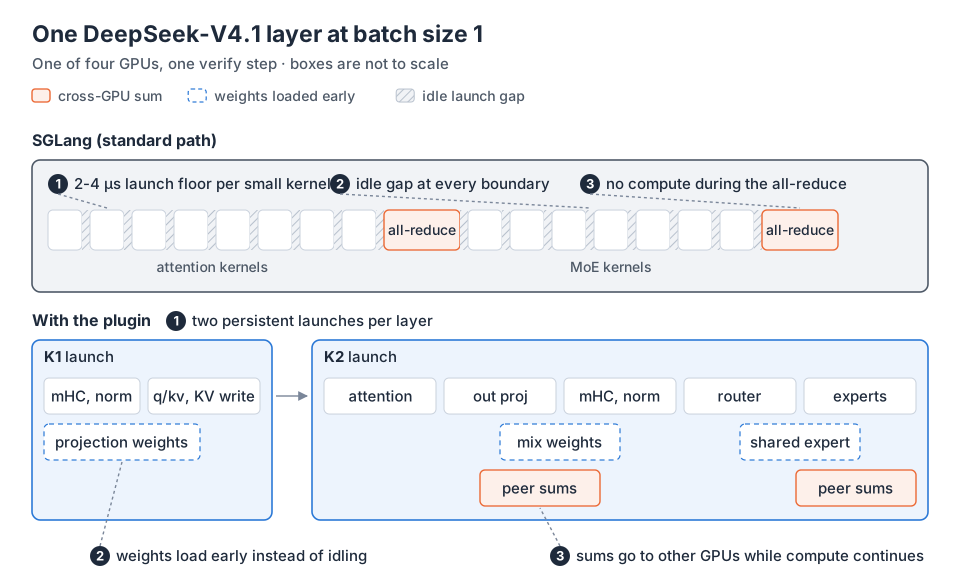
AMDのアプローチでは、デコーダー層の演算と通信を少数の永続カーネルに統合しており、sgl-amd-monoリポジトリに格納されている。標準パスでは数十の小カーネル、起動オーバーヘッド、および2回のAll-Reduceによる停止が発生するが、プラグインはこれを2つのFlyDSL起動に置き換え、重みを早期にロードしつつ演算中に通信をオーバーラップさせる。
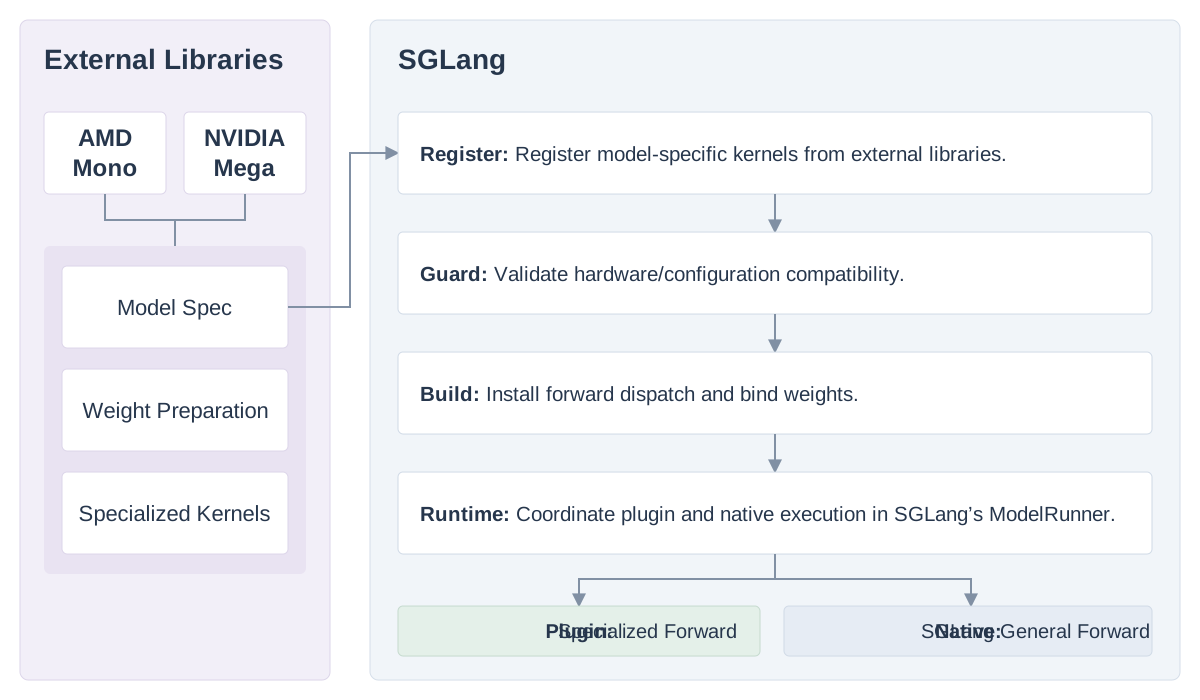
プラグインシステムの設計と統合
外部カーネルライブラリがSGLangにモデル仕様を登録し、システムが設定を検証してプラグインをビルドし、サポート対象のステップにディスパッチする。
今後の計画
チームは引き続き対応モデルとハードウェアの拡充を進めるとともに、高並列シナリオにおける性能の最適化にも取り組む予定だ。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接