
MLPerf Inferenceの各ラウンドの結果は、業界のエンジニアリング投資をリアルタイムで映し出すスナップショットである。v6.1は2つの点で特に際立っている。提出者数が過去最高を更新したこと、そして業界がエージェント型・エンドツーエンドベンチマークへの移行を明確に進めており、多数の新型ハードウェアが登場していることだ。
提出者と提出規模
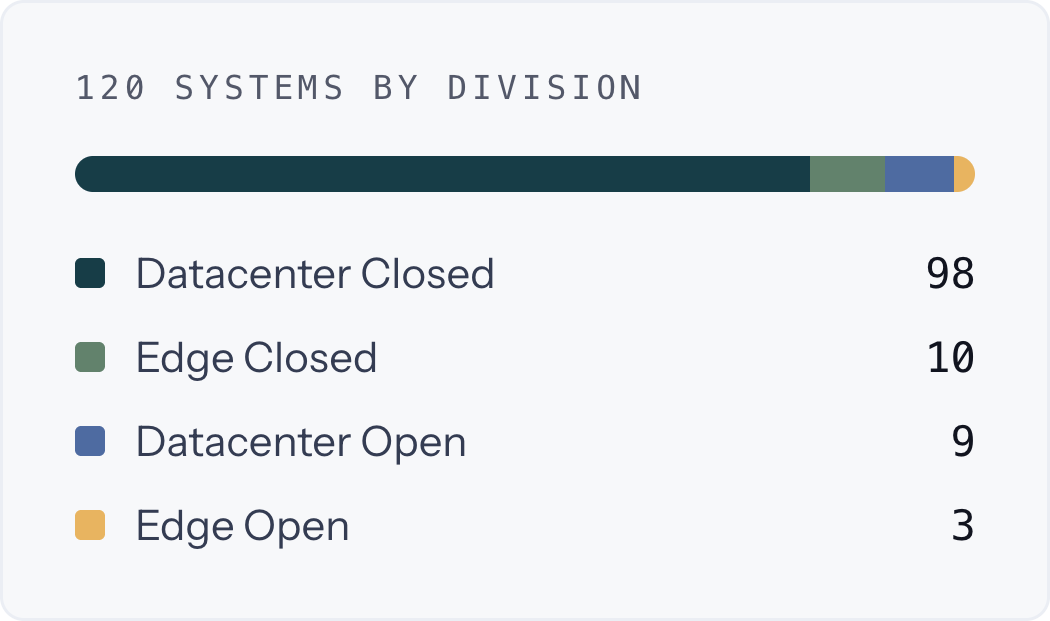
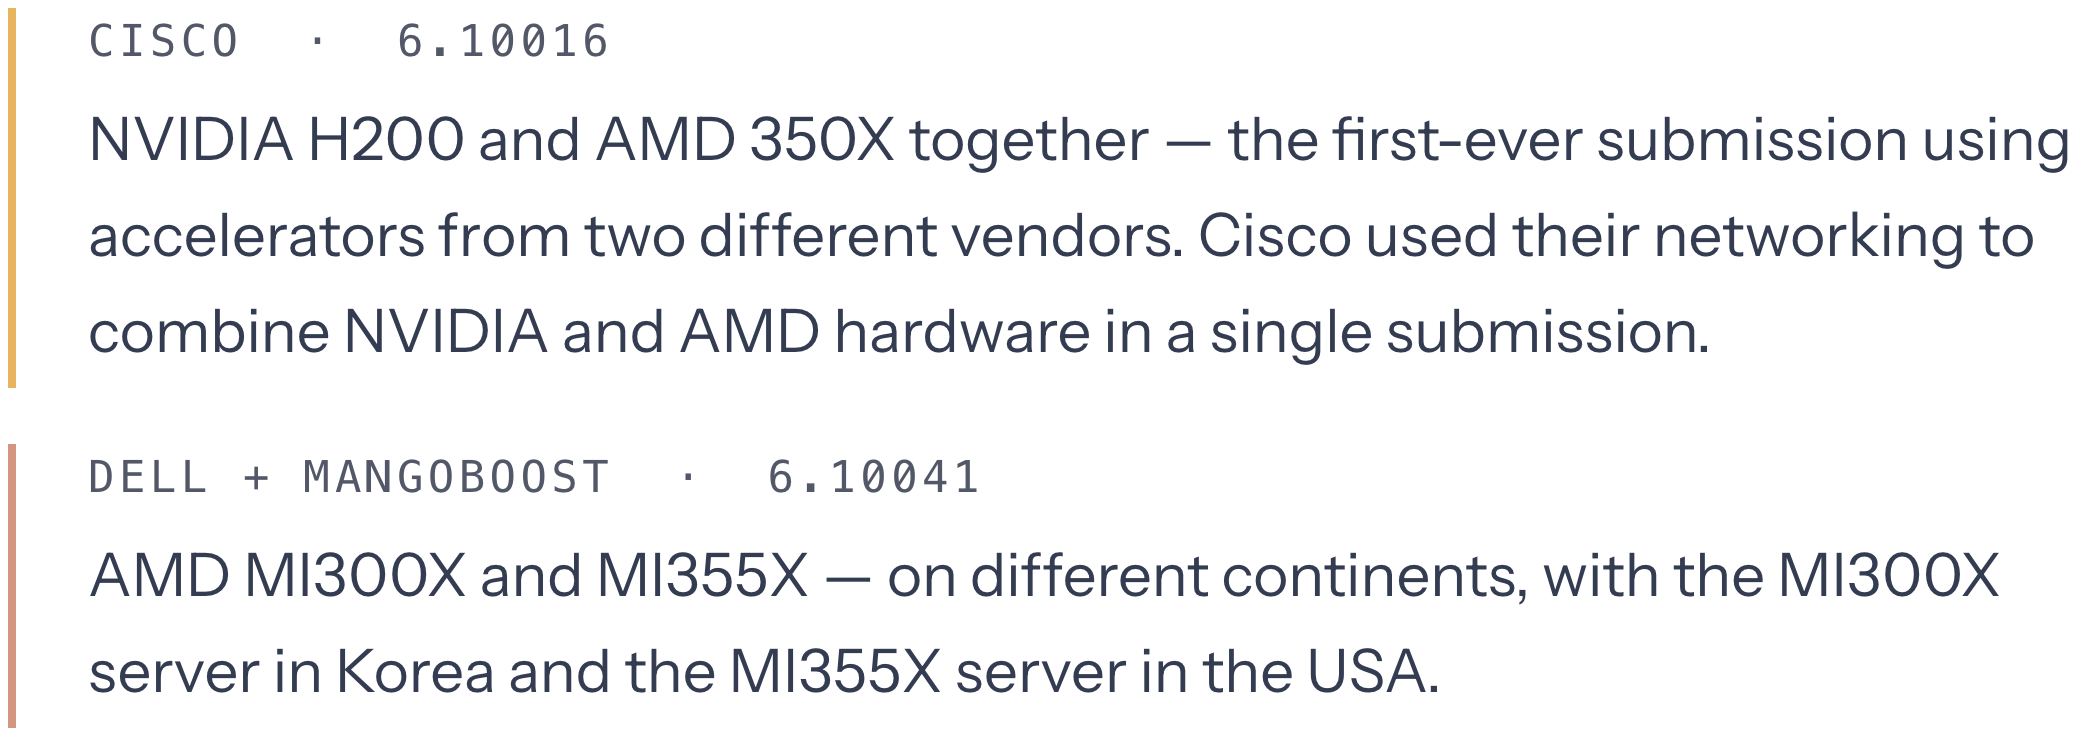
今ラウンドには30社が参加し、シリコンベンダー、OEM/ODMシステムベンダー、クラウドおよび新興クラウドサービスプロバイダー、専門推論ソフトウェア企業が含まれる。一部の結果はDell_AMD、Dell_MangoBoost、RedHat_Intel、RedHat_Supermicroなどの共同提出となっている。合計120システムが提出され、DatacenterおよびEdgeスイート、ならびにClosedとOpenの2つのトラックをカバーしている。
ベンチマーク概要
MLPerf Inference v6.1にはDatacenterベンチマーク10件とEdgeベンチマーク6件が含まれており、End-to-End RAGとAgentic Edge Inferenceが新たに追加された。VLMにはInteractiveシナリオが新設され、GPT-OSS-120BのInteractiveシナリオでは投機的デコードがサポートされている。Datacenterで最も人気のあるベンチマークはgpt-oss-120bに変わり、複数ラウンドにわたってリードしていたLlama2-70bに取って代わった。これはコミュニティにおけるMoEモデルの受容度が著しく向上していることを示している。
性能向上分析
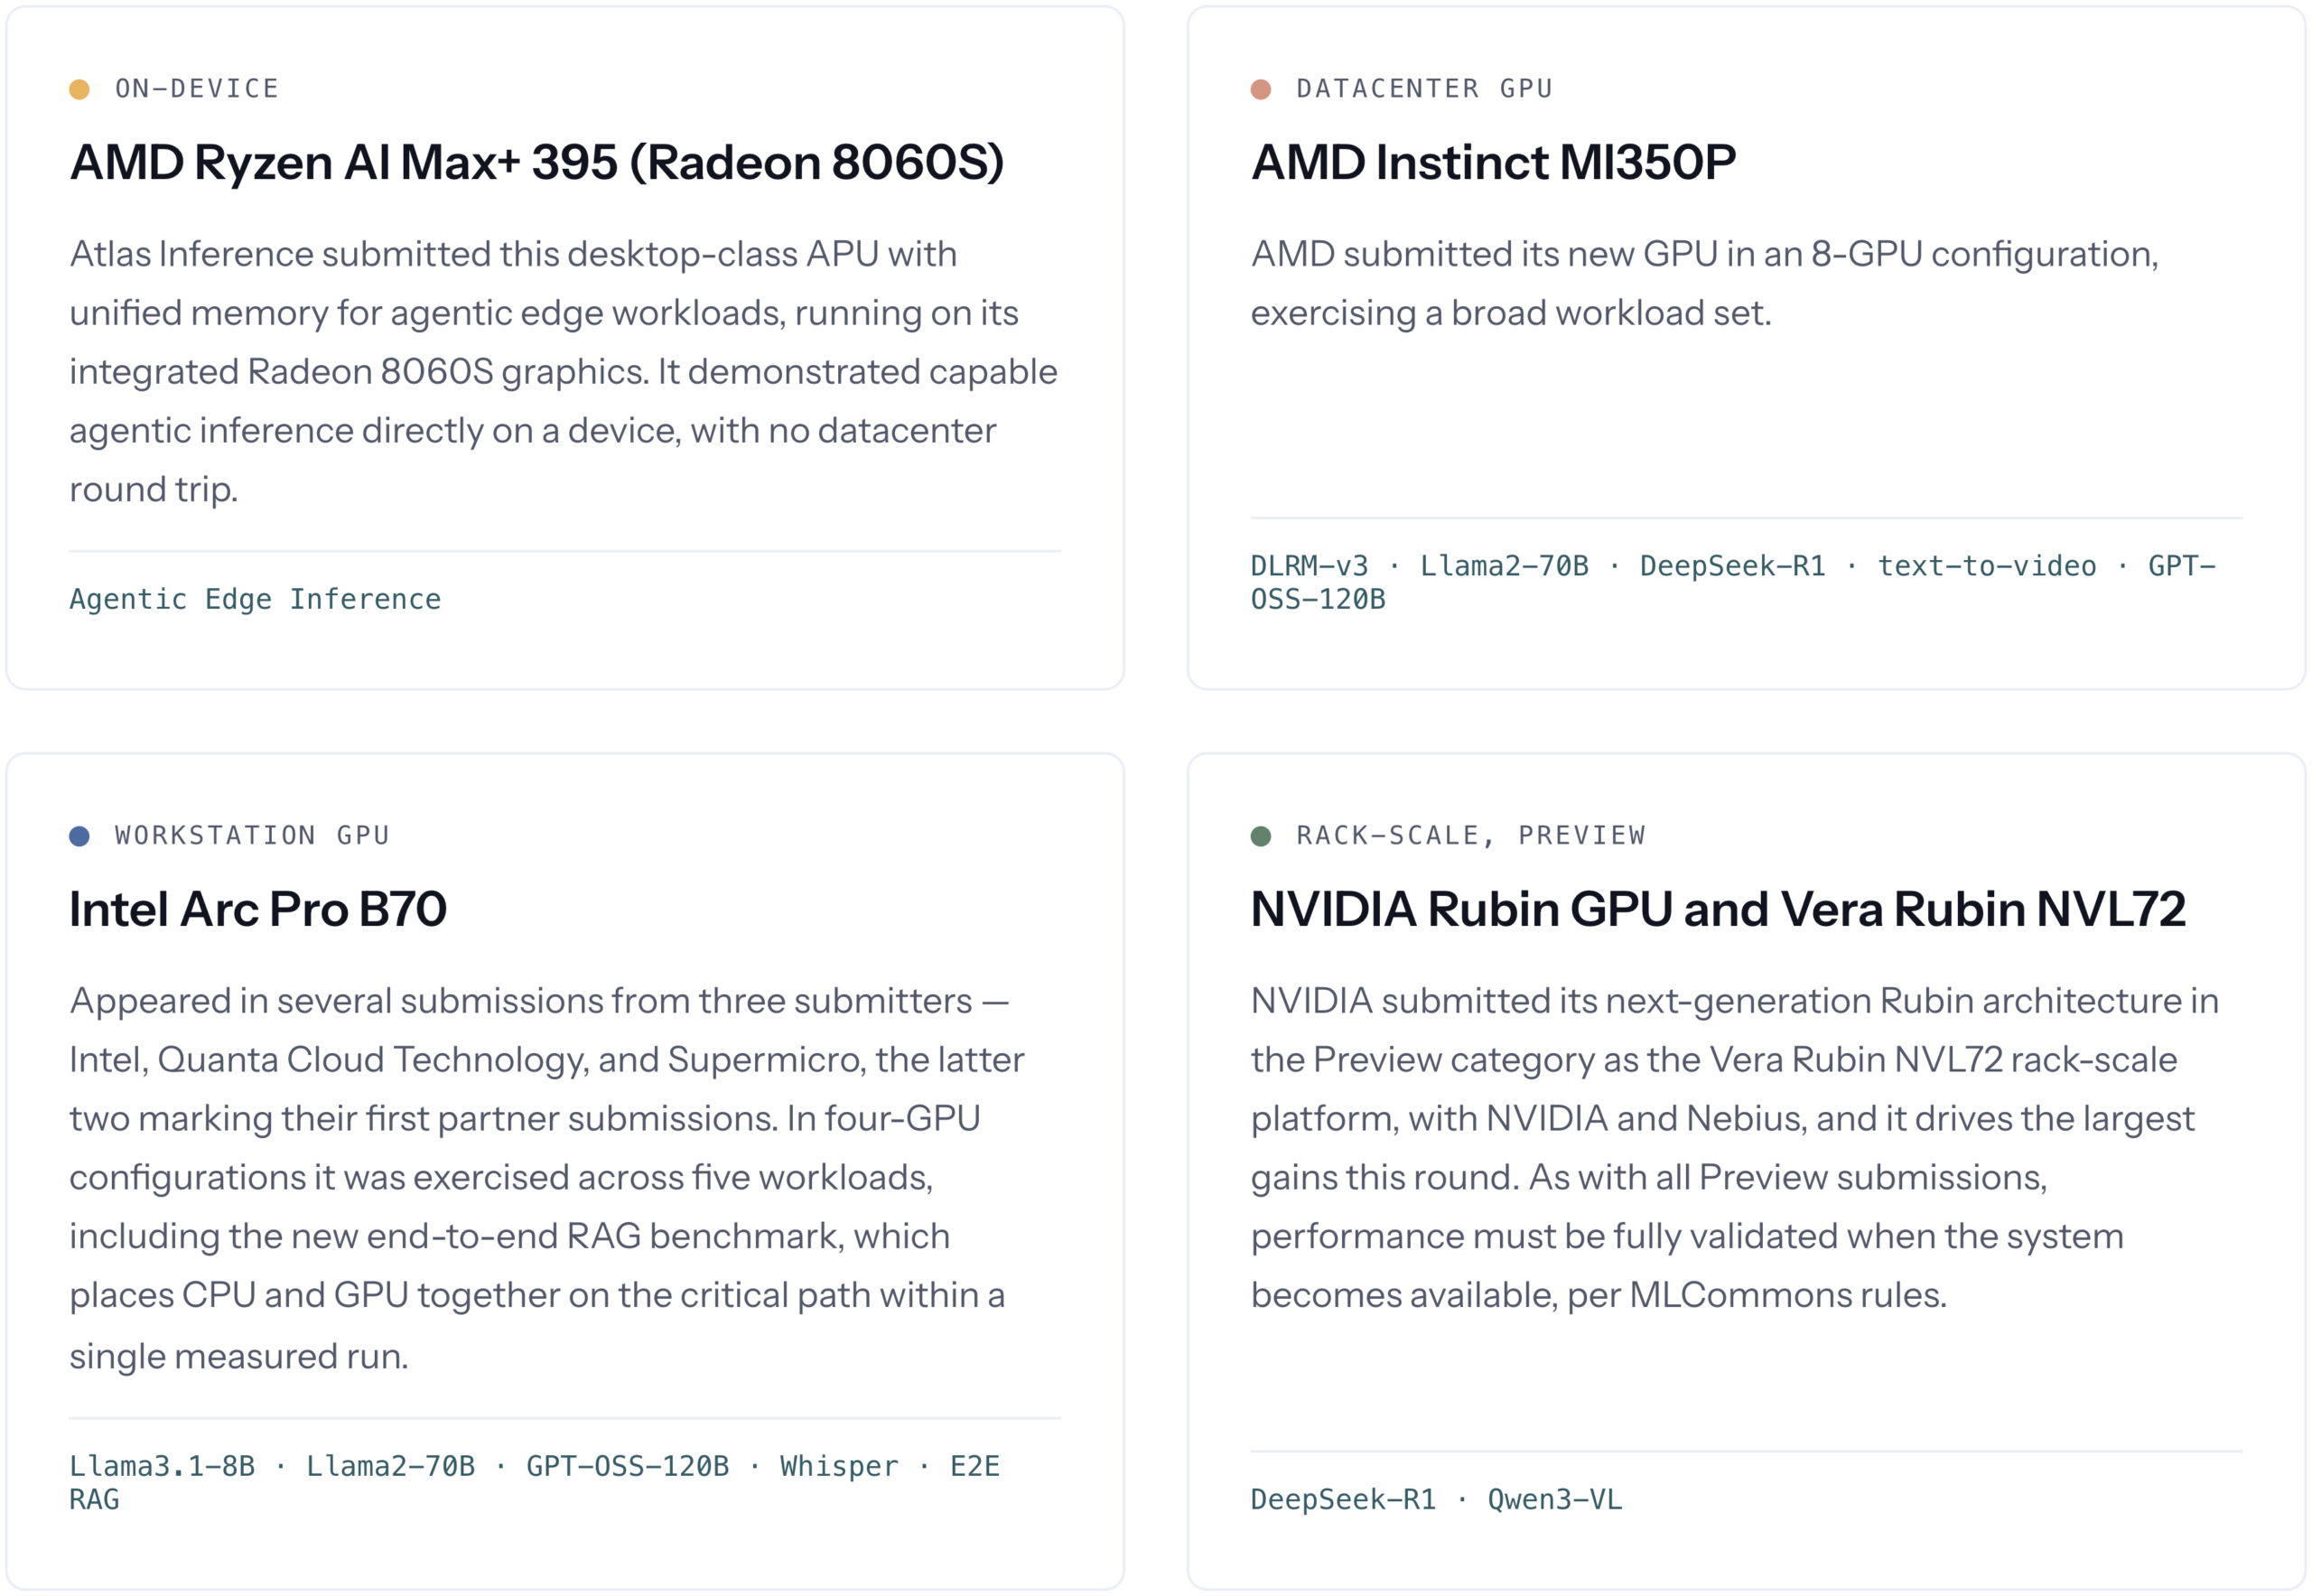
v6.0との比較では、VLMとDeepSeek R1がOfflineおよびServerシナリオで最大の性能向上を達成しており、主にNvidia Vera Rubinプレビューシステムによるものだ。その他のベンチマークでは、同一ハードウェア上でソフトウェアとアルゴリズムの最適化による漸進的な改善が見られた。
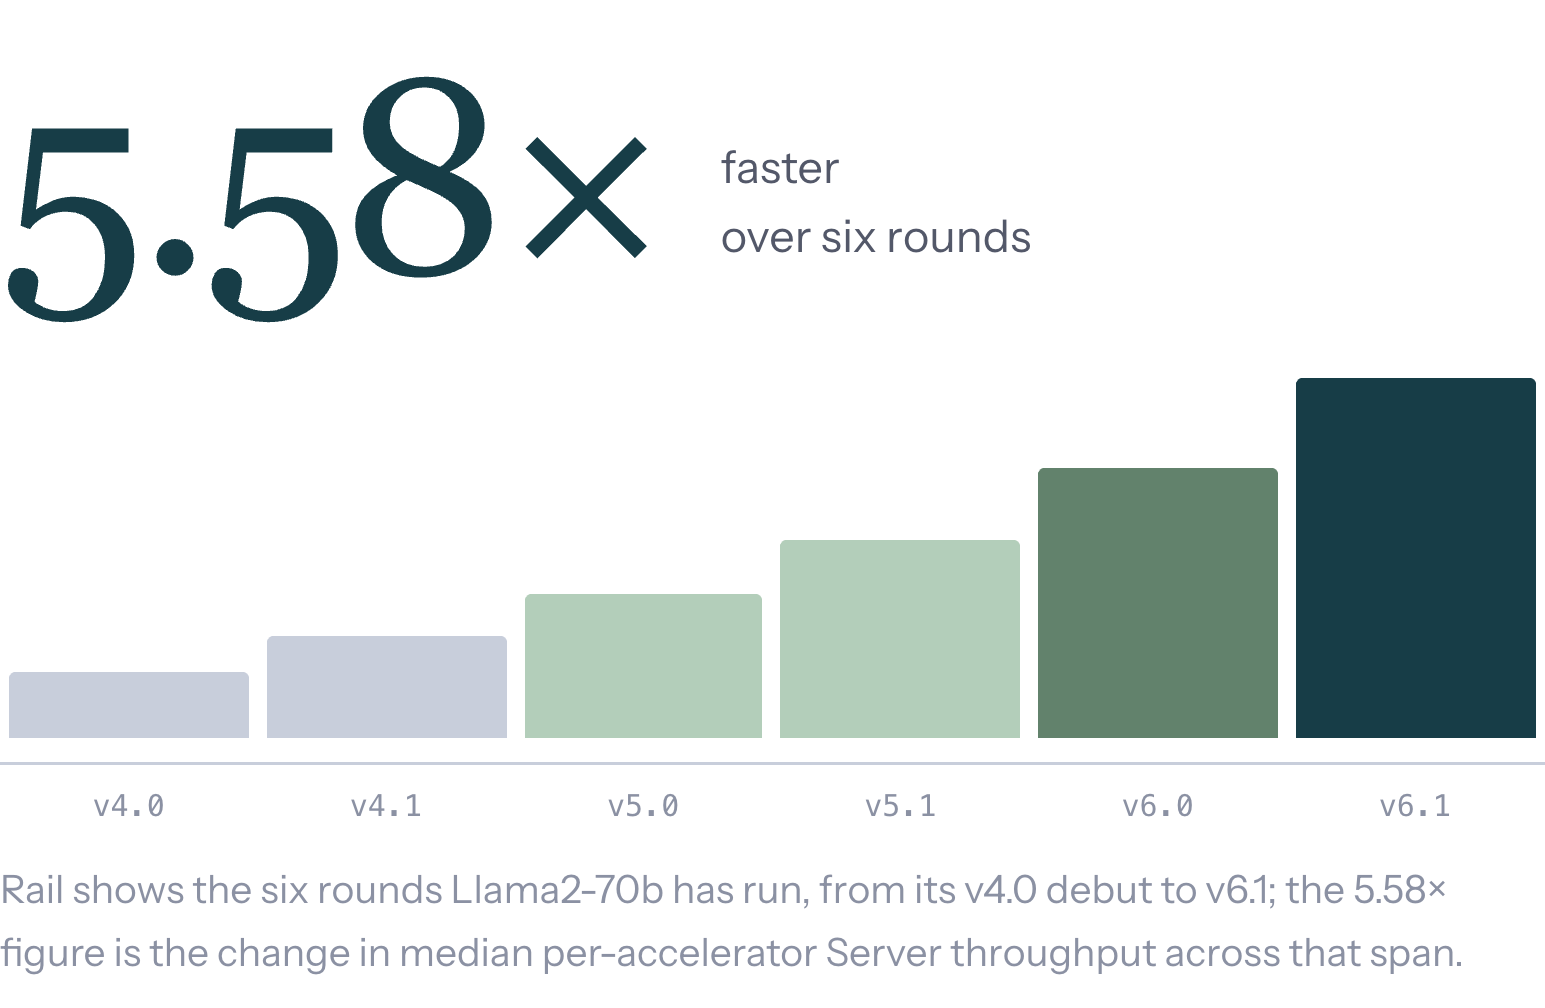
Llama2-70bはv4.0での導入以来6ラウンドにわたって稼働しており、Serverシナリオにおけるアクセラレーター1基あたりの中央値性能は累計5.58倍に向上した。主な推進要因としては、FP4低精度演算、新世代アクセラレーター、そして継続的なソフトウェアスタックの最適化が挙げられる。
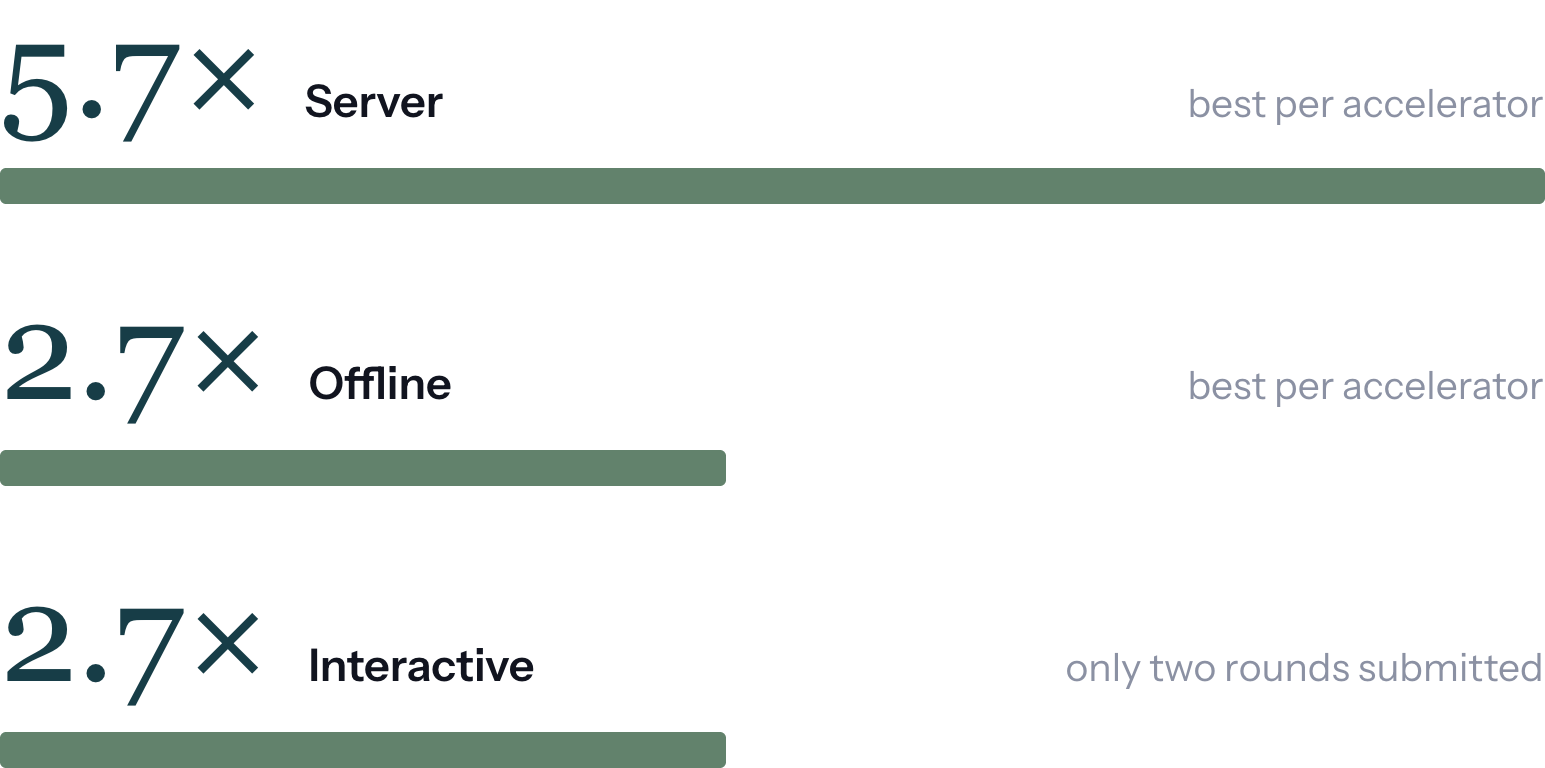
DeepSeek R1ベンチマークでは、1年以内にOffline性能が2.7倍、Serverシナリオが5.7倍向上し、Interactiveシナリオでも同様に2.7倍の成長を達成した。
注目の成果
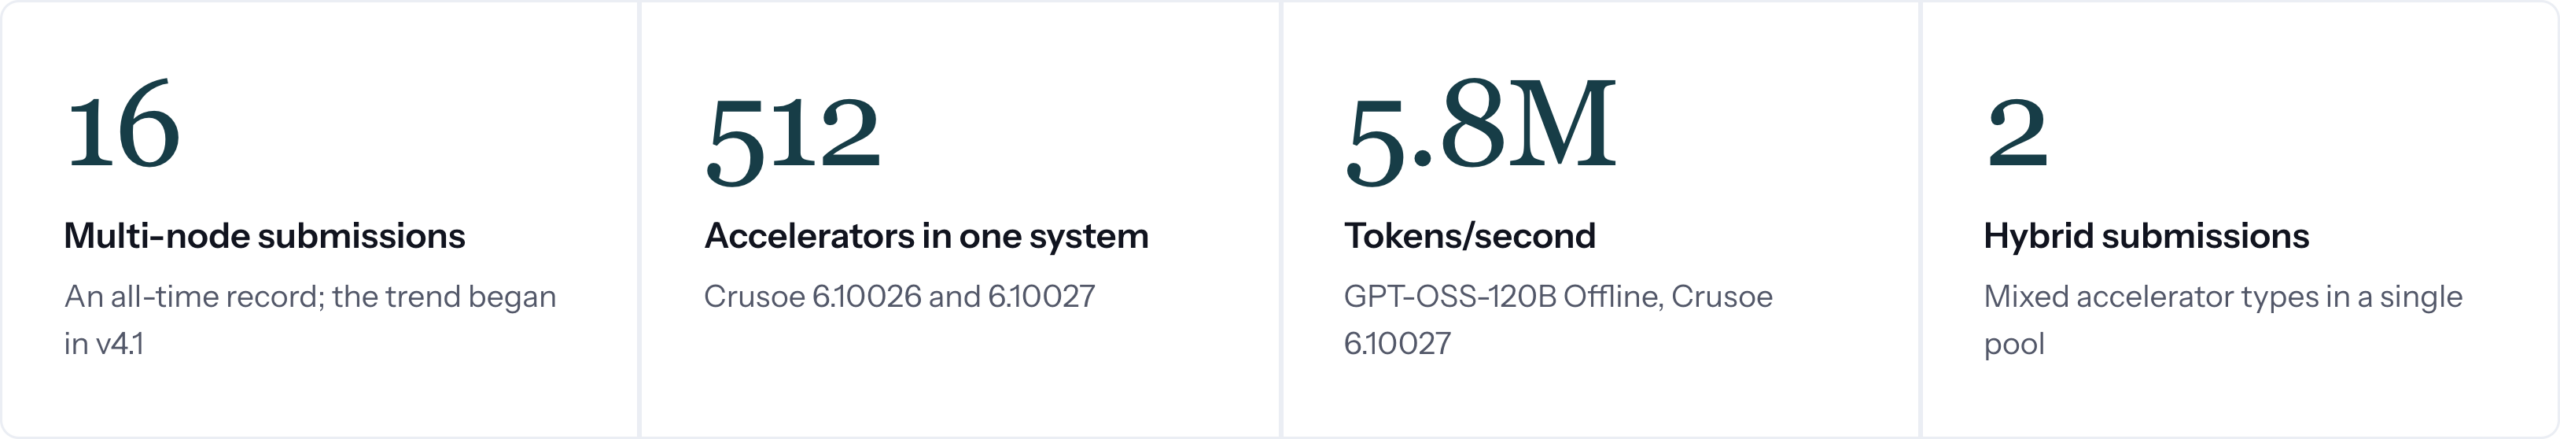
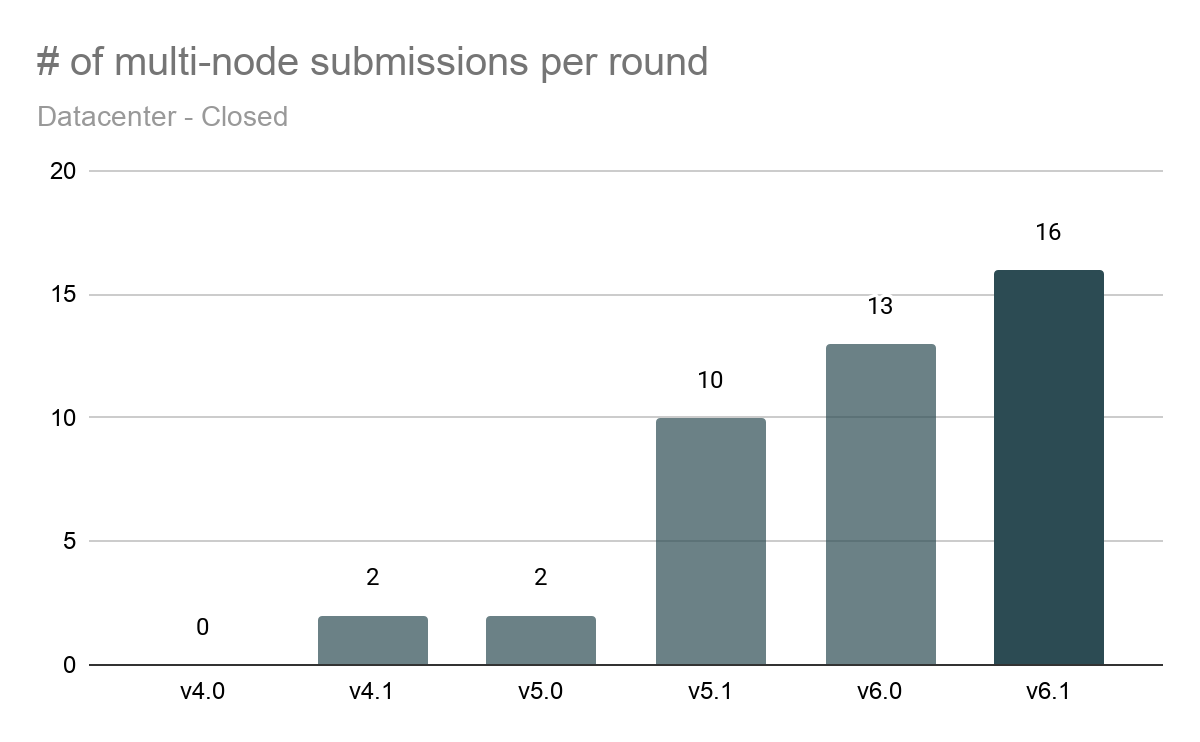
マルチノード提出数は増加を続けており、今ラウンドでは過去最高の16件に達した。また、最大提出システム規模は前ラウンドの288アクセラレーターから512アクセラレーターへと拡大した。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接