
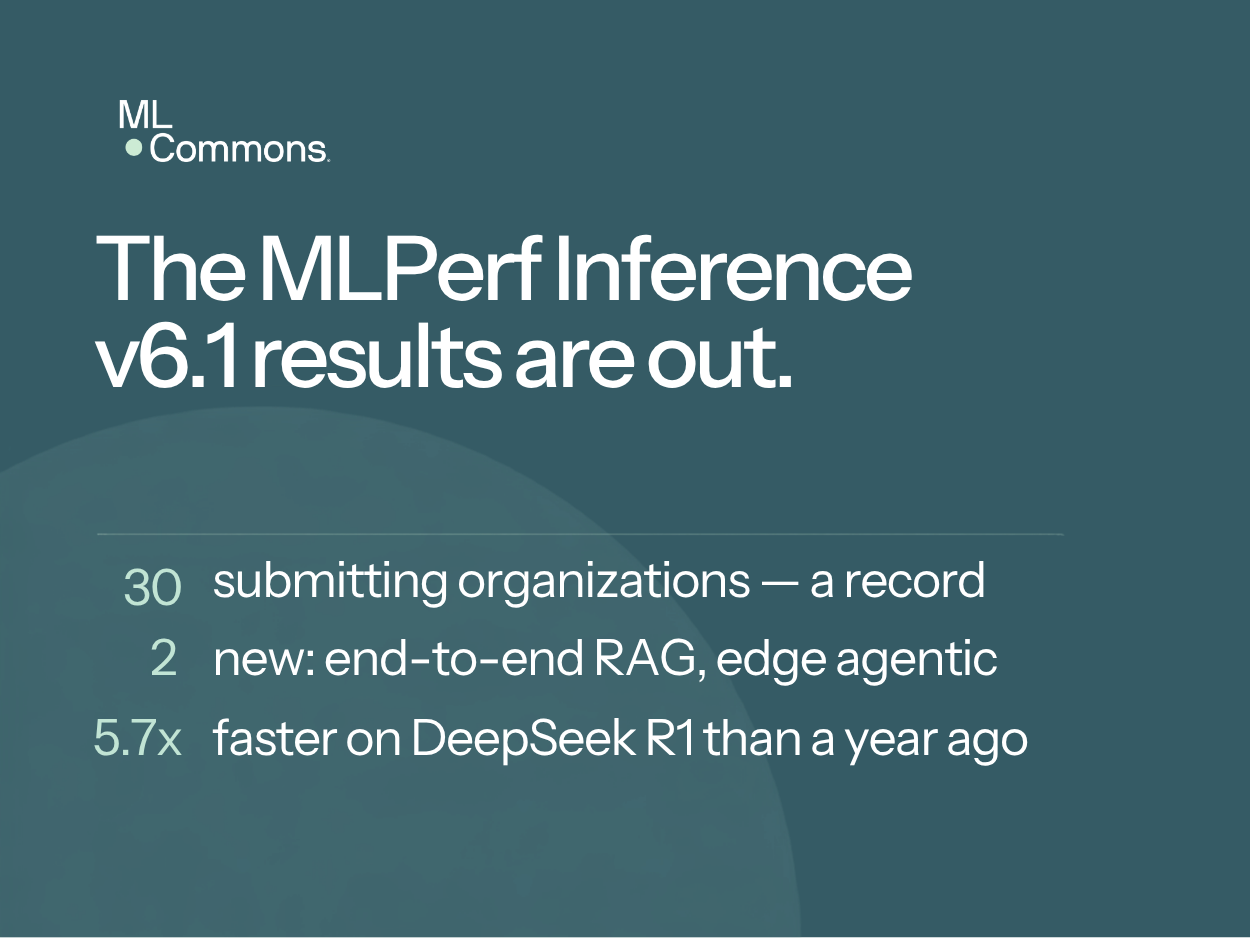
MLCommonsはMLPerf Inference v6.1ベンチマークの最新結果を発表した。今回の発表では提出機関数が過去最高を更新し、近年のAI推論デプロイのトレンドを反映した2つの新テストを導入。複数の新AIプラットフォームのピアレビュー済み性能結果を初公開し、1年前の最高性能と比較して最大5.7倍の向上を達成した。
ベンチマークの進化:新テストの追加と最適化サポート
MLPerf Inference v6.1では2つの新テストを導入し、業界がより複雑なマルチステップおよびエージェント型AI推論デプロイへと移行しているトレンドを反映している。データセンターおよびエッジシナリオの両方をカバーする。
エンドツーエンドRAG(検索拡張生成)ベンチマーク
このテストは、埋め込みモデル、リトリーバー、リランカー、LLMなどのステップを含むマルチモデル複合パイプラインの質問応答性能を評価する。文書コーパスの取り込みと、ベクターデータベースを用いたクエリ応答タスクをそれぞれ測定する。
エッジエージェント推論ベンチマーク
このテストは単一インタラクションから複雑なマルチターンのエージェント型ワークロード(エージェントコーディングなど)への移行に焦点を当て、エッジモデルと量化を採用する。シングルストリームのコーディングワークロードとレイテンシ指標をサポートし、時間制約下での精度測定および決定論的ワークロードの性能テストを含む。
さらに、投機的デコーディング(Speculative Decoding)最適化のサポートが新たに追加された。この技術は1回のフォワードパスで複数のトークンを予測・検証するもので、インタラクティブシナリオおよびGPT-OSSタスクにすでに適用されている。
提出結果が示すAIイノベーションの速度
今回のベンチマークにはAMD、NVIDIA、Intelを含む30機関から過去最高の提出が寄せられた。新ハードウェアとしてAMD Ryzen AI Max+ 395、AMD Instinct MI350P、Intel Arc Pro B70、およびプレビュー段階のNVIDIA RubinとVera Rubin NVL72が登場。最大システムは512基のアクセラレーターを搭載し、初のヘテロジニアスシステムも登場した。
性能は記録を更新し続けている。ビジョン言語モデル(VLM)のサーバーシナリオにおけるアクセラレーター当たりの結果はv6.0比2.99倍向上、DeepSeek R1テストではv5.1比5.7倍の向上を達成した。
業界の幅広い参加と今後の展望
Atlas InferenceやCrusoeを含む6機関が初めて提出を行った。提出者の50%以上がMLPerfの新APIセントラライズドハーネスを採用しており、次世代MLPerf Endpointsベンチマークの基盤を築いている。
詳細な結果はMLCommons公式サイトおよびビジュアライゼーションダッシュボードから確認できる。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接