
SGLang-TorchTPUが本日正式にオープンソース化された。RadixArkのSGLangチームがGoogleおよびMetaと共同開発したものである。
リリースされたモデルには、Muse Spark Open、GLM-5.3 Flash、GLM-5.3、Kimi K3、DeepSeek V4、Ling 3.1 Flash、Qwen3.8、Gemma 4、MiniMax H3が含まれる。このプラグインはSGLangの完全な機能セットをTPU上に導入し、Metaの大規模本番環境で検証済みであり、エージェント型ワークロードに適している。
動作原理
SGLang-TorchTPUはツリー外プラグインであり、sglang-tpuパッケージを通じてTPUプラットフォームを登録する。SGLangのコアスケジューラー、RadixAttention、APIサーバーはそのまま維持され、プラグインがアテンションバックエンド、KVキャッシュプール、MoEカーネル、グラフランナーを提供する。
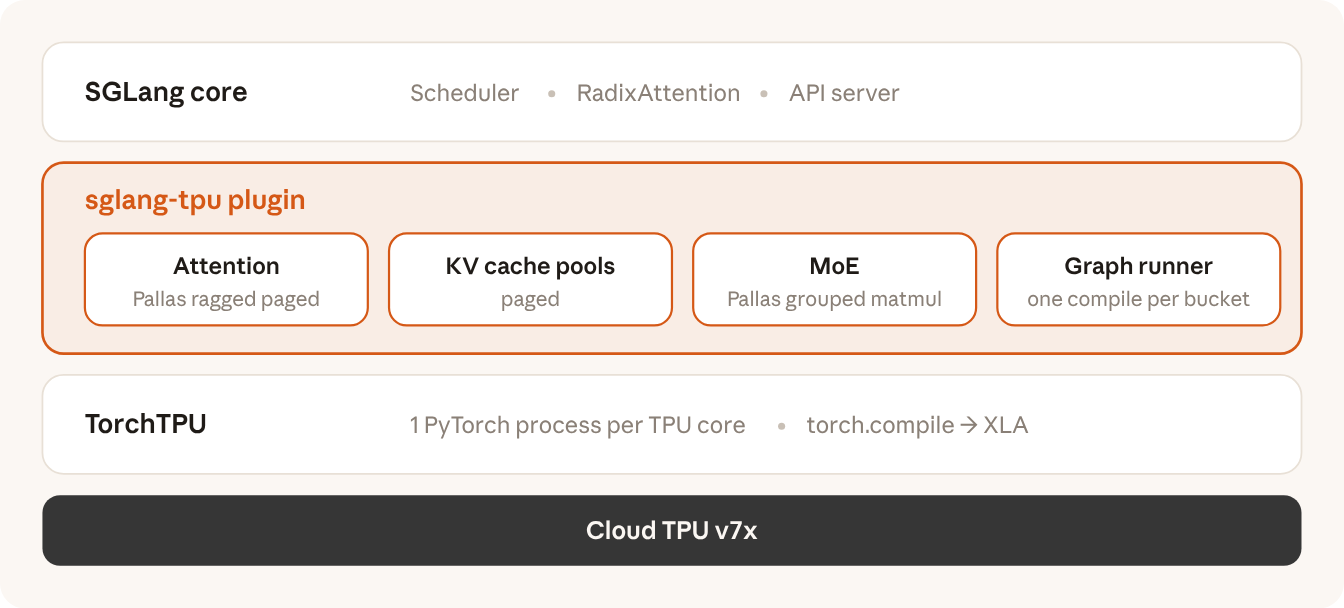
各TPUコアが独立したPyTorchプロセスを実行し、モデルはtorch.compileによってXLAへとコンパイルされる。アテンションとMoEはPallasカーネルで実装されている。
KVキャッシュ転送
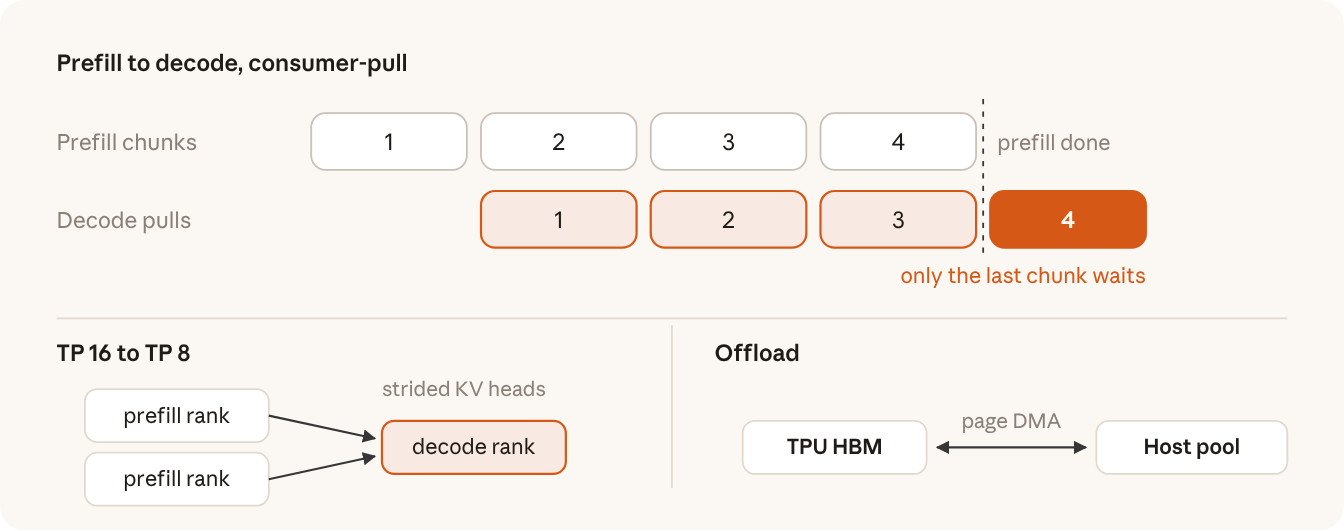
TPU Syncを通じてKVキャッシュのオフロードとプリフィル・デコード分離を実現し、ホスト間のリシャーディングをサポートする。
機能とモデルカバレッジ
OpenAI互換API、連続バッチ処理、RadixAttentionプレフィックスキャッシュ、投機的デコード、コンテキスト並列処理、マルチモーダル、ホスト間テンソル並列処理などの機能をサポートする。Qwen3-VLなどのビジョン言語モデルにも対応済みである。
信頼性の保証
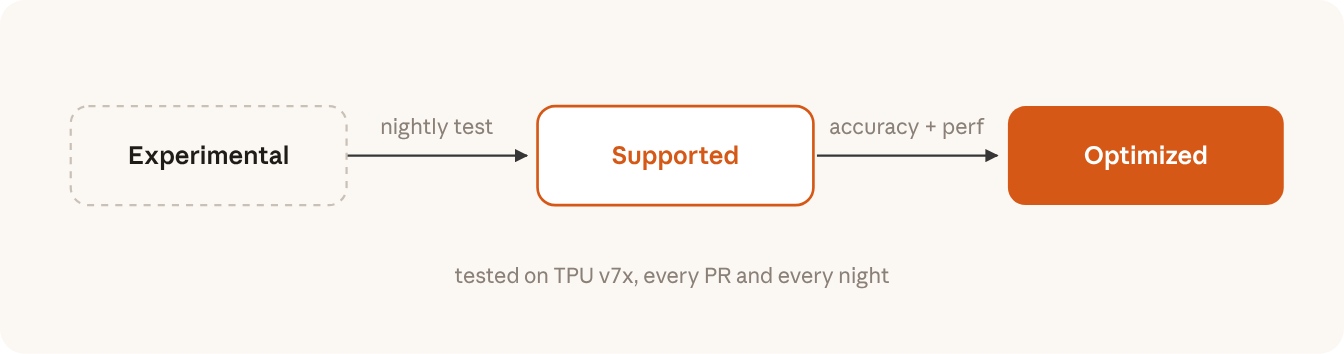
サポートされているすべてのモデルと機能は、TPU v7x実機によるCIテストで検証されている。
TPU上のRL学習
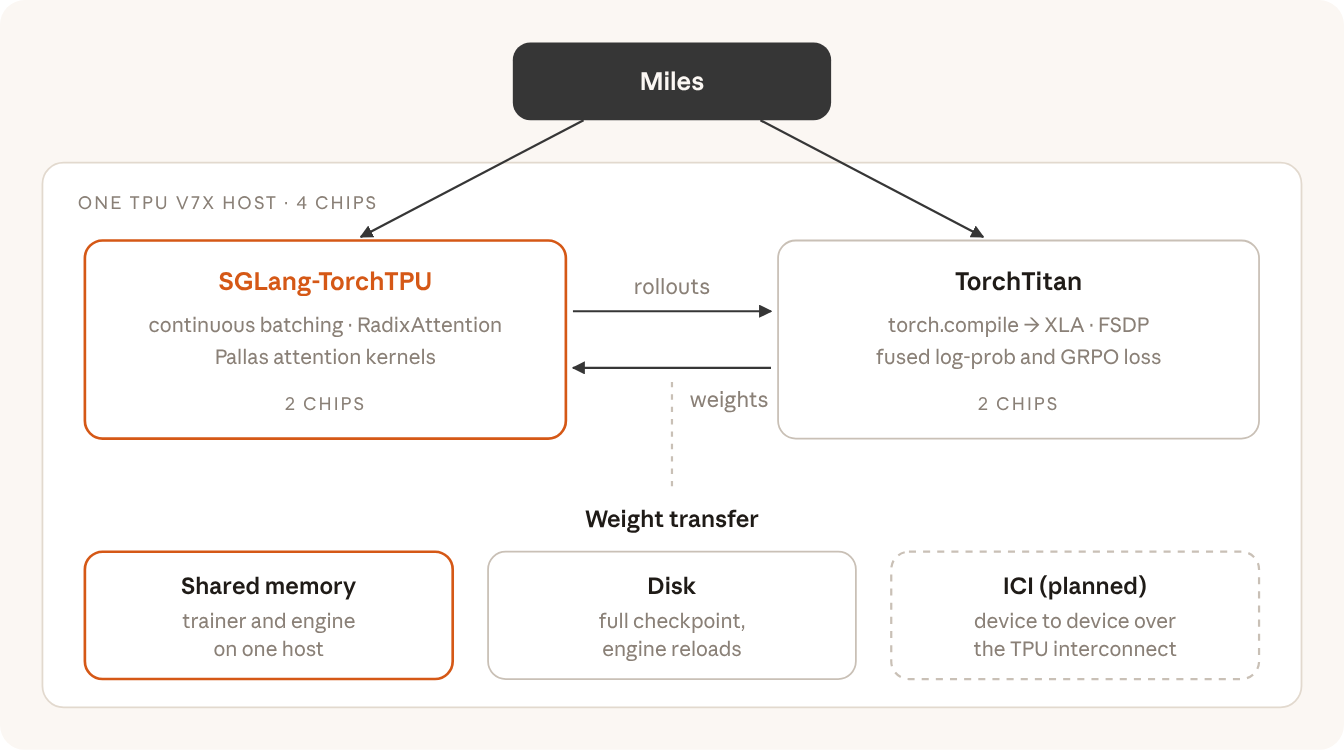
TorchTitanとMilesフレームワークを組み合わせ、エンドツーエンドの強化学習を実現する。
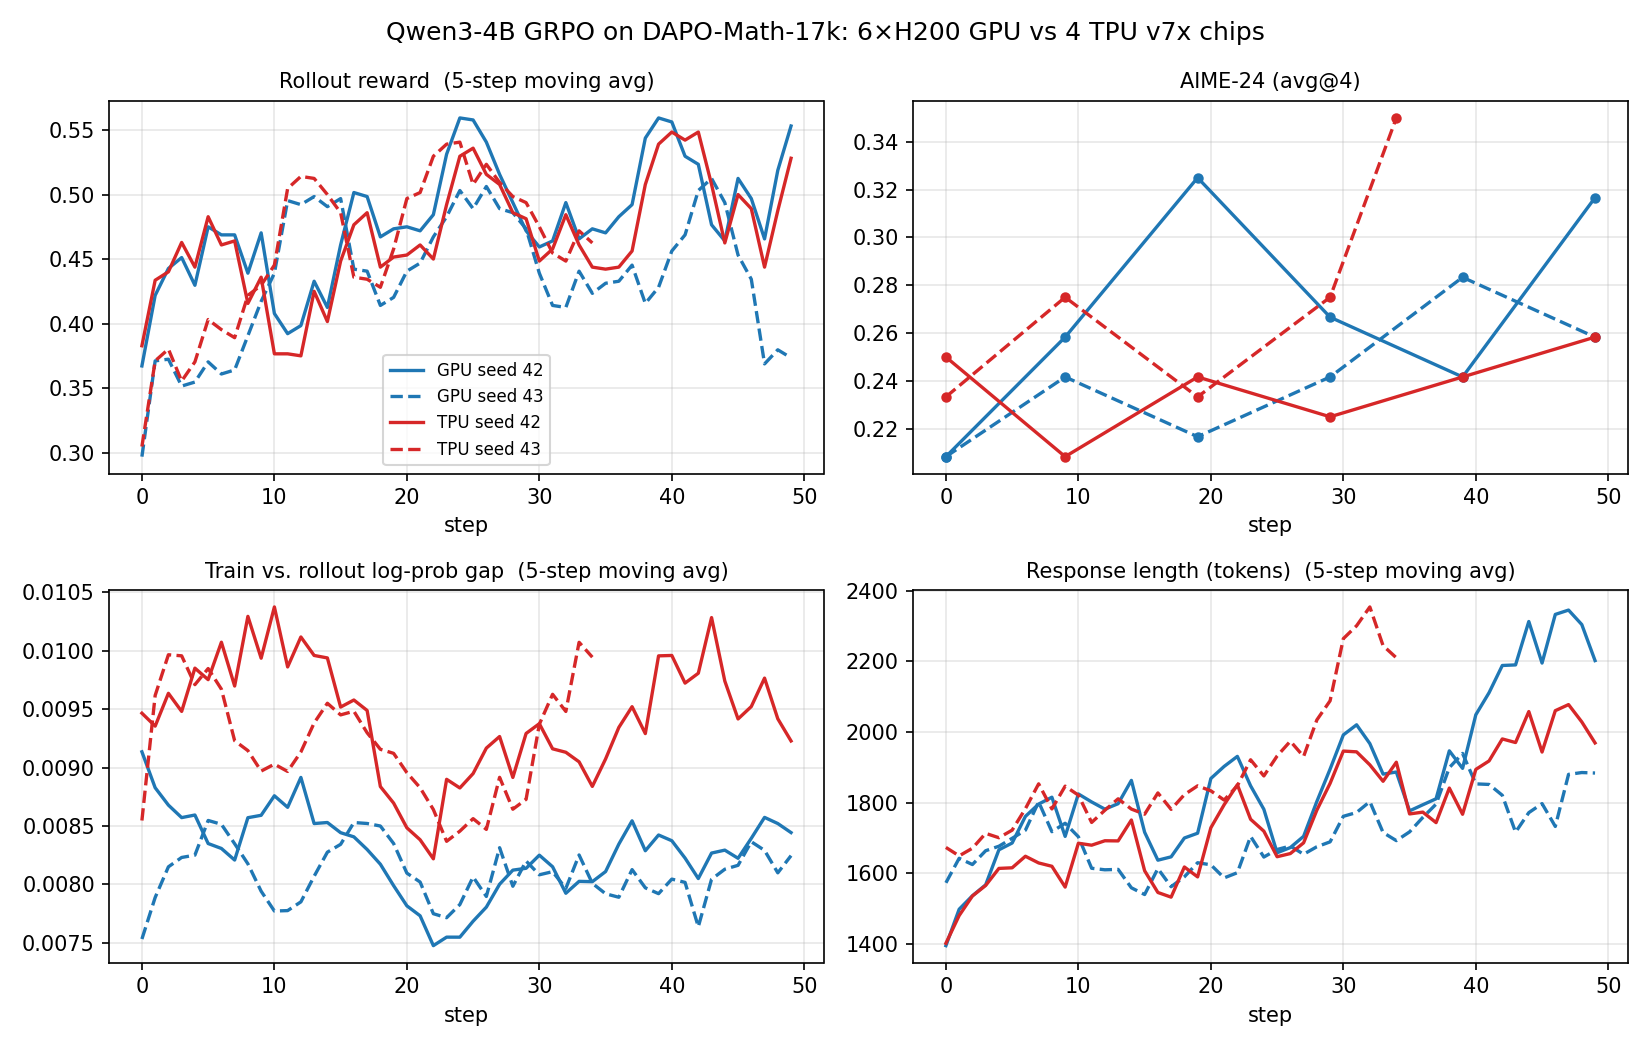
Qwen3-4B GRPOの実験では、4基のTPU v7xチップが6枚のH200 GPUに匹敵する性能を示した。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接