
常時稼働のAIエージェントは、テキスト生成だけでなく、視覚情報の解釈、長時間タスクでの推論、そして文書・アプリ・動画を扱うためのツール呼び出しの信頼性が求められる。NVIDIA Nemotron 3.5 Super VLはまさにこの目的のために設計されたオープンなマルチモーダルモデルであり、テキスト・画像・文書・動画の入力に対応し、エージェント推論とツール呼び出しのためのテキストを出力する。
モデル概要
本モデルはMixture-of-Experts(MoE)アーキテクチャを採用し、総パラメータ数1200億、1回の推論あたり120億パラメータを活性化する。Nemotron 3シリーズにおける高精度マルチモーダル実行モデルとして位置づけられ、Nemotron 3.5 LightningおよびNemotron 3 Ultraを補完する形で、企業向けカスタマイズワークフローに特化して設計されている。
主な特徴
- アーキテクチャ:120BパラメータのMoEモデル、1回の推論あたり12Bパラメータを活性化
- モダリティ:テキスト・画像・文書・動画の入力、テキスト出力
- 最適化:C-RADIOv4ビジュアルエンコーディング、ハイブリッドMamba-Transformerアーキテクチャ、Multi-Token Prediction(MTP)、NVFP4量子化
- デプロイ対象:DGX Spark、1x GB10、B200、B300、RTX PRO 6000、H200、および2x H100
SGLangによる迅速なデプロイ
SGLangは本モデルに対して高性能サービングレイヤーを提供し、継続的バッチ処理、プレフィックスキャッシング、投機的デコーディング、およびOpenAI互換APIをサポートする。
インストールと起動
docker pull lmsysorg/sglang:v0.5.21コンテナ起動後、以下のコマンドを実行する:
sglang serve --model-path nvidia/NVIDIA-Nemotron-3.5-Super-VL-120B-A12B-NVFP4 --trust-remote-code --reasoning-parser nemotron_3 --speculative-algorithm EAGLE --speculative-num-steps 5 --speculative-eagle-topk 1 --speculative-num-draft-tokens 6 --port 8000Multi-Token Predictionによる推論最適化
本モデルには内蔵のMTPヘッドが搭載されており、EAGLEによる投機的デコーディングと組み合わせることで、RTX 6000 PROにおいて243.9トークン/秒のスループットを達成し、長時間エージェントタスクに特に適している。
マルチモーダルエージェントワークフロー
本モデルはスクリーンショット・文書・インターフェース・動画を処理でき、カスタマーサービス、ドキュメントインテリジェンス、企業生産性向上、動画理解、およびウェブリサーチなどのユースケースに対応する。また、NVIDIA NeMoによるドメイン特化のカスタマイズも可能である。
精度と効率のパフォーマンス
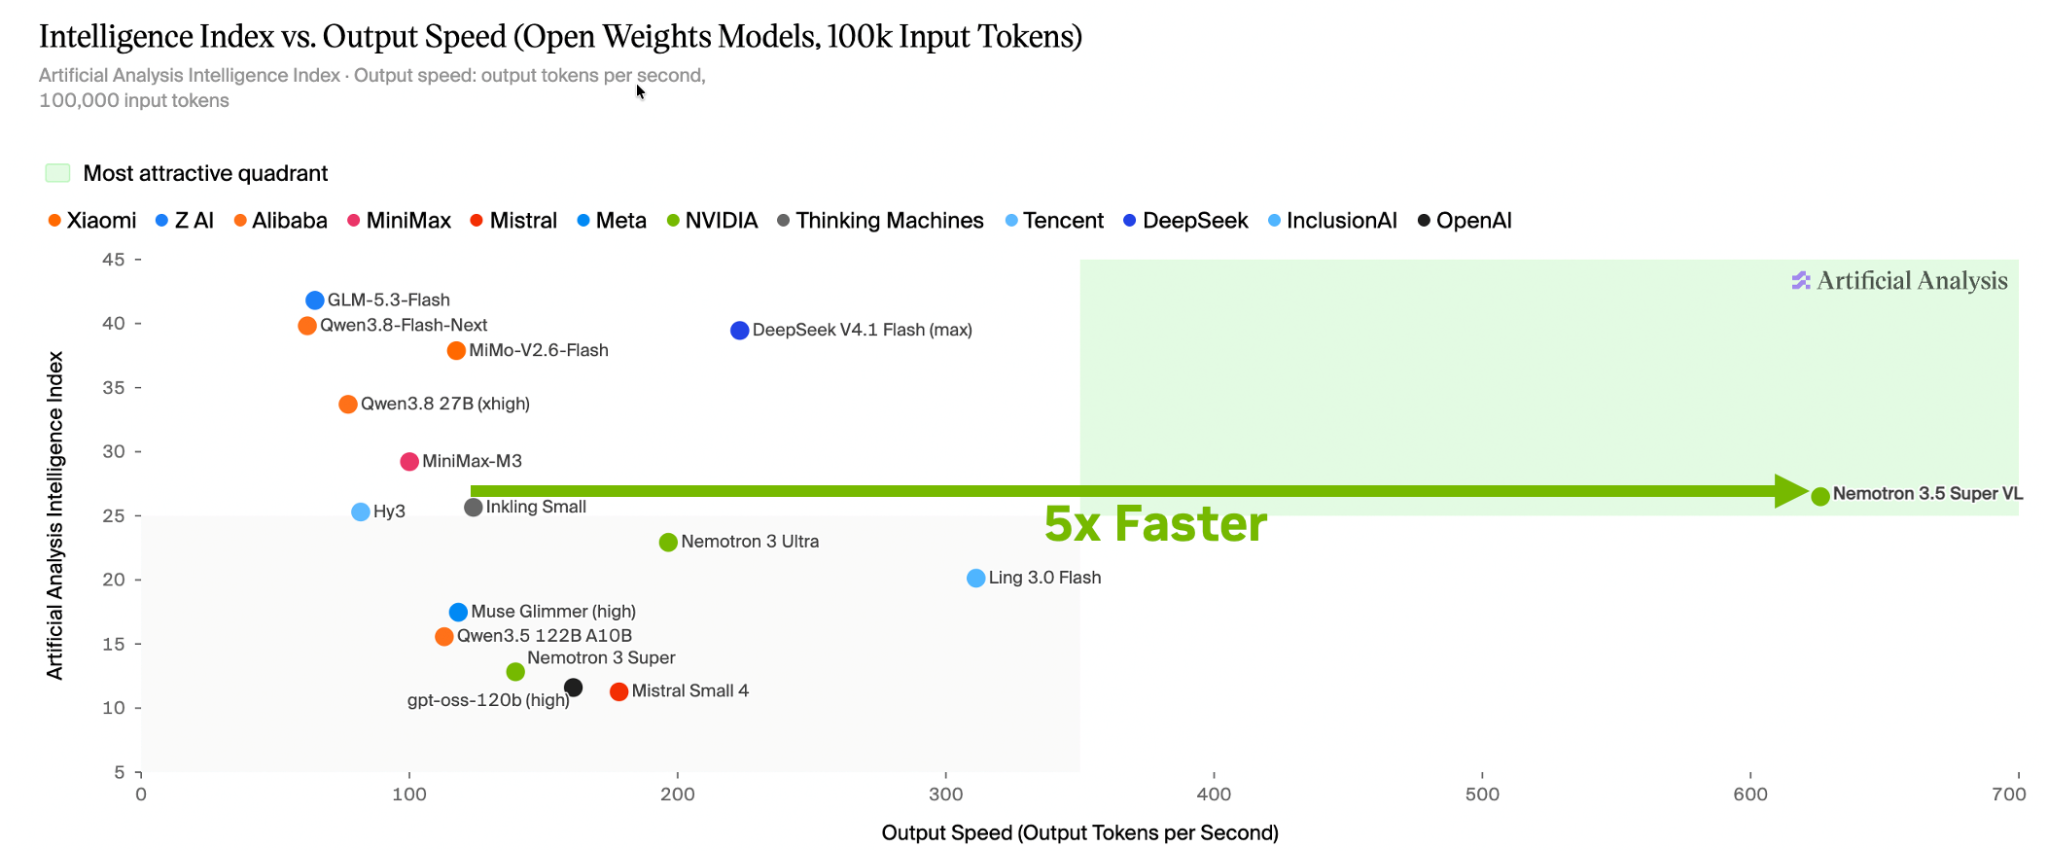
単一GPU上において、Nemotron 3.5 Super VLはArtificial Analysis Intelligence Indexのエージェントタスクで5倍以上のスループット向上を実現している。
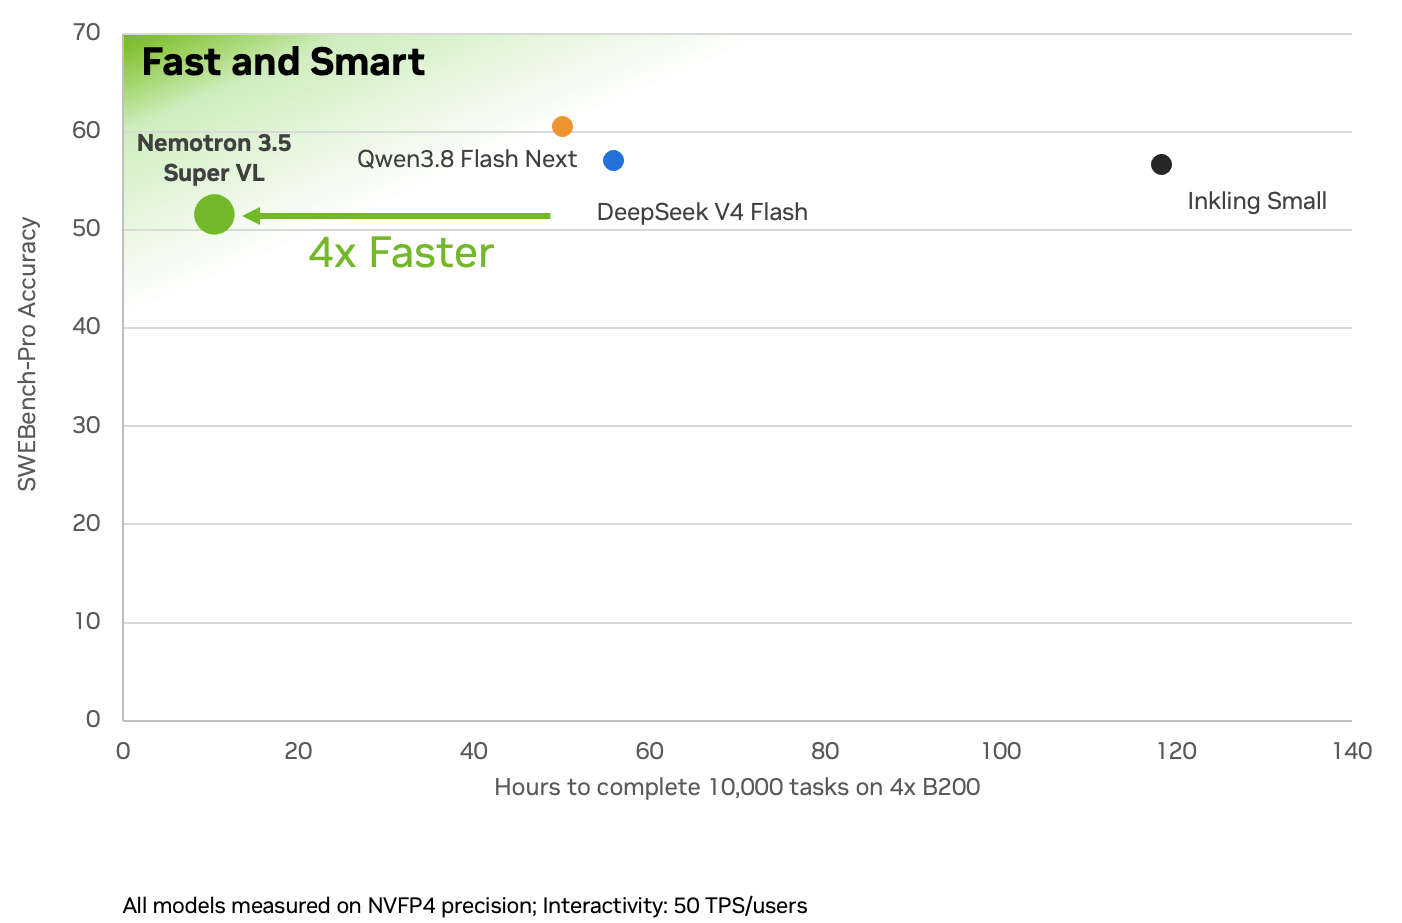
SWE-bench Proタスクにおいて、本モデルは1万件のタスクを完了するのに要する時間が、同種のオープンモデルと比較して4分の1に短縮されている。
リソースの入手
Hugging FaceからBF16またはNVFP4の重みをダウンロードし、SGLang cookbookを参照して迅速に使い始めることができる。
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接