
AI業界において、ベンチマークテストはもはや単なる技術的詳細ではなく、各社が主導権を争う「主戦場」となっている。OpenAI、Anthropic、Google DeepMindといった研究機関は新モデルを発表する際、ほぼ必ずMMLU、GPQA、SWE-benchといった略語と数値による比較表を添えて、自社製品の優位性を示す。この論理が成立する前提は、評価が中立・正確・再現可能であることだ。
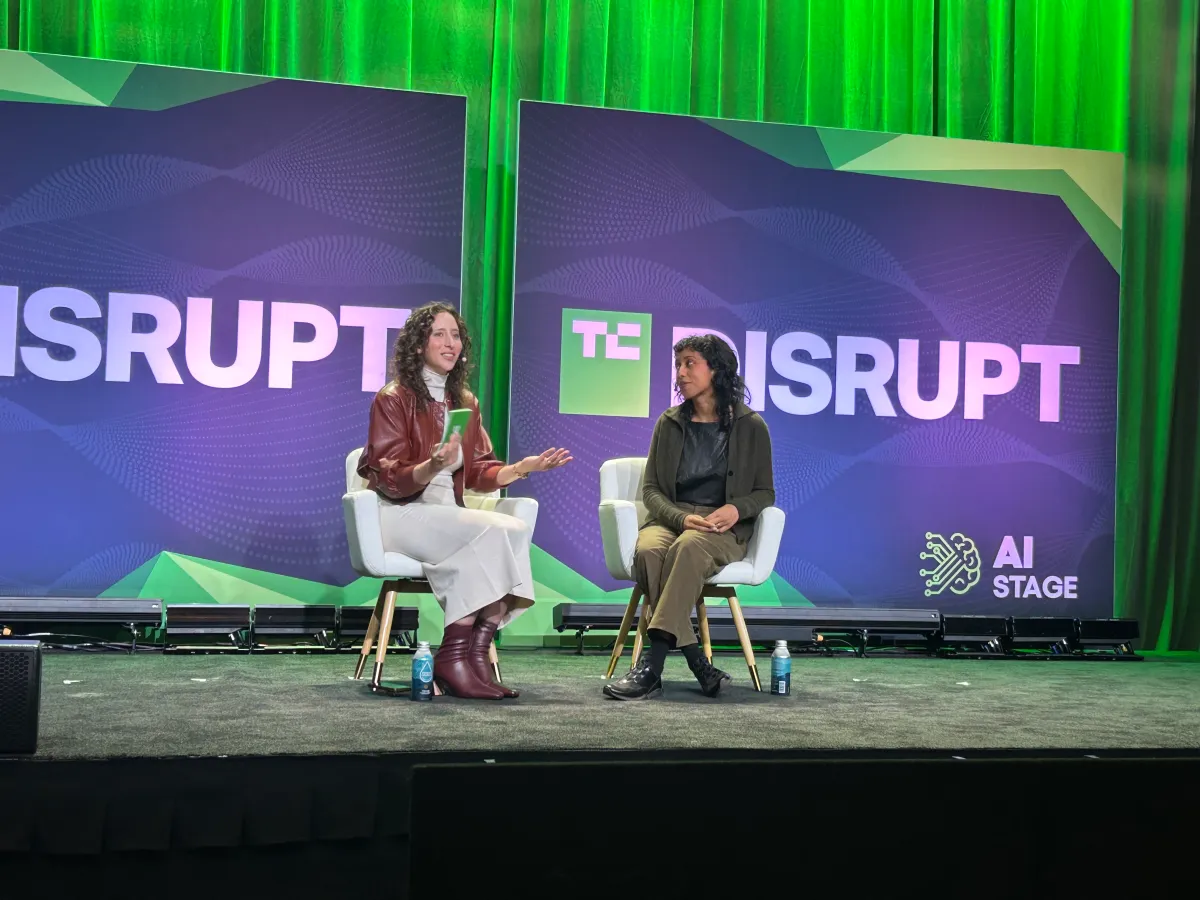
しかし、この前提はますます強まる疑問の目にさらされている。先日、TechCrunchが主催した対談において、Hugging Faceの最高政策責任者Irene Solaiman氏は、AIの評価手法は「非常に複雑で、いまだ成熟途上にある」と率直に述べた。言い換えれば、今日広く引用されているランキングは、見た目ほど信頼できるものではないということだ。
「審判」がフィールドに入る:組み込み型評価器という誘惑
ベンチマーク漏洩、データ汚染、スコア操作、採点者バイアスといった外部評価の諸問題に対し、評価メカニズムをモデルや製品の内部に直接組み込み、AIが動作中に「自己採点」を行うか、内蔵された評価モジュールがリアルタイムで出力品質を判定するという手法が広まっている。こうした「組み込み型AI評価器(embedded AI evaluators)」は、評価問題の近道として一部から注目されている。
Solaiman氏はこれに対して慎重な姿勢を示した。評価器をシステム内部に置いたからといって、評価そのものの複雑さや主観性が自動的に解消されるわけではなく、むしろ不透明な問題がより深く隠れてしまう可能性があると指摘した。モデル自身やベンダーが設計した評価モジュールが、外部の独立評価と同じ基準を保証できるのか。評価者と被評価者が同一の立場にある場合、評価者を評価するのは誰なのか。
評価とは、モデル自身に「外注」できる工程ではなく、独立性・透明性・反復的な検証が可能なインフラでなければならない——これこそがSolaiman氏の発言が伝える核心的な懸念だ。
ベンチマークテストが抱える真の困難
なぜ「単純な解決策」が単純ではないのかを理解するには、評価がはらむいくつかの構造的問題に立ち返る必要がある。
第一に、汚染の不可視性。モデルの学習データに評価問題や解答が混入していた場合、どれほど高いスコアを得ても意味をなさない。しかしモデルのベンダーは学習データを完全に開示できないことが多く、外部の研究者が一つひとつ検証することも難しい。
第二に、指標の一面性。数学問題で高スコアを獲得したモデルが、必ずしより安全で、より有益で、ハルシネーションが少ないとは限らない。複雑な能力を少数の数値に圧縮することで、大量の情報が必然的に失われる。
第三に、「大規模モデルが大規模モデルを評価する」という循環依存。大規模モデルを使って大規模モデルを採点する手法はコストが低くスケールしやすいが、審判モデル自身のバイアスが結果に系統的に波及する。審判モデルと被評価モデルが同一系列である場合、この問題は特に深刻だ。
Hugging Faceの立場と業界へのシグナル
オープンソースモデルコミュニティの代表として、Hugging Faceはオープンな評価ツールとモデルカード(model card)の規格整備に長年取り組んできた。Solaiman氏の提言は、学術界や政策立案の現場で近年共有されている主張とも呼応している。評価は「監査可能」な方向へと進化すべきだという主張だ。これは、評価データセット、プロンプト、採点基準、実行環境をすべて公開し、結果を第三者が再現できるようにすべきであることを意味する。見栄えのよい棒グラフを提示するだけでは不十分だ。
注目すべきは、規制面でも動きが加速していることだ。EUのAI法は高リスクシステムに対して評価と文書化の要件を課しており、米国の複数州の立法案も独立評価を議論の重点に据えている。これらの枠組みのもとで、評価はマーケティングツールにとどまらず、コンプライアンスの連鎖における一環となりつつある。
編集後記:評価を新たなマーケティング手法にしてはならない
過去2年間、ランキングの更新速度はほぼモデルのリリース速度と並走してきた。しかし、スコアに対する一般の信頼は低下している。その理由は難解ではない。評価が被評価者によって資金提供され、利害関係者によって設計され、同じモデル群が審判を務めるとなれば、それは科学的な測定というより広報資料に近いものとなる。
組み込み型評価器そのものに価値がないわけではない。製品面では、継続的な実行時モニタリングに活用して品質の劣化をタイムリーに検知できる。企業への導入においては、コンプライアンス上のガードレールとして機能しうる。しかしその位置づけはあくまで補完的なものであり、独立した外部評価の代替となるべきではない。「モデルが自分自身を採点できる」ことを問題解決の証拠とみなせば、業界は信頼できる評価から遠ざかるばかりだ。
Solaiman氏の見解は実にシンプルだ。評価は難しく、短期間で簡単にはならない。その事実を認めることこそが、信頼できるAI評価体系を構築するための出発点かもしれない。
本記事はTechCrunchより編訳
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接