
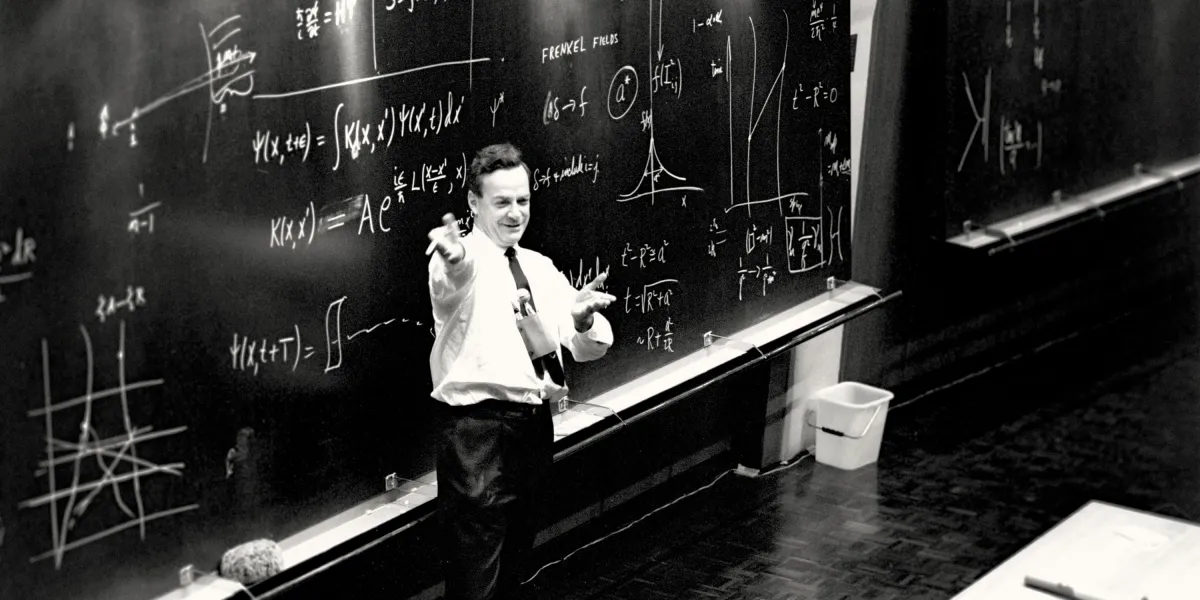
編集者注:1959年、物理学者リチャード・ファインマンはカリフォルニア工科大学で一見突飛な問いを提起した──物をどこまで小さく作れるか?六十余年後、この問いはより切迫した別の問いへと変容した:計算をどこまで推し進められるか?
1959年12月29日の夜、カリフォルニア工科大学の講堂で、物理学者リチャード・ファインマン(Richard Feynman)はアメリカ物理学会年次大会の壇上に立ち、後に繰り返し引用されることになる講演を行った──「底にはまだ十分な空間がある」(There's Plenty of Room at the Bottom)である。当時、最先進のコンピュータは真空管とリレーで動作し、一台の機械が部屋全体を占拠していた。それに対してファインマンが語ったのは、ブリタニカ百科事典の全巻を一本の画鋲の針先に書き込むこと、原子スケールで機械を製造し情報を記録することだった。
六十余年が経ち、あの講演はナノテクノロジーの思想的出発点として広く認められている。しかしその真の先見性は、計算を物理学の問題として捉え直した点にあるかもしれない──情報は物質に書き込める、そして物質の大きさ、エネルギー消費、放熱能力が、最終的に計算をどこまで推し進められるかを決定する、と。
「小さくすること」をめぐる講演
ファインマンは講演の中で、人類は書き込みのスケールを段階的に縮小できると主張した──まず文字を縮小し、最終的には単一原子の配列にまで至るという。彼はその場で千ドルの懸賞金を提示した──初めて小型モーターを製作した者と、ブリタニカ百科事典を針先ほどの大きさに書き縮めた者に対してである。前者は1960年に達成され、後者は1985年にスタンフォードの研究者が電子線リソグラフィによって実現した。
さらに重要なのは、計算に関する彼の見解だった。彼は極めて小さな素子でコンピュータを製造することを構想し、記憶密度は最終的に原子そのものの寸法によって制限されると指摘し、さらに聴衆に警告した──計算の各ステップはエネルギーを消費し、そのエネルギーは最終的にすべて熱となる、と。この一見単純な観察こそ、今日のデータセンターとAIチップが直面している核心的な難題である。
ムーアの法則の黄金時代と退潮
1965年、ゴードン・ムーアは後にムーアの法則と呼ばれる観察を提唱した──集積回路上のトランジスタ数は約2年ごとに倍増する。その後半世紀にわたり、この曲線は情報産業全体のメトロノームとなった──1971年のインテル4004プロセッサの2300個のトランジスタから、今日の一枚のチップに搭載される数千億個のトランジスタまで、算力の成長はソフトウェア、インターネット、人工知能の全体的な形を形作ってきた。
しかしそのメトロノームは速度を失いつつある。2000年代中頃、デナードスケーリング(Dennard scaling)は終焉を迎えた──トランジスタは縮小し続けたが、電圧を同期して下げることができず、電力密度が急激に上昇し、動作周波数は数GHz付近に頭打ちとなり、プロセッサはマルチコア並列処理に依存するようになった。現在、先端プロセスは2ナノメートル級まで進んでおり、極端紫外線(EUV)リソグラフィ装置は1台あたり1億ユーロを超える価格となっているが、世代ごとのプロセス進化がもたらす性能向上とコスト優位は縮小している。「ムーアの法則は死んだ」という言説は誇張ではあるが、ある種の焦りを正確に描写している──トランジスタの微細化によって算力を獲得するという旧来の道は、ますます険しくなっている。
小さくできないなら、積み上げる
産業界の対応は、重心を「より小さく」から「より高密度に」へと移すことだった。アドバンストパッケージング、チップレット(chiplet)アーキテクチャ、高帯域幅メモリ積層、バックサイドパワーデリバリー、ゲート・オール・アラウンド(GAA)トランジスタ、そして依然として研究室にある相補型電界効果トランジスタ(CFET)や二次元材料チャネルは、すべて同じ論理の異なる側面である──歩留まりを損なわずに、より小さな体積により多くの演算ユニットを詰め込み、それらの間でデータをより近く、より省電力に転送する。
これもまたファインマン的思考の現代版といえる──素子を小さくするだけでなく、物質の構造を再設計するということだ。平面スケーリングの収益逓減が始まると、計算の進歩は単一のリソグラフィノードではなく、材料・パッケージング・アーキテクチャの協調設計に依存するようになる。
熱力学が設ける上限
しかし物理学の制約は工学の制約よりも厳格だ。ランダウアーの原理(Landauer's principle)は、1ビットの情報を消去するには少なくとも kT·ln2 のエネルギーを散逸しなければならないと指摘している──室温では約3×10⁻²¹ジュールだ。この数値は無視できるほど小さいが、今日のAIクラスターが毎秒エクサフロップス規模の演算を実行するとき、それは理論的な注釈から、エネルギーコスト台帳の実際の項目へと変わる。
より現実的な制約は放熱から来る。チップの電力密度はすでに家庭用コンロの加熱面を超えており、データセンターの電力と冷却需要は、立地・コスト・さらには炭素排出量を左右する決定的要因となっている。ファインマンの当時の警告は今やとりわけ鋭く響く──計算とは抽象的な記号操作ではなく、物理的プロセスであり、必然的にエネルギーと熱に制約される。
別のレースに乗り換える
だからこそ、「非ノイマン型」の経路を探ることが現在最も活発な研究方向となっている。量子計算は重ね合わせとエンタングルメントを利用して、特定の問題においてビット単位演算のエネルギー構造を回避しようとする。光子計算は電子の代わりに光を用いて信号伝送と一部の演算を行い、抵抗発熱を回避する。ニューロモーフィックチップは脳のイベント駆動型メカニズムを模倣し、必要な時だけ電力を消費する。そしてプロセッシング・イン・メモリ(PIM)はメモリアレイ内部に演算を持ち込み、最大のオーバーヘッドであるデータ転送を削減する。
これらのアプローチにはそれぞれ固有の課題がある──量子ビットの誤り訂正のオーバーヘッド、光デバイスの集積密度、新アーキテクチャのソフトウェアエコシステム──これらはおそらく今日のCMOSを置き換えるものではなく、CPUに対するGPUのように、特定のワークロードのアクセラレータとなる可能性が高い。将来の「コンピュータ」はもはや一枚のチップではなく、異なる物理メカニズムを組み合わせたヘテロジニアスシステムかもしれない。
限界は想像力の限界でもある
ファインマンはあの講演の結びで、人類がそれを成し遂げられるかどうかは心配していない、ただ私たちがそれをやろうとするかどうかを心配している、と語った。六十余年後、この言葉は今もなお有効だ──ただ問いの形が変わっている。もはや「小さくできるか」ではなく、「エネルギーと熱の制約の中で、計算をさらに遠くへ推し進め続けられるか」という問いになっている。
その答えはおそらく、ある一度のプロセス技術の突破にあるのではなく、物理学・材料科学・コンピュータアーキテクチャが交差する領域にある。底にはまだ十分な空間がある──ただしその空間は今や、熱力学の物差しで測る必要がある。
本稿はMIT Technology Reviewより編訳
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接