
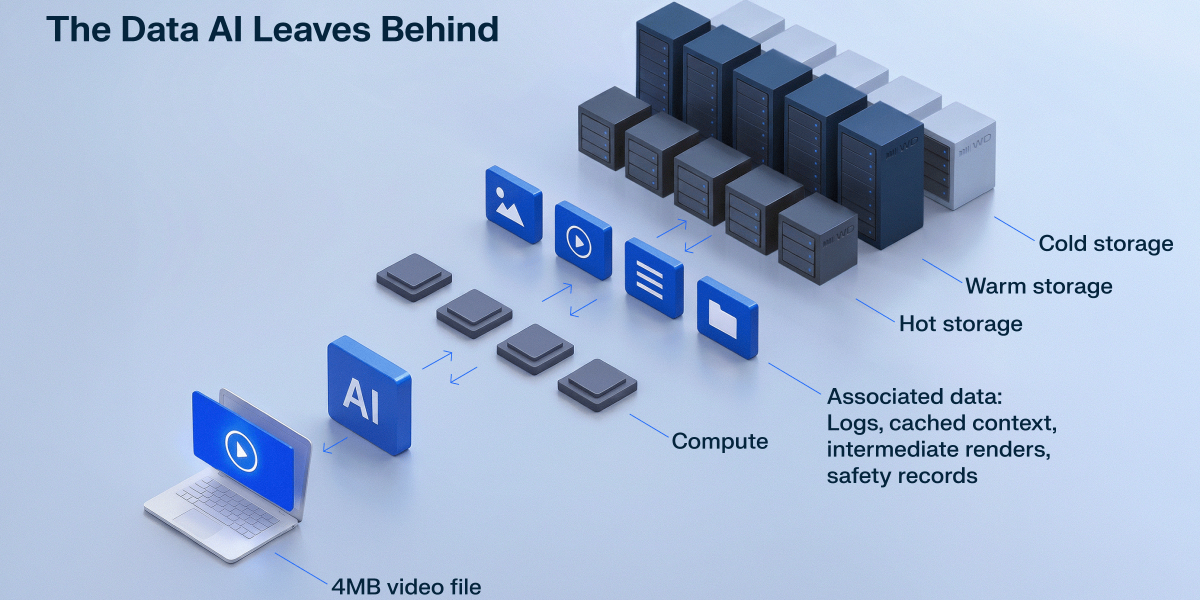
編集者注:AIの予算がGPU、電力、チップ調達に占領されている一方で、推論によって生成されるデータは静かに第二の請求書へと変わりつつある。ストレージコストは一度きりの支出ではなく、呼び出しのたびに積み上がる長期的なコストだ。
MIT Technology Reviewの記事は、多くの経営幹部がAIコストを想像するとき、目に映るのはGPUラック、ギガワット級の電力、チップの調達待ちリストだと指摘する。この光景は間違っていないが、バックエンドに存在するもう一つのコスト曲線、すなわちデータストレージを見落としている。モデルが回答を出した後も、データは消えない。毎日数十億件のプロンプト、生成された画像や動画、そして推論にまつわるログ・キャッシュ・監査記録は、書き込み・保持・インデックス化・検索、さらには長期アーカイブを必要とする。
推論が終わった後、データが始まる
モデルの1回の応答は画面上の答えで完結したように見えるが、バックエンドではシステムが通常、大量のデータを残す。ユーザー入力とモデル出力、コンテキストキャッシュ、呼び出しログ、ベクトル埋め込み、マルチモーダルファイル、コンテンツセーフティ記録、モデルバージョン情報、評価サンプルなどだ。テキストアプリケーションであれば1回のリクエストのデータ量は大きくないかもしれないが、それを1日数十億回の呼び出しで乗じると規模は急膨張する。画像・動画・音声アプリケーションでは、1ファイルが数十MB以上になることもあり、ストレージへの負荷はより顕著だ。
従来のビジネスデータと異なり、AI推論データは生成速度が速く、構造が多様で、ライフサイクルが曖昧という特徴を持つ。多くのチームはサービス開始当初、モデルの精度と応答レイテンシだけに注目し、ストレージの請求額が月を追うごとに増加してから初めて、ログ・コピー・旧バージョンのデータがオブジェクトストレージ、データレイク、ベクトルデータベース、検索システム、バックアップシステムに散在していることに気づく。GPUの請求書は集中していて目に見えやすいが、ストレージの請求書は複数のサービスに断片化して埋もれているため、過小評価されやすい。
なぜストレージ請求書は過小評価されるのか
第一に、AIインフラの議論は長らくトレーニングを中心に展開されてきた。トレーニングは大規模な計算能力と電力を必要とし、コストが明示的だ。一方、推論はユーザー数の増加とともに膨らむもので、ストレージコストは長期的な支出に近く、1回あたりは安く見えても積み重なると無視できなくなる。第二に、ストレージは従量課金・階層型課金であり、ホットストレージ・コールドストレージ・アーカイブストレージでは価格差が大きいが、検索レイテンシ、API呼び出し、データ移行にもコストが発生する。第三に、多くの企業はデータ保持ポリシーが明確でなく、「とりあえず保存しておこう」というデフォルト対応により、重複データ・期限切れログ・誰もアクセスしないデータ資産が長期にわたってストレージを占有し続ける。
「最もコストがかかるのはデータを保存することではなく、なぜ保存するのか、どれくらいの期間保存すべきか、誰が読み取るのかを把握していないことだ。」
ベクトルデータベースはこの問題をさらに拡大する。モデルに検索拡張機能を持たせるために、企業は埋め込みベクトルとインデックス構造を保存する必要があり、一部のインデックスはメモリや高性能ストレージを占有する。マルチモーダルアプリケーションは画像・動画・音声データをもたらし、ファイルサイズが大きく、メタデータが複雑で、サムネイル生成・トランスコードコピー・コンテンツモデレーション記録が必要になることも多い。統一されたガバナンスがなければ、同一コンテンツが複数のシステムで重複保存される可能性がある。
「保存できる」から「上手に保存する」へ
企業はAIストレージをFinOpsおよびデータガバナンスのフレームワークに組み込む必要がある。第一のステップはコスト帰属の明確化だ。チーム・アプリケーション・モデル・テナント別にタグを付け、ホットデータ・ウォームデータ・コールドデータを区別し、コストが高いがアクセスが少ないデータセットを特定する。第二のステップはライフサイクル管理だ。プロンプトログ・出力コンテンツ・ベクトルインデックス・マルチメディア資産に対して差別化された保持ポリシーを設定し、期限切れデータを自動削除し、不要なコピーを削減する。第三のステップは技術的な最適化だ。圧縮・重複排除・ログサンプリング・インデックス削減・階層型ストレージによって単位コストを下げながら、重要なビジネスの検索レイテンシとコンプライアンス要件を確保する。
さらに重要なのは、AIアプリケーションの設計段階でいくつかの問いに答えておくことだ。どのデータを必ず保持すべきか、どのデータはその場で破棄できるか。どのデータは監査目的か、どのデータは製品改善目的か。どのデータはオンライン検索が必要か、どのデータはアーカイブで十分か。ストレージは推論システムの付属品ではなく、AIコスト構造の一部だ。生成AIが実証実験から大規模な運用へと移行するにつれ、隠れていたストレージ請求書は次第に表面化する。観測可能で、階層化でき、ガバナンスの効いたストレージ戦略を事前に構築することは、事後にコスト削減に追われるよりもはるかに効果的だ。
本稿はMIT Technology Reviewより編訳
© 2026 Winzheng.com 赢政天下 | 转载请注明来源并附原文链接